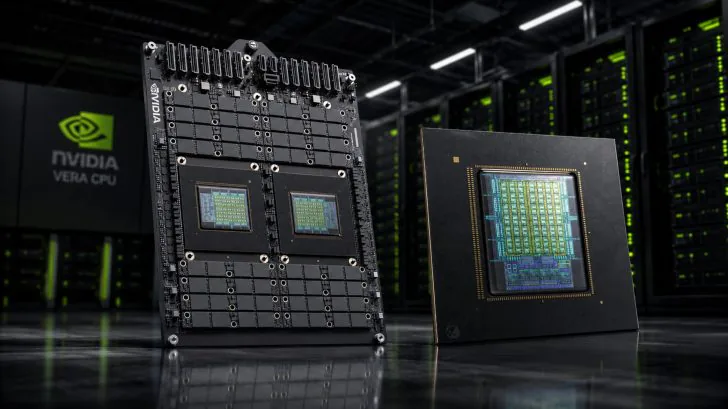
CPU Vera của NVIDIA báo hiệu một sự tái định nghĩa về kiến trúc máy tính, chuyển từ mô hình cô lập tác vụ truyền thống sang một hệ sinh thái trí tuệ nhân tạo Agentic được điều phối chặt chẽ. Sự thay đổi này biến vai trò của CPU từ một bộ vi xử lý đa nhiệm thông thường thành một “nhạc trưởng” chuyên biệt, được thiết kế riêng để quản lý các vòng lặp suy luận đa bước, phức tạp của các AI agent.
Mới đây, trang tin Wccftech đã có cơ hội ngồi lại cùng nhóm phát triển Vera của NVIDIA trong một buổi trò chuyện chuyên sâu về vai trò mới nổi của CPU trong nền kinh tế Agentic AI đang phát triển bùng nổ. Dưới đây là những nội dung thảo luận chi tiết về sự hồi sinh của hiệu năng đơn nhân, quy mô khổng lồ của các hệ thống AI sandbox do CPU kiểm soát, và sự dịch chuyển của tỷ lệ giữa CPU và GPU.
SAU NHIỀU NĂM HẠ TẦNG CLOUD ƯU TIÊN SỐ LƯỢNG NHÂN VÀ HY SINH TỐC ĐỘ ĐƠN NHÂN, AGENTIC AI ĐANG BUỘC NGÀNH CÔNG NGHIỆP ĐẢO CHIỀU, VÀ NVIDIA VERA CHÍNH LÀ MINH CHỨNG
Hỏi: Bạn có thể đưa ra một cái nhìn tổng quan ngắn gọn về CPU Vera là gì không?
Đáp: Vào đầu những năm 2010, thiết kế trung tâm dữ liệu tập trung vào việc tối đa hóa hiệu năng của từng nhân vi xử lý riêng lẻ thay vì chạy đua về số lượng nhân. Trong giai đoạn này, các ông lớn như Intel tập trung vào những kiến trúc sở hữu ít nhân hơn nhưng chạy ở mức xung nhịp cao hơn. Kỷ nguyên này mang đặc trưng là hiệu năng đơn nhân cao nhưng tổng thông lượng thấp.
Tuy nhiên, khi các nền tảng cloud ngày càng bành trướng, ngành công nghiệp bắt đầu xoay trục sang bài toán kinh tế quy mô. Nhu cầu chuyển sang việc nhồi nhét càng nhiều nhân vào một máy chủ càng tốt để tối đa hóa lợi nhuận. Để đạt được mật độ này và kiểm soát chi phí, các nhà cung cấp x86 đã từ bỏ thiết kế nguyên khối để chuyển sang bố cục đa chiplet. Nhưng sự mở rộng ồ ạt về số lượng nhân này đã phải đánh đổi trực tiếp bằng khả năng tối ưu hóa đơn nhân và chỉ số IPC. Đó là lúc thị trường ngập tràn các dòng chip mang lại thông lượng khổng lồ nhưng hiệu năng đơn nhân lại rất thấp.
Sự trỗi dậy của Agentic AI đã đưa CPU trở lại vị trí trung tâm của lộ trình thiết kế. Các AI agent hoạt động trong một vòng lặp liên tục, chớp nhoáng giữa GPU và CPU. Vì GPU là tài sản đắt đỏ và giá trị nhất trong một nhà máy AI, CPU phải hoàn thành các tác vụ tuần tự của mình ngay lập tức để tránh tình trạng GPU bị bỏ không chờ đợi. Mô hình này đòi hỏi một sự kết hợp chưa từng có giữa tốc độ, khả năng truy xuất bộ nhớ và độ trễ tối thiểu.
CPU Vera của NVIDIA giải quyết nút thắt cổ chai của Agentic bằng cách phá vỡ sự đánh đổi lịch sử của kỷ nguyên cloud. Hãng định vị bản thân ở góc độ khó nhằn nhất: hiệu năng đơn nhân cao kết hợp cùng thông lượng lớn. Vera đạt được điều này thông qua ba thiết kế cốt lõi: tốc độ đơn nhân cực cao, hệ thống bộ nhớ LPDDR5X tùy chỉnh cho băng thông khổng lồ, và một đế silicon tính toán nguyên khối (monolithic compute die) duy nhất được tiếp sức bởi công nghệ Scalable Coherent Fabric thế hệ thứ hai nhằm triệt tiêu hoàn toàn độ trễ. Nhờ đó, tất cả các nhân trên đế tính toán nguyên khối có thể giao tiếp với nhau mà không phải vượt qua bất kỳ rào cản I/O nào.
SỰ PHÂN TÁCH TRONG CHỨC NĂNG CPU VÀ BÀI TOÁN HIỆU NĂNG TỪ SPATIAL MULTITHREADING
Hỏi: Với việc SK Hynix công bố HTPU – nơi có khoảng 100 bộ vi xử lý nhỏ xíu bên trong một ổ SSD đảm nhận các tác vụ cấp thấp lặp đi lặp lại, nhường lại cho vi xử lý chính tập trung vào các tác vụ cấp cao – liệu NVIDIA có đang quan tâm hay theo đuổi một sự phân tách tương tự trong các chức năng của CPU?
Đáp: Bức tranh cơ sở hạ tầng AI đang dịch chuyển khỏi các cụm máy chủ đồng nhất để hướng tới các thiết lập chuyên biệt hóa và không đồng nhất. Một ví dụ điển hình là trong các khối lượng công việc suy luận AI hiện đại, các giai đoạn xử lý riêng biệt từ việc đọc dữ liệu ban đầu (pre-fill) cho đến việc tạo ra các token tuần tự (decode) hiện đã được chia tách sang các cụm phần cứng hoàn toàn khác nhau để tối ưu hóa hiệu quả.

Chiến lược CPU ban đầu của NVIDIA với vi xử lý Grace tập trung vào việc tạo ra một host node tối thượng – một bộ vi xử lý được thiết kế hoàn toàn để đẩy dữ liệu cho một cụm GPU trong tủ rack máy chủ. Tuy nhiên, những đòi hỏi đặc thù của các luồng công việc Agentic và reinforcement learning đã buộc hãng phải xoay trục, đặc biệt là khi NVIDIA nhận ra rằng thị trường đang rất cần các tủ rack thuần CPU để xử lý các lệnh gọi công cụ của agent.
Bởi vì bước ngoặt này, CPU Vera không còn bị xem đơn thuần là một thành phần tích hợp bị mắc kẹt bên trong một kiến trúc kết hợp (như hệ thống Vera-Rubin). Thay vào đó, Vera đang được thương mại hóa như một tài sản CPU độc lập riêng biệt, chuyên xử lý những khối lượng dữ liệu khổng lồ từ các agent tool calls và các vòng lặp suy luận.
Hỏi: NVIDIA đề cập rằng Vera có IPC cao hơn khoảng 50% so với Grace. Và CPU này cũng có độ rộng giải mã 10-wide. Nếu xảy ra lỗi dự đoán, độ trễ sẽ như thế nào? Cần bao nhiêu chu kỳ để Vera phục hồi so với Grace?
Đáp: CPU Vera đạt được một bước nhảy vọt khổng lồ về sức mạnh xử lý, mang lại hiệu năng nhanh hơn 1.5 lần so với người tiền nhiệm Grace. Khi được đo lường với các bộ vi xử lý x86 hàng đầu hiện nay, đặc biệt là trên các tác vụ Agentic vốn phụ thuộc nhiều vào khả năng xử lý tuần tự, Vera có thể hoạt động nhanh gấp 2 lần.
Thay vì dựa vào các phương pháp Simultaneous Multithreading truyền thống, NVIDIA đã triển khai một công nghệ nội bộ có tên gọi Spatial Multithreading. Tính năng độc quyền này cho phép con chip cấp phát cố định các luồng worker và luồng I/O chuyên dụng. Sự phân chia này đảm bảo rằng ngay cả dưới khối lượng tính toán cực nặng, một nhân cũng sẽ không bao giờ bị tước đoạt chu kỳ xử lý của luồng worker để nhường cho I/O hoặc các nhân khác.
Để giải quyết những lo ngại về việc liệu cơ chế lập lịch luồng phức tạp này có gây ra độ trễ kiến trúc hay suy giảm hiệu năng hay không, trang phần cứng Phoronix đã thực hiện các bài đánh giá độc lập và xác nhận rằng SMT của NVIDIA trên Vera thực sự mang lại mức tăng hiệu năng lên tới khoảng 20%, hoàn toàn không có sự đánh đổi nào.
GÓC NHÌN CỦA NVIDIA VỀ TỶ LỆ CPU VÀ GPU TRONG TƯƠNG LAI
Hỏi: Khi Meta ra mắt agent Muse, một số thông tin cho thấy tỷ lệ CPU và GPU trong môi trường AI cuối cùng có thể đạt mức 80:1. Điều này có thực tế không, và nó tác động thế nào đến nhu cầu đối với Vera?
Đáp: Dù NVIDIA không chính thức dự báo tỷ lệ 80:1, nhưng số lượng các lệnh gọi công cụ agent trong ngành hiện đang rất khổng lồ, với một số nhà cung cấp dịch vụ sandbox phải duy trì tới 400.000 sandbox cho chỉ một khách hàng duy nhất. Cơ sở hạ tầng đang dịch chuyển mạnh mẽ về phía CPU để hỗ trợ hàng nghìn tỷ sandbox đang thực thi. Đây chính là động lực thúc đẩy NVIDIA đẩy mạnh các hệ thống rack trang bị thuần CPU Vera độc lập để phục vụ cho các khối lượng công việc Agentic và reinforcement learning.
THIẾT KẾ ĐẾ NGUYÊN KHỐI MONOLITHIC CỦA NVIDIA VERA
Hỏi: Tại sao NVIDIA chọn thiết kế đế nguyên khối cho Vera thay vì kiến trúc chiplet mà các đối thủ đang sử dụng?
Đáp: Khác với các nhà sản xuất x86 truyền thống buộc phải thiết kế những kiến trúc phức tạp để phục vụ cả người dùng phổ thông lẫn trung tâm dữ liệu cao cấp, NVIDIA bước vào không gian CPU mà hoàn toàn không bị vướng bận bởi các phân khúc tệp khách hàng trong quá khứ. Vị thế độc đáo này cho phép họ có được sự xa xỉ khi thiết kế Vera dành riêng cho một mục tiêu duy nhất là thị trường trung tâm dữ liệu.
Để đáp ứng các vòng lặp truy xuất bộ nhớ dồn dập của AI agent, NVIDIA đã chủ động gạt bỏ xu hướng multi-chiplet để chọn thiết kế đế nguyên khối monolithic. Bằng cách giữ tất cả các nhân trên một mảnh silicon liền mạch duy nhất, NVIDIA đã triệt tiêu hoàn toàn sự sụt giảm hiệu năng nội bộ xảy ra khi dữ liệu buộc phải giao tiếp chéo qua lại giữa ranh giới của các chiplet riêng biệt.
Thiết kế nguyên khối này chuyển hóa thành một lợi thế hiệu năng khổng lồ cho việc xử lý điện toán cộng tác. CPU Vera đạt được băng thông phân đôi chưa từng có lên tới 3.4 terabyte/giây, cho phép các nhân vi xử lý cộng tác và chia sẻ thông tin ngữ cảnh nhanh hơn 3 lần so với các chip x86 hàng đầu. Mặc dù cách tiếp cận nguyên khối là điều bắt buộc để đạt được các mục tiêu hiệu năng đặc thù của Vera, NVIDIA vẫn duy trì một lập trường thực tế và hoàn toàn có thể xoay trục sang các thiết kế chiplet nếu thị trường trong tương lai đòi hỏi.
Nguồn: wccftech