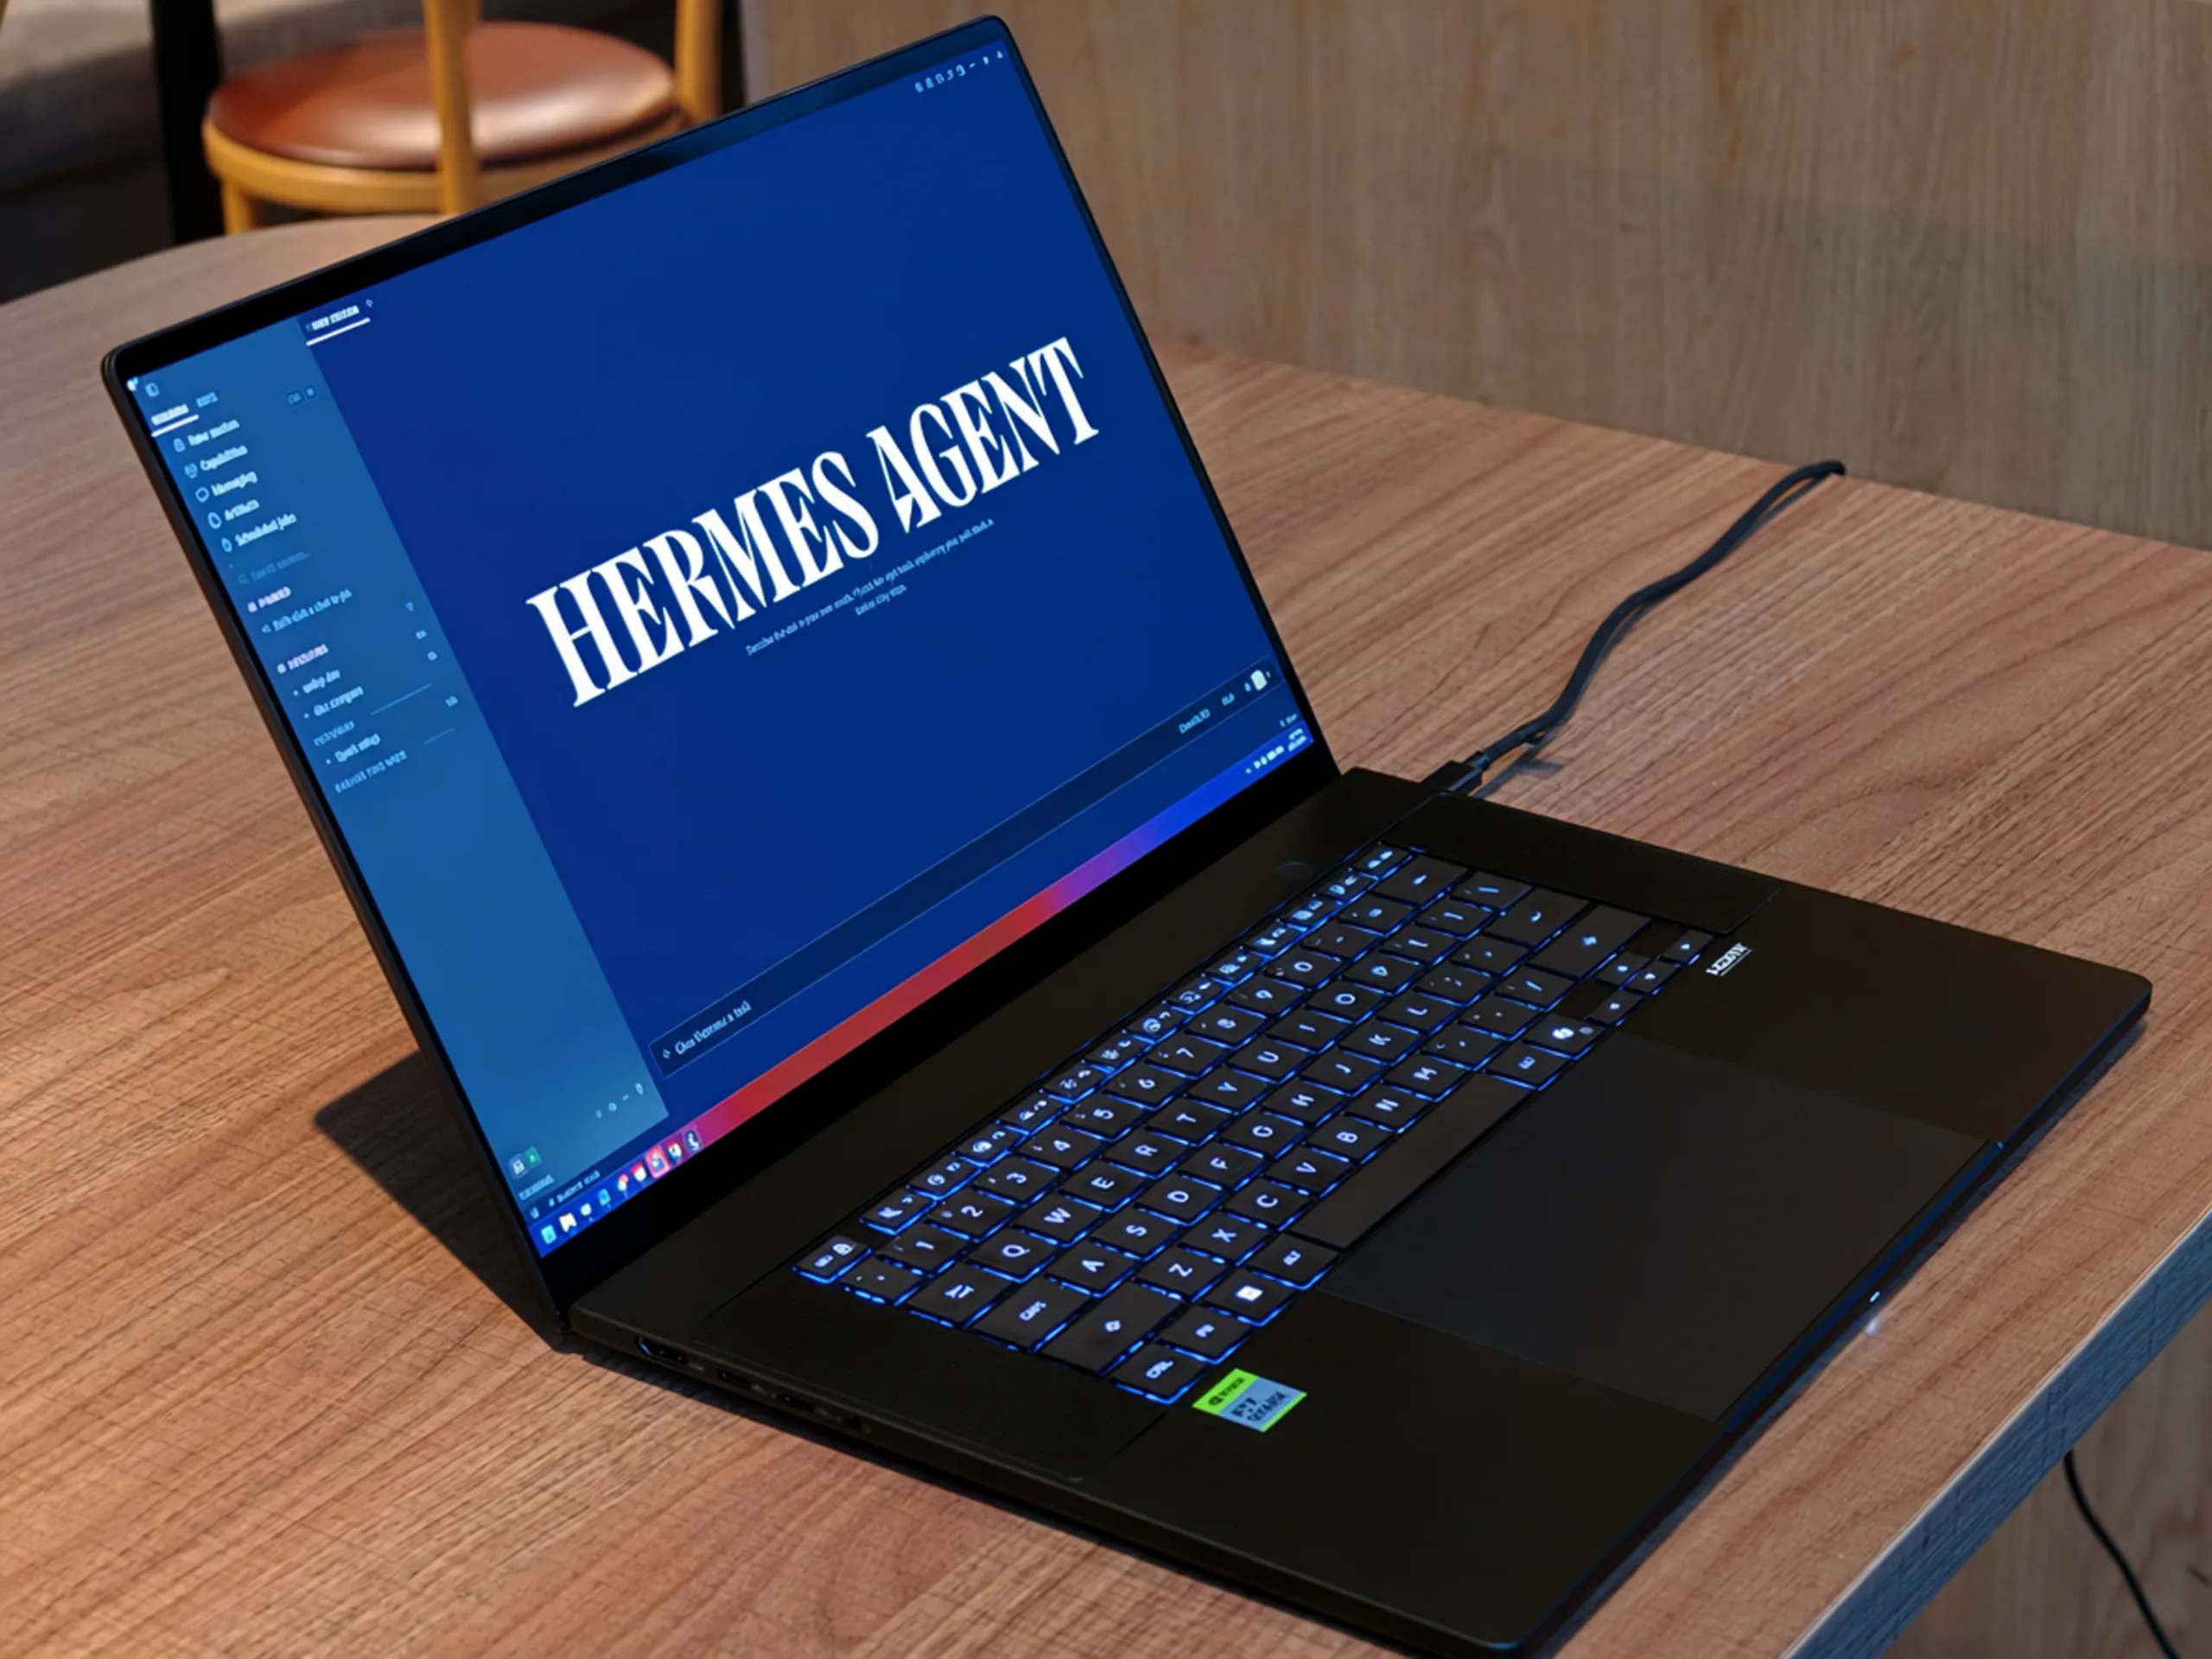
NVIDIA RTX Spark N1X mang đến khả năng chạy mô hình AI hàng chục tỉ tham số ngay trên laptop. Những thử nghiệm thực tế cho thấy tiềm năng của nền tảng này trong xử lý AI, lập trình và đồ họa, đồng thời đặt ra những yêu cầu mới về khả năng tản nhiệt.
Trong vài năm trở lại đây, trí tuệ nhân tạo (AI) gần như trở thành một tính năng không thể thiếu trong các buổi giới thiệu laptop. Từ xử lý hình ảnh, cải thiện âm thanh cho đến trợ lý thông minh, các nhà sản xuất đều tìm cách đưa AI đến gần hơn với người dùng.
Tuy nhiên, phần lớn những dịch vụ AI quen thuộc vẫn hoạt động dựa trên điện toán đám mây. Người dùng gửi yêu cầu đến máy chủ, chờ hệ thống xử lý rồi nhận kết quả. Cách làm này đơn giản và thuận tiện, nhưng cũng đồng nghĩa với việc người dùng phụ thuộc vào kết nối internet, chính sách dịch vụ và hạ tầng của nhà cung cấp.
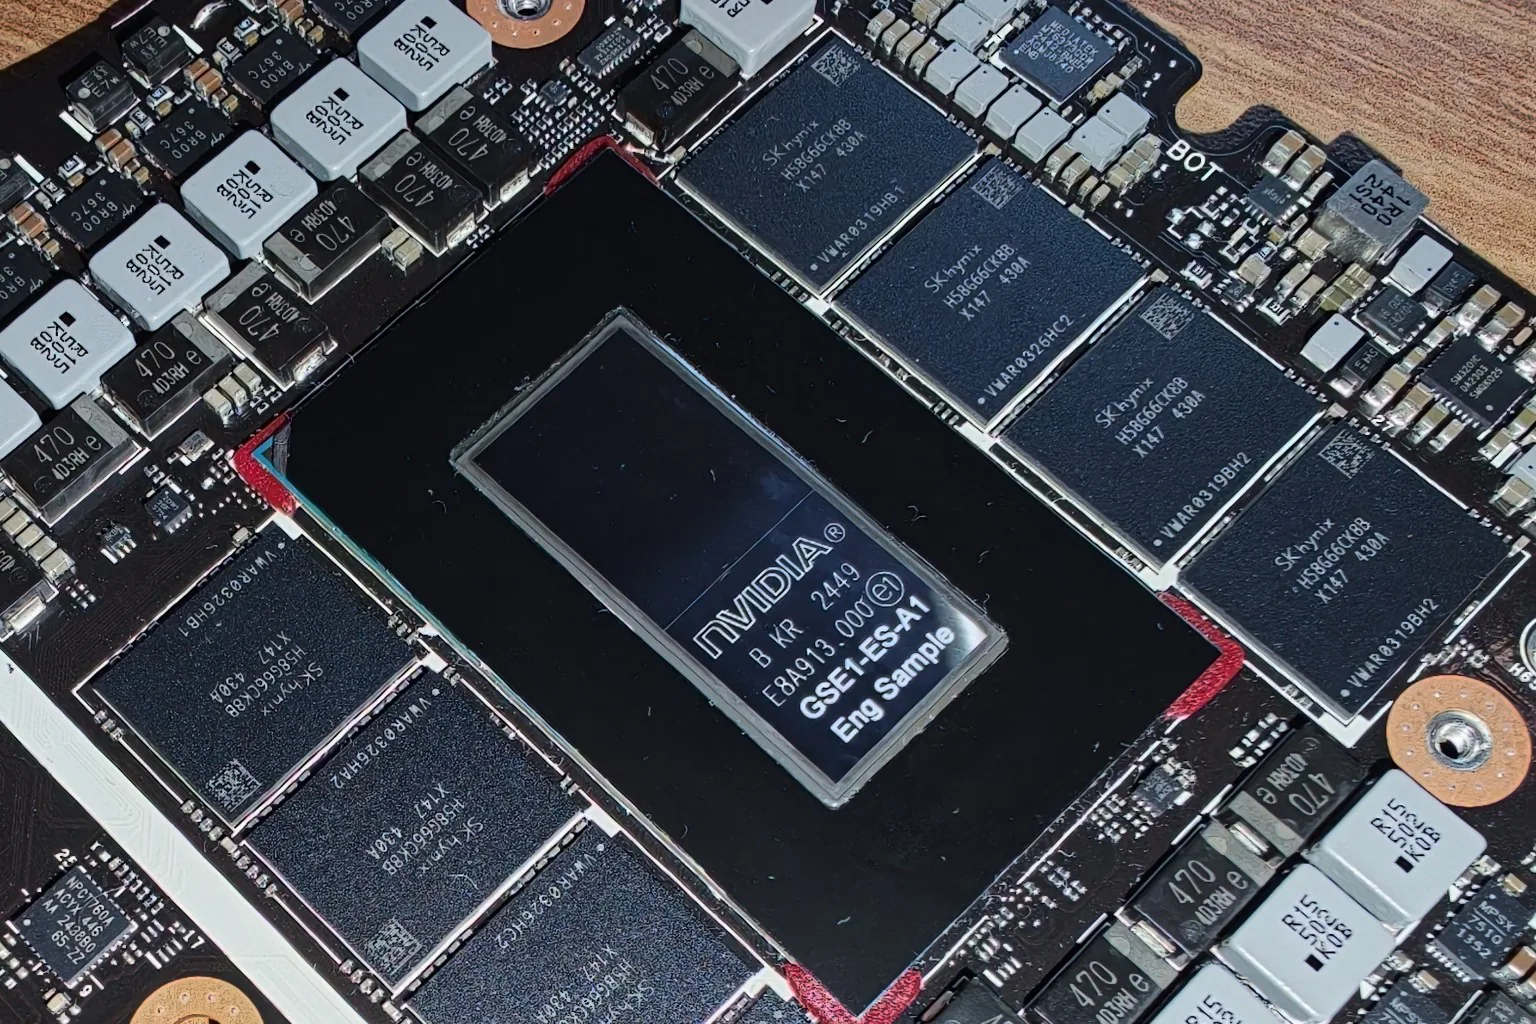
AI cục bộ (local AI) lại đi theo hướng khác. Thay vì gửi dữ liệu đến máy chủ bên ngoài, toàn bộ quá trình xử lý có thể được thực hiện trực tiếp trên thiết bị. Người dùng chủ động lựa chọn mô hình, cấu hình phần mềm và xây dựng những quy trình làm việc phù hợp với nhu cầu riêng.
Đổi lại, yêu cầu phần cứng cũng cao hơn đáng kể. Những mô hình ngôn ngữ có hàng chục tỉ tham số thường cần dung lượng bộ nhớ lớn, trong khi GPU trên laptop lại bị giới hạn bởi lượng VRAM được trang bị. Đây chính là lý do tôi đặc biệt quan tâm đến NVIDIA RTX Spark N1X, nền tảng kết hợp CPU, GPU Blackwell và bộ nhớ hợp nhất nhằm phục vụ những tác vụ AI ngay trên laptop.
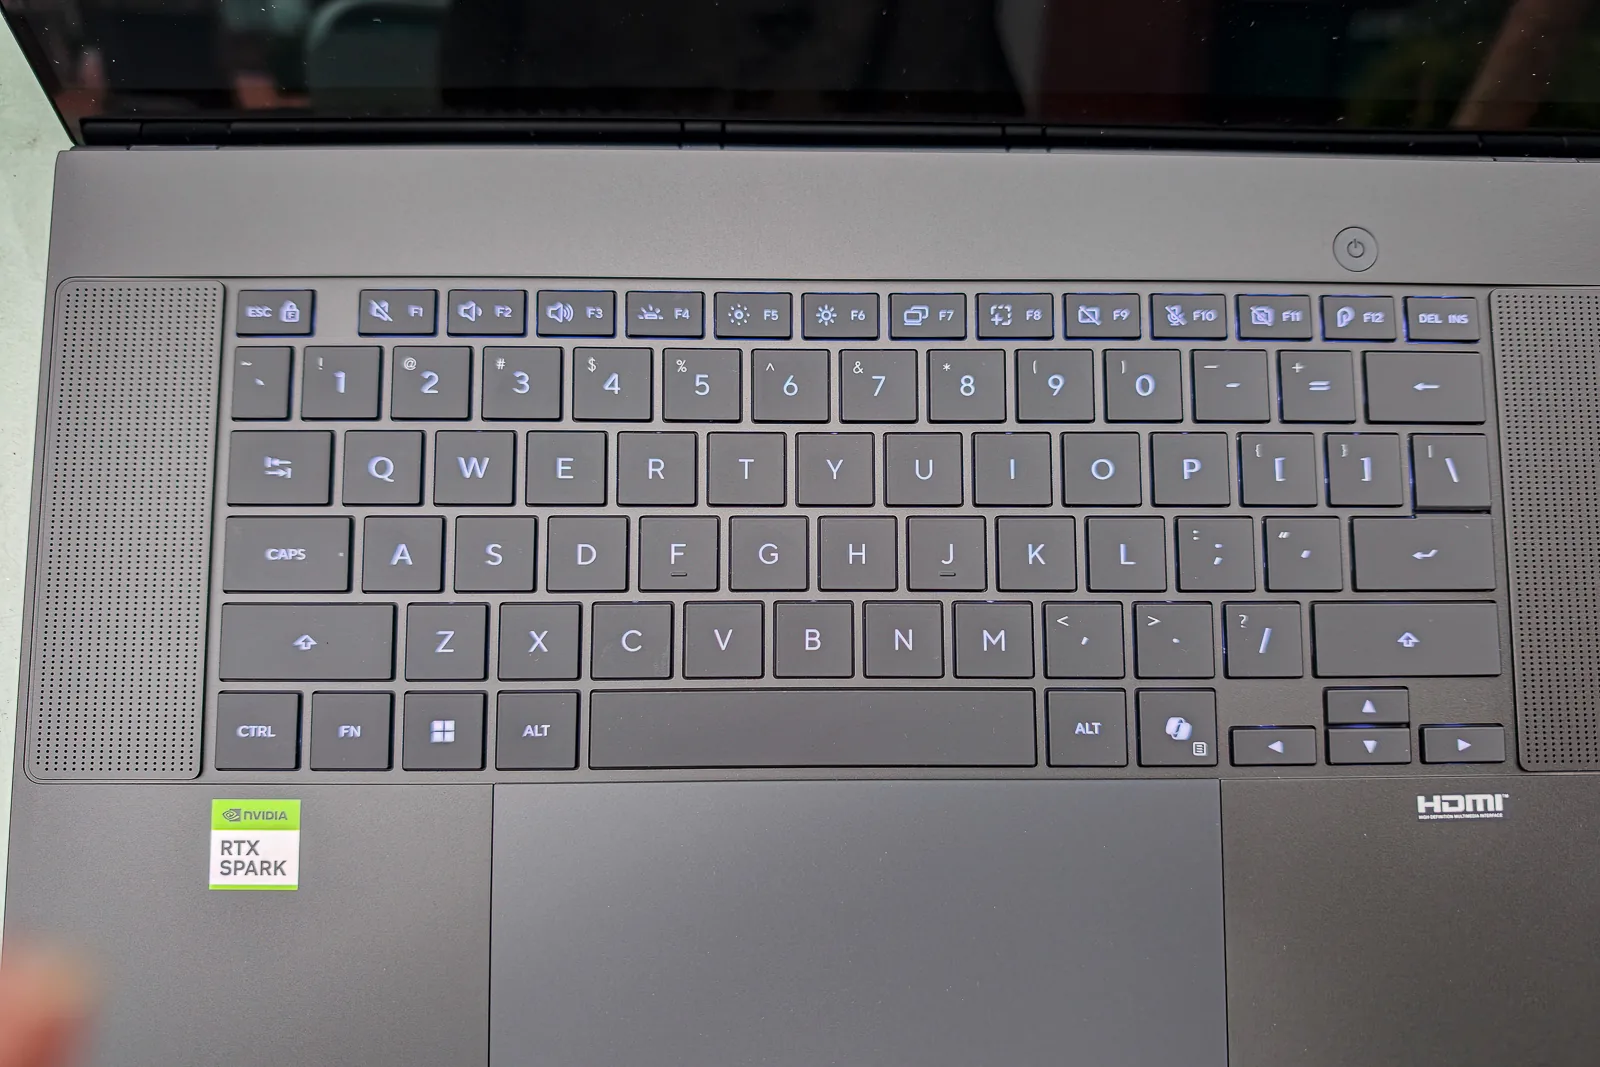
Trong lần trải nghiệm này, tôi sử dụng một chiếc ASUS ProArt 16 trang bị RTX Spark N1X để thử nghiệm khả năng chạy mô hình ngôn ngữ lớn, tạo hình ảnh bằng AI và đặc biệt là để AI tự xây dựng một phần mềm Windows. Sau đó, tôi tiếp tục kiểm tra hiệu năng đồ họa bằng 3DMark và Cyberpunk 2077.
| Thành phần | Thông số |
|---|---|
| Thiết bị thử nghiệm | ASUS ProArt P16 |
| Nền tảng | NVIDIA RTX Spark N1X |
| CPU | 20 nhân ARM, gồm 10 nhân Cortex-X925 và 10 nhân Cortex-A725 |
| GPU | NVIDIA Blackwell |
| Nhân CUDA | 6.144 |
| RAM | 64 GB LPDDR5X |
| Kiến trúc bộ nhớ | Bộ nhớ hợp nhất, dùng chung cho CPU và GPU |
| Băng thông bộ nhớ | Tối đa 300 GB/giây |
| Dung lượng RAM nền tảng hỗ trợ | Tối đa 128 GB |
| Bộ nhớ phân bổ cho GPU | 48 GB, cấu hình qua NVIDIA App |
| Hệ điều hành | Windows 11 ARM64 |
| Trình điều khiển GPU | NVIDIA 617.42 |
RTX Spark N1X và lợi thế từ bộ nhớ hợp nhất
NVIDIA RTX Spark N1X sử dụng bộ xử lý 20 nhân, gồm 10 nhân Cortex-X925 và 10 nhân Cortex-A725. Đi kèm là GPU dựa trên kiến trúc NVIDIA Blackwell với 6.144 nhân CUDA. Nếu chỉ nhìn vào số nhân xử lý, đây đã là một cấu hình đáng chú ý. Tuy nhiên, điều khiến RTX Spark khác biệt so với nhiều laptop thông thường lại nằm ở cách tổ chức bộ nhớ.
Trên những hệ thống sử dụng card đồ họa rời, CPU và GPU thường có hai vùng bộ nhớ riêng biệt. CPU sử dụng RAM hệ thống, còn GPU có VRAM với dung lượng cố định. Cách tổ chức này phù hợp với nhiều tác vụ đồ họa truyền thống, nhưng có thể trở thành trở ngại khi chạy những mô hình AI lớn.
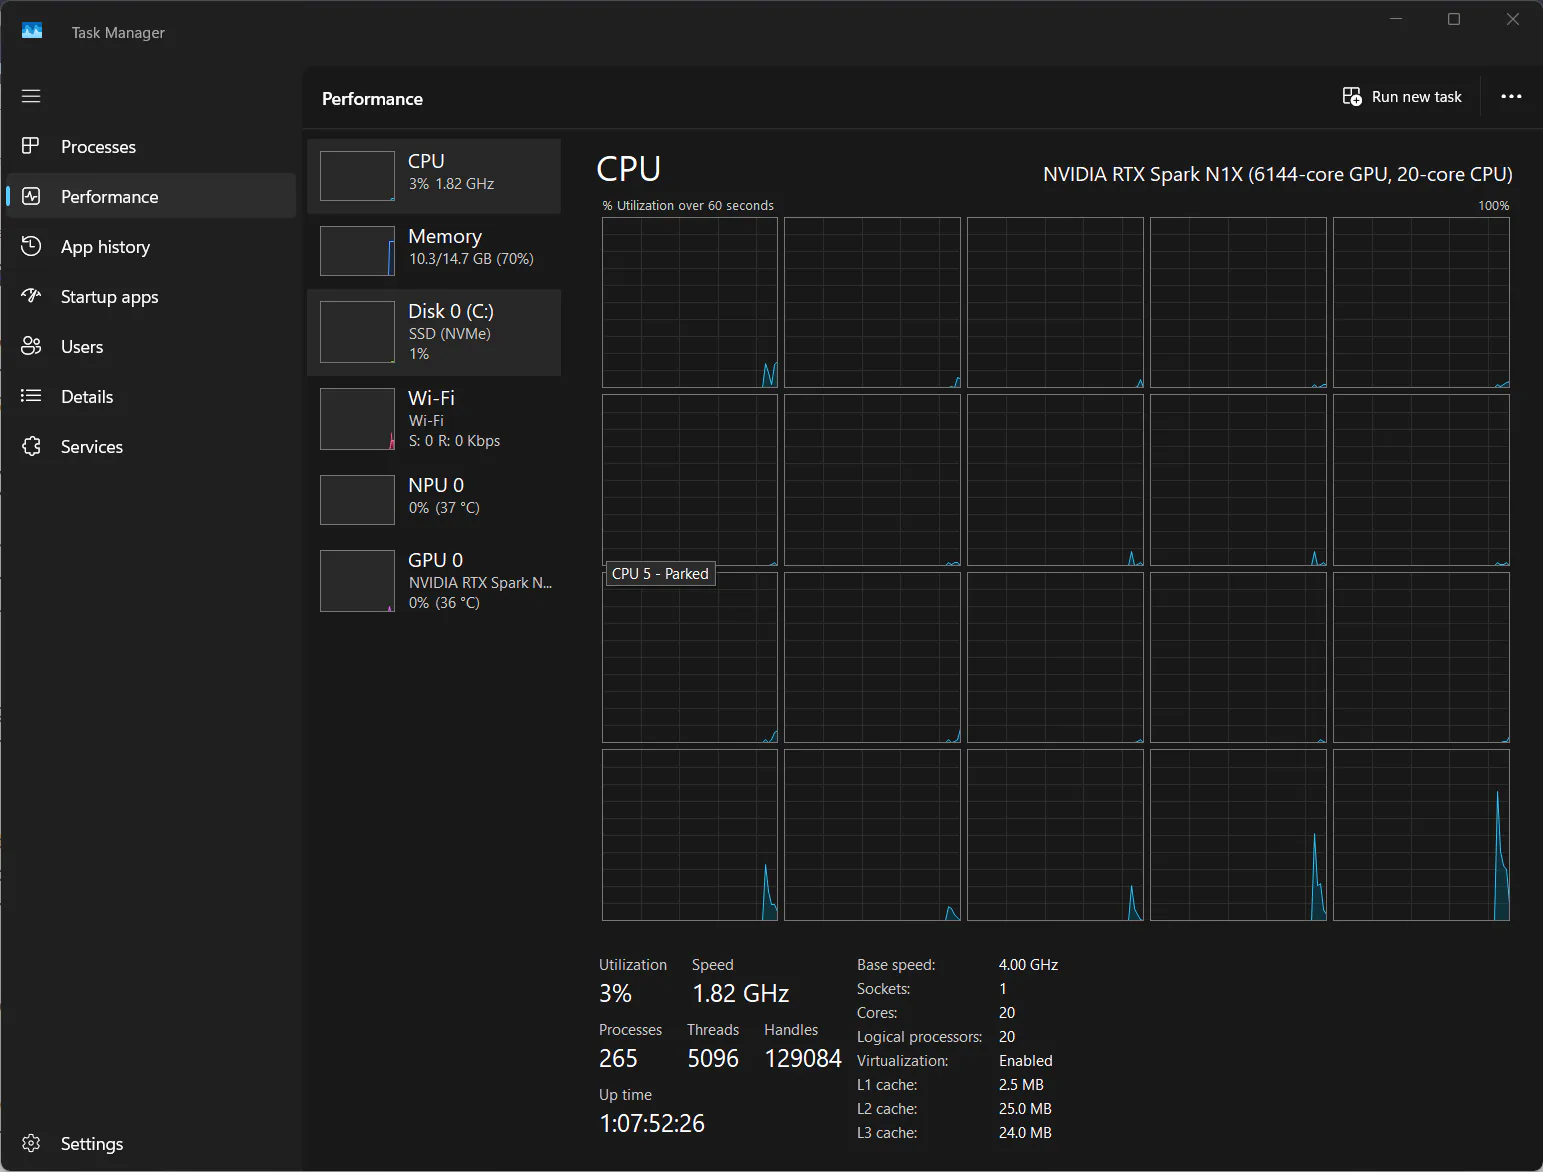
Chẳng hạn, một mô hình ngôn ngữ có thể cần hàng chục GB bộ nhớ để lưu trữ dữ liệu trong quá trình suy luận. Nếu VRAM không đủ, người dùng phải giảm kích thước mô hình, sử dụng phương pháp lượng tử hóa hoặc chuyển một phần dữ liệu sang RAM hệ thống, vốn có thể làm giảm tốc độ xử lý.
RTX Spark sử dụng bộ nhớ LPDDR5X dùng chung cho CPU và GPU, với băng thông tối đa 300 GB/giây. Nền tảng hỗ trợ dung lượng lên đến 128 GB, trong khi chiếc ASUS ProArt tôi thử nghiệm được trang bị 64 GB RAM. Nhờ sử dụng chung bộ nhớ, hệ thống có thể phân bổ một lượng lớn dung lượng cho những tác vụ cần GPU. Trong NVIDIA App, thiết bị thử nghiệm cho phép thiết lập mức phân bổ khoảng 48 GB dành cho GPU.
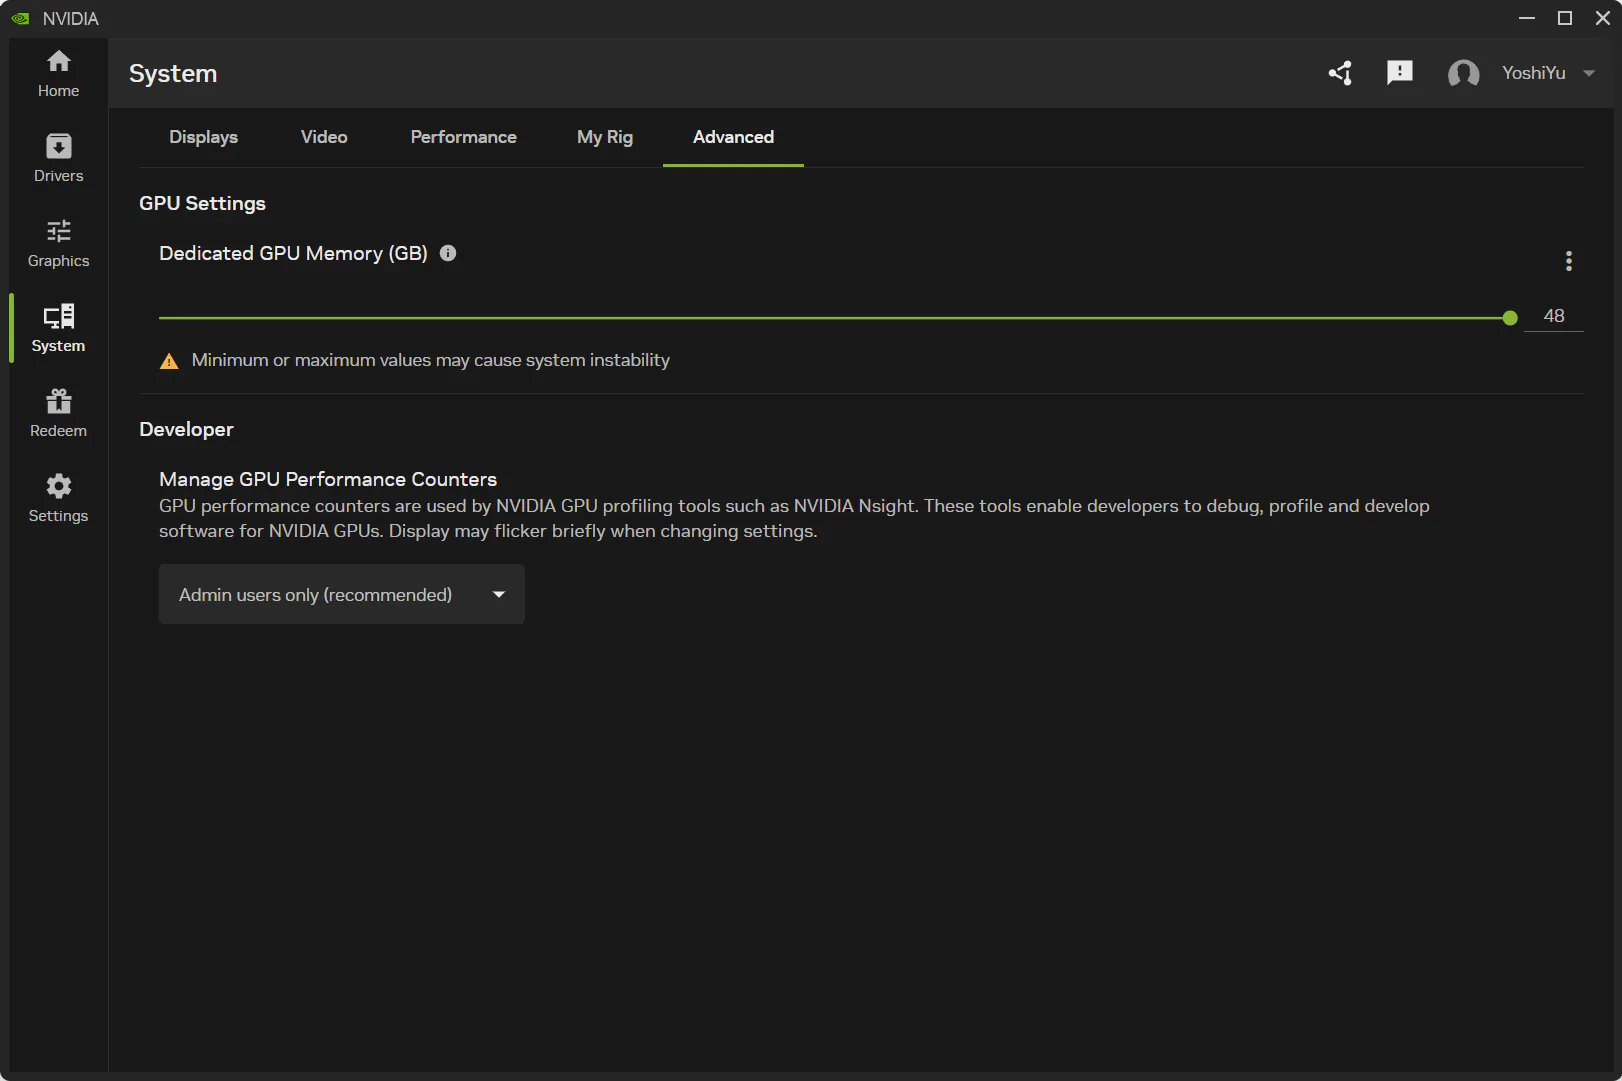
Dù không thể xem vùng bộ nhớ này tương đương hoàn toàn với VRAM trên card đồ họa rời, đây vẫn là lợi thế đáng kể khi vận hành những mô hình AI có dung lượng lớn. Điều đó cũng khiến cách đánh giá RTX Spark trở nên khác biệt. Thay vì chỉ quan tâm CPU mạnh đến đâu hoặc GPU chơi game được bao nhiêu FPS, người dùng có thêm một yếu tố cần cân nhắc: hệ thống có đủ bộ nhớ để vận hành mô hình AI mình cần hay không?
Một đặc điểm khác là RTX Spark N1X sử dụng Windows 11 ARM64. Đây là môi trường có những khác biệt so với Windows trên nền tảng x86 truyền thống, đặc biệt khi làm việc với phần mềm chuyên dụng và các thư viện AI. Trong quá trình thử nghiệm, tôi nhận thấy việc lựa chọn đúng phiên bản phần mềm và phương thức tăng tốc GPU có ảnh hưởng đáng kể đến trải nghiệm. Với AI cục bộ, sở hữu phần cứng mạnh mới chỉ là một phần của câu chuyện.
Thử sức với mô hình AI 27 tỉ tham số
Để đánh giá khả năng xử lý mô hình ngôn ngữ lớn, tôi sử dụng Qwen3.8 27B, một mô hình AI có 27 tỉ tham số. Mô hình được lượng tử hóa theo định dạng Q4_K_M nhằm giảm dung lượng bộ nhớ cần thiết. Đây là phương pháp thường được sử dụng khi triển khai AI cục bộ, giúp những mô hình lớn có thể vận hành trên phần cứng phổ thông hơn.
Thay vì chỉ đặt vài câu hỏi và quan sát tốc độ trả lời, tôi sử dụng AgentPerf Local để đánh giá khả năng xử lý của hệ thống trong một chuỗi công việc dài. Bài thử bao gồm 8 tác vụ với tổng cộng 168 lượt xử lý, sử dụng cửa sổ ngữ cảnh 65.536 token. Khối lượng này phù hợp hơn với cách một AI agent hoạt động, khi mô hình phải liên tục tiếp nhận thông tin và thực hiện nhiều bước để hoàn thành nhiệm vụ.
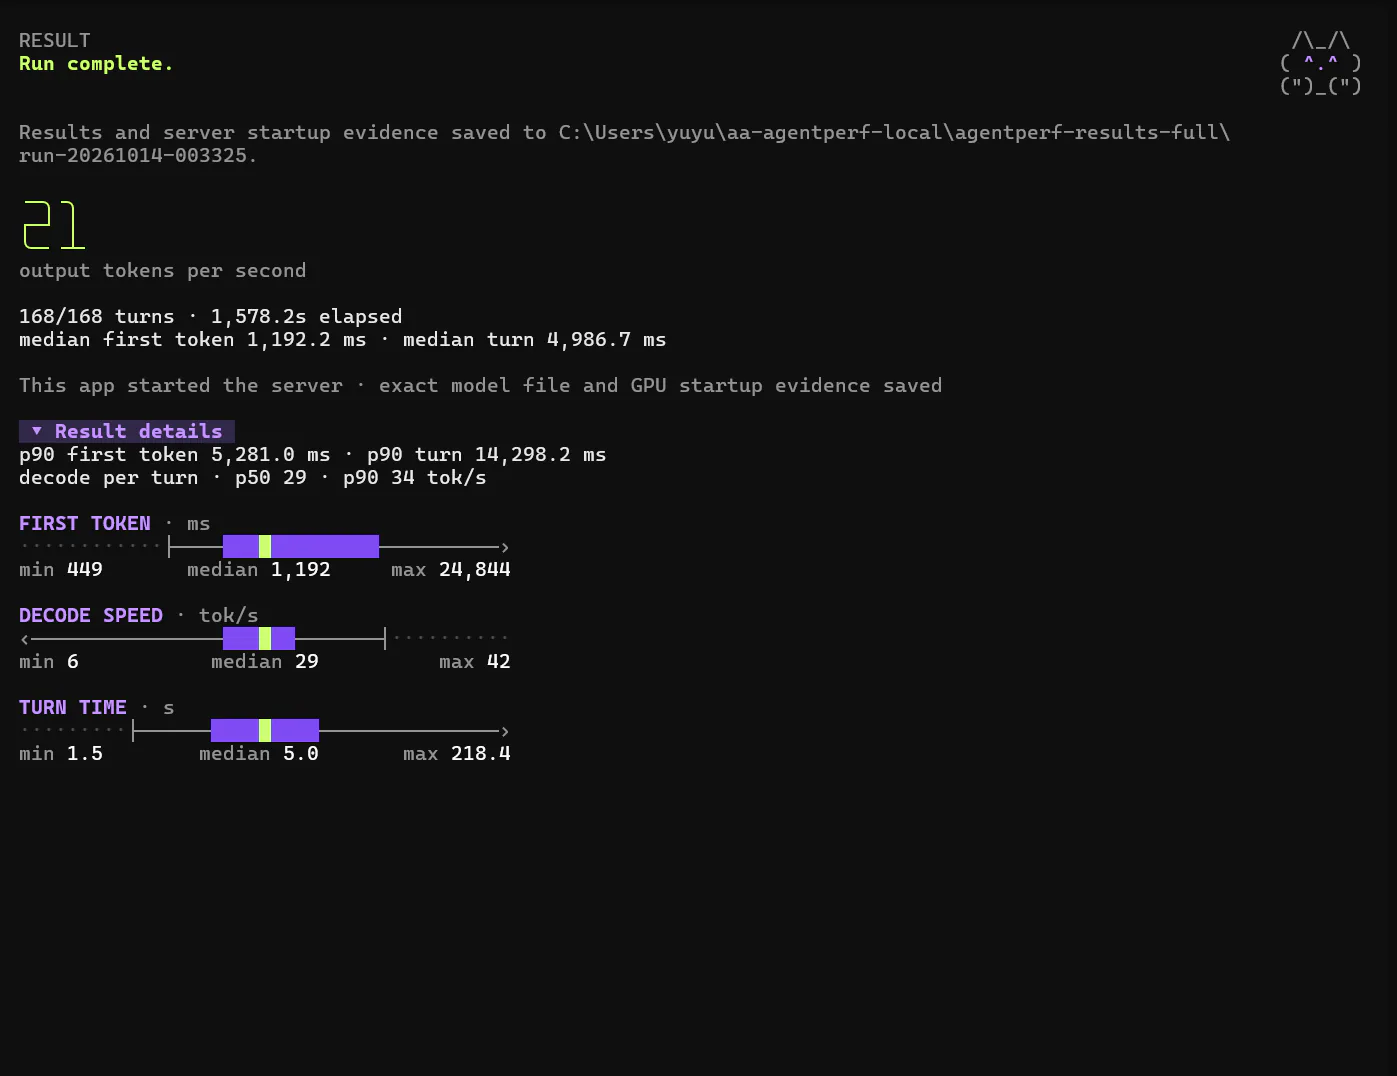
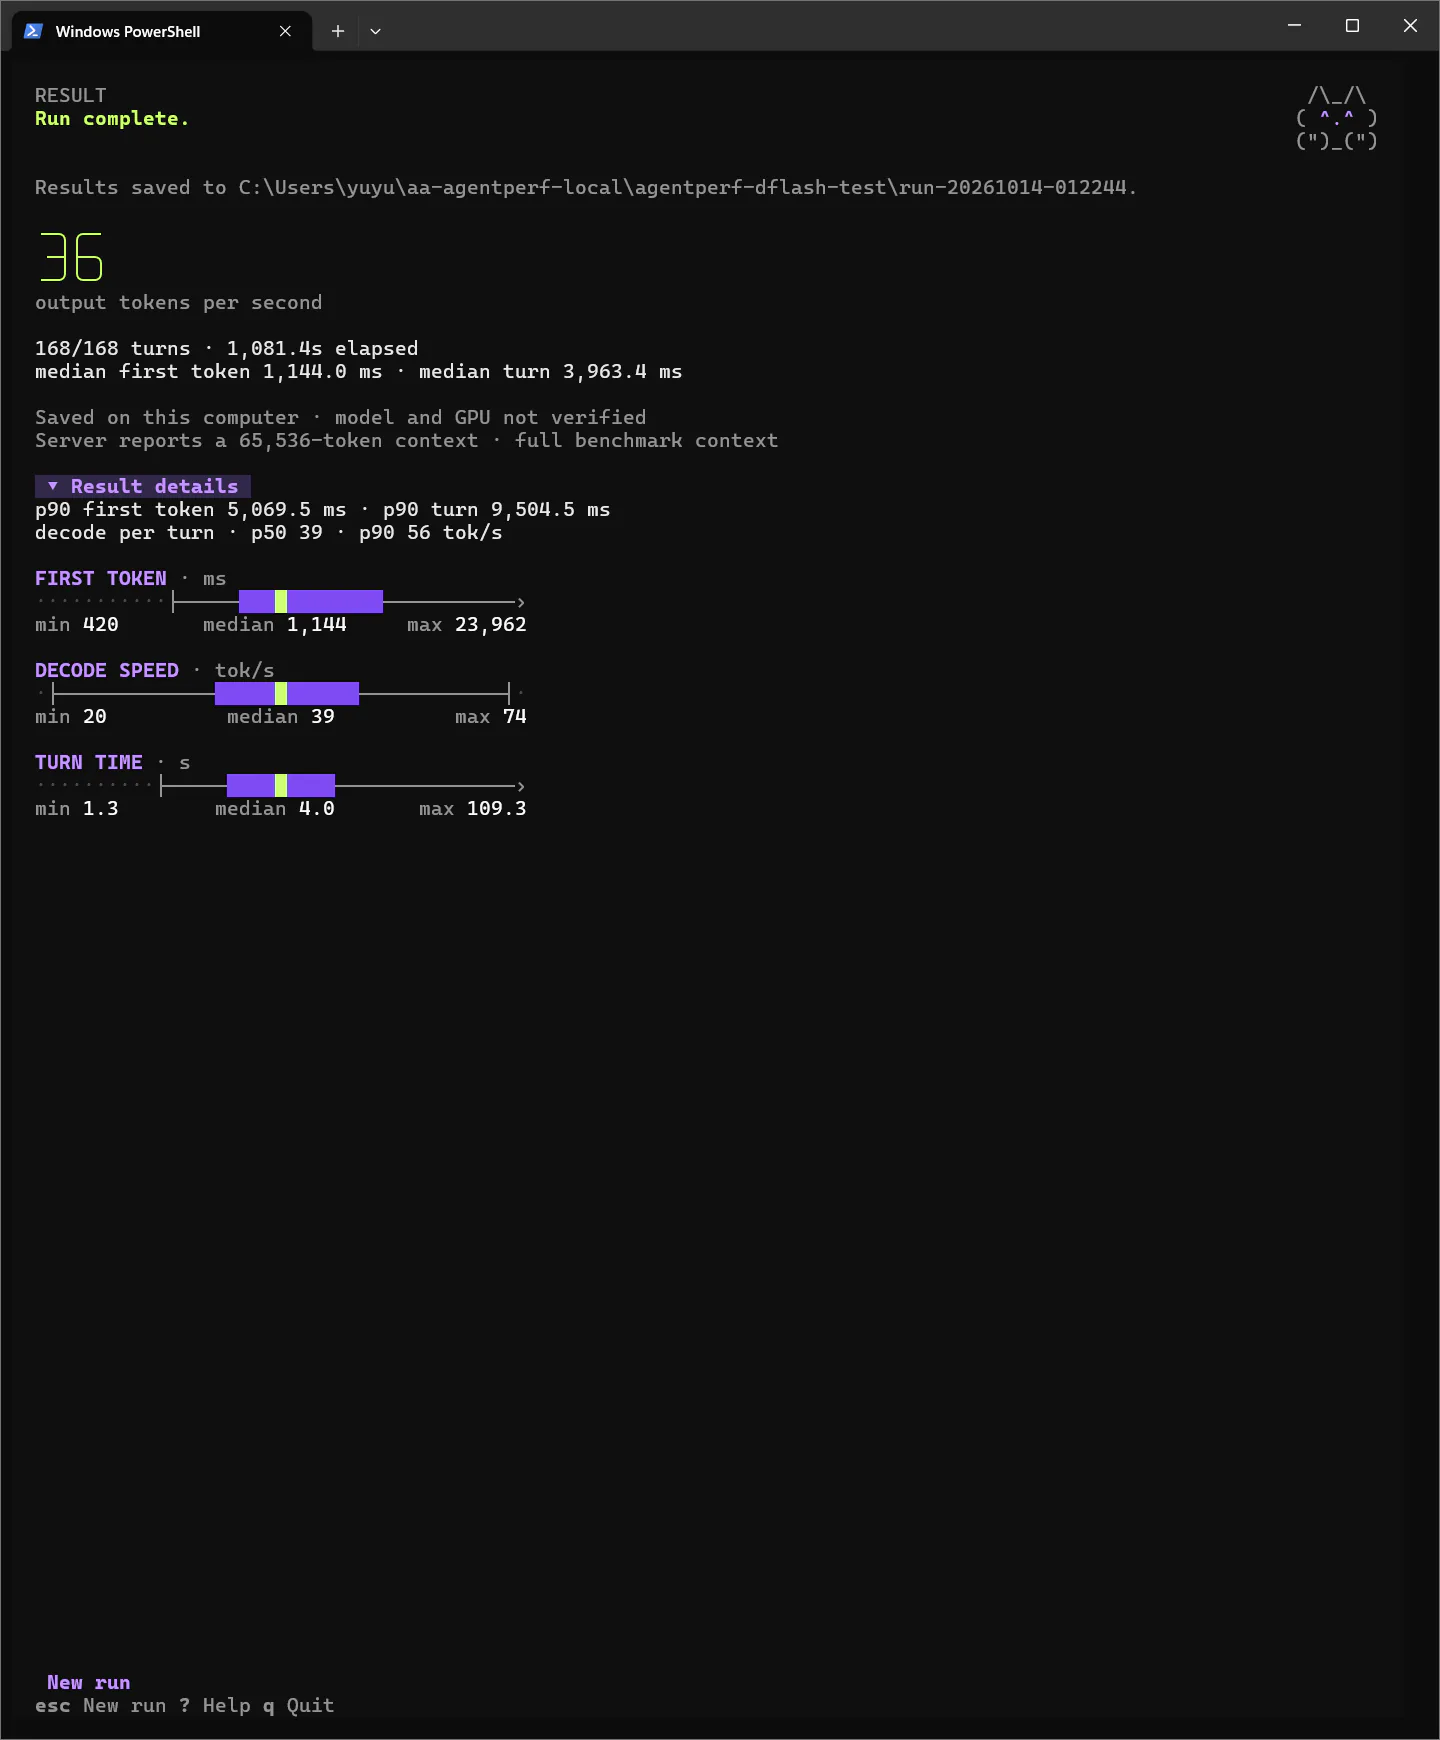
Ở cấu hình MTP, hệ thống đạt tốc độ sinh nội dung 20,69 token/giây. Tổng thời gian hoàn thành bài thử là 1.576,23 giây, tương đương khoảng 26 phút. Tôi tiếp tục thực hiện phép đo với llama.cpp CUDA sử dụng DFlash. Kết quả cải thiện rõ rệt khi tốc độ sinh nội dung tăng lên 36,22 token/giây, trong khi tổng thời gian giảm xuống còn 1.079,39 giây, tức khoảng 18 phút.
| AgentPerf Local | MTP | DFlash |
|---|---|---|
| Tổng số lượt xử lý | 168 | 168 |
| Tốc độ sinh nội dung | 20,69 token/giây | 36,22 token/giây |
| Tổng thời gian | 1.576,23 giây | 1.079,39 giây |
Như vậy, chỉ bằng việc thay đổi phương thức xử lý, tổng thời gian thực hiện bài thử đã giảm khoảng 31,5%.
Đây là một kết quả khiến tôi khá bất ngờ. Nó cho thấy hiệu năng AI không đơn giản phụ thuộc vào thông số phần cứng, mà còn chịu ảnh hưởng lớn từ phần mềm và cách mô hình được triển khai. Cần lưu ý rằng bài thử sử dụng cơ chế phát lại thao tác công cụ nhằm đo hiệu năng, không phải phép kiểm tra độc lập về chất lượng câu trả lời của AI. Dù vậy, việc một chiếc laptop có thể vận hành mô hình 27 tỉ tham số trong một bài thử kéo dài hàng trăm lượt xử lý cho thấy lợi ích rõ ràng của bộ nhớ hợp nhất dung lượng lớn.
Tạo hình ảnh bằng AI ngay trên laptop
Sau mô hình ngôn ngữ, tôi chuyển sang những tác vụ tạo nội dung bằng AI. Đầu tiên là MLPerf Client 2.0.1, bộ công cụ đánh giá hiệu năng AI với các bài thử được thiết kế theo những nhóm công việc cụ thể.
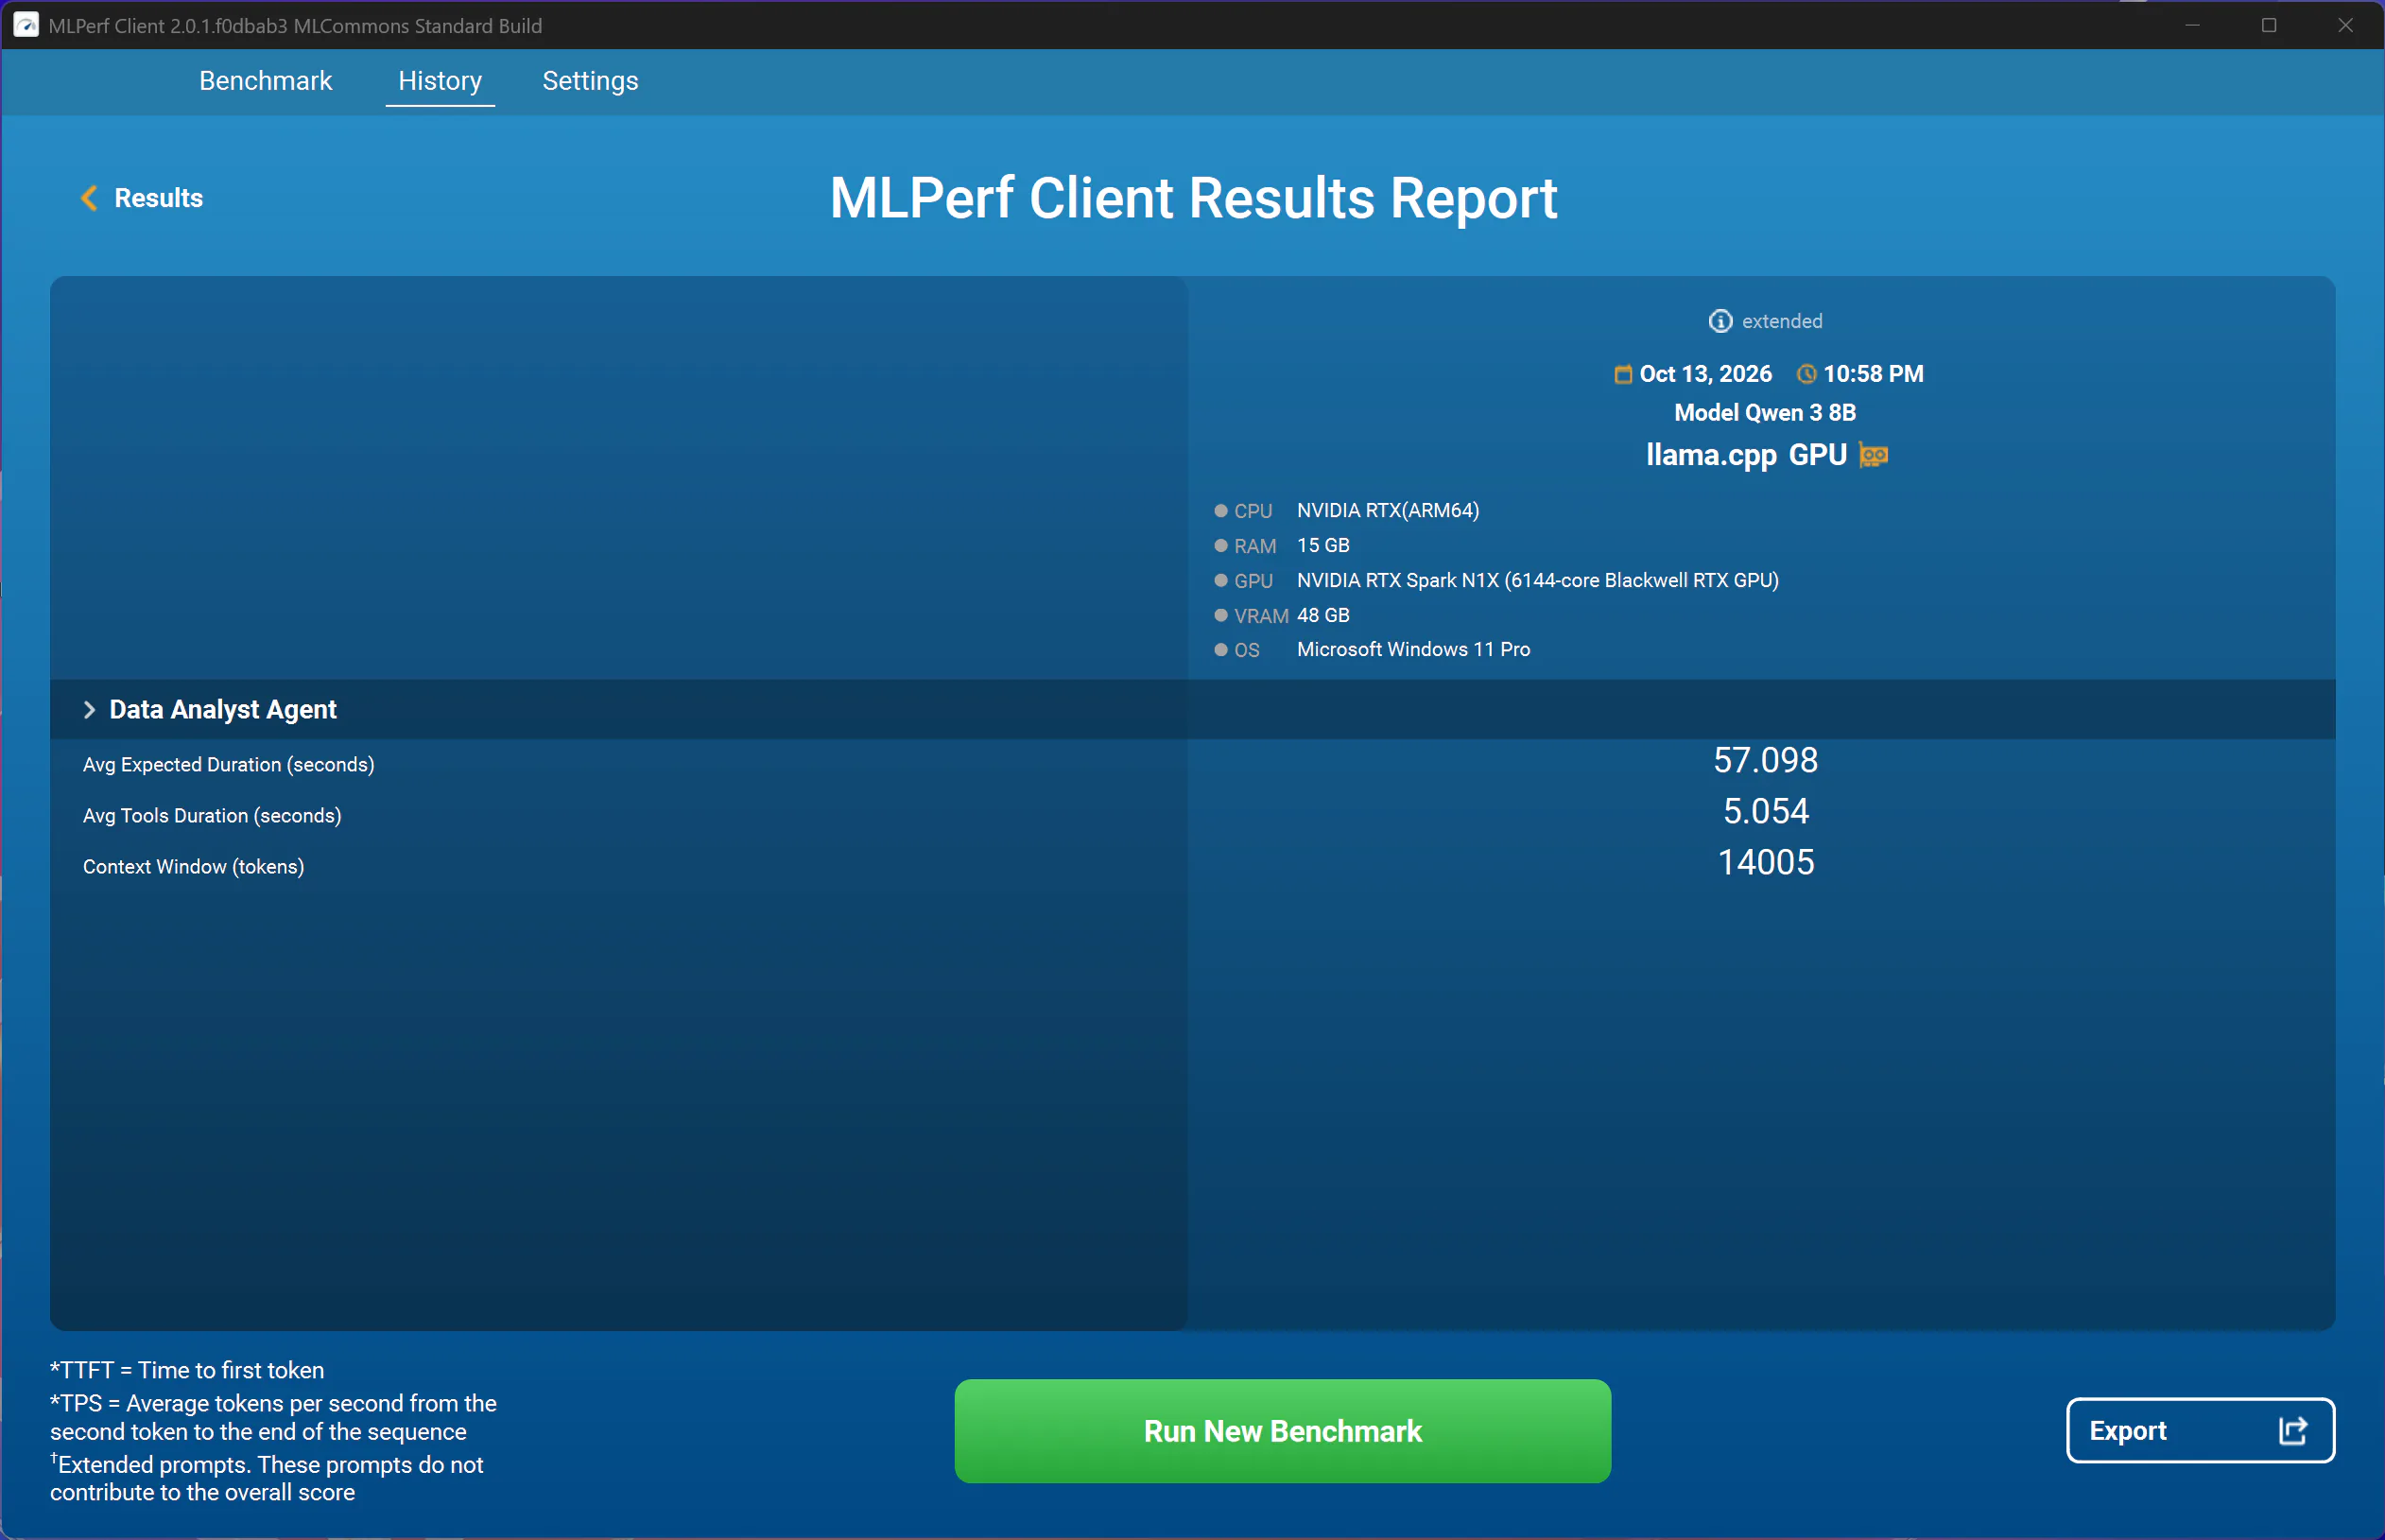
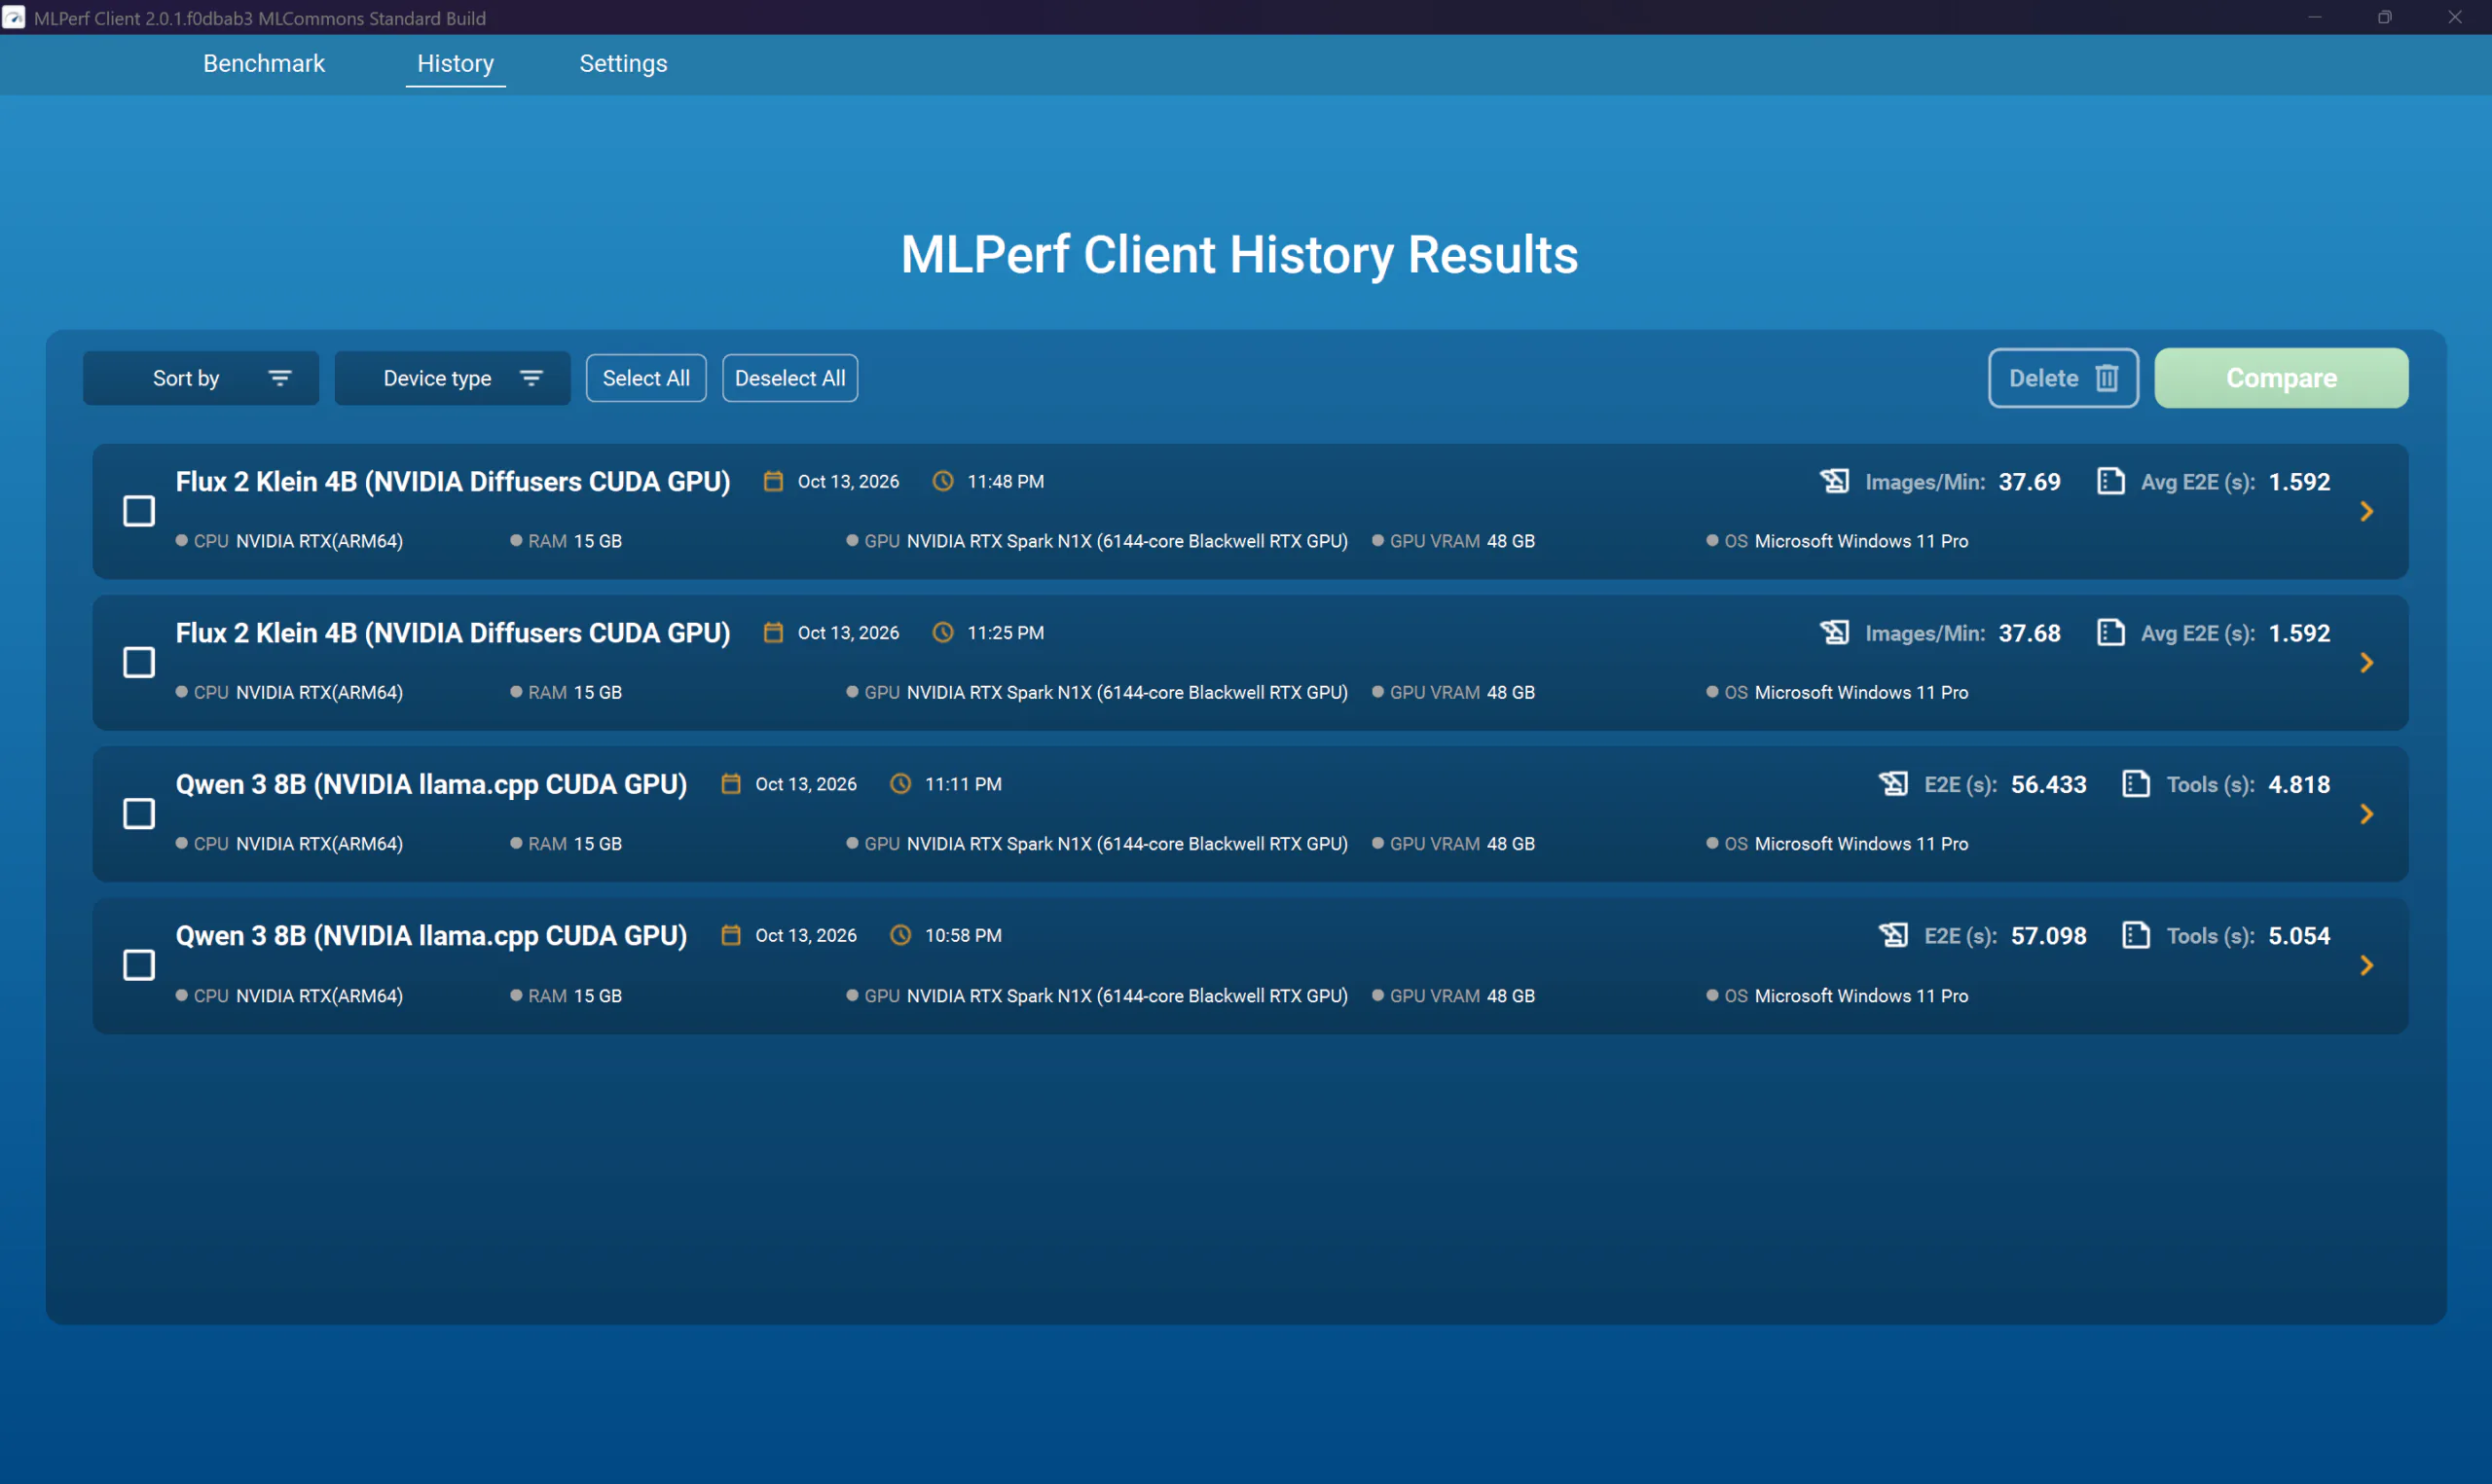
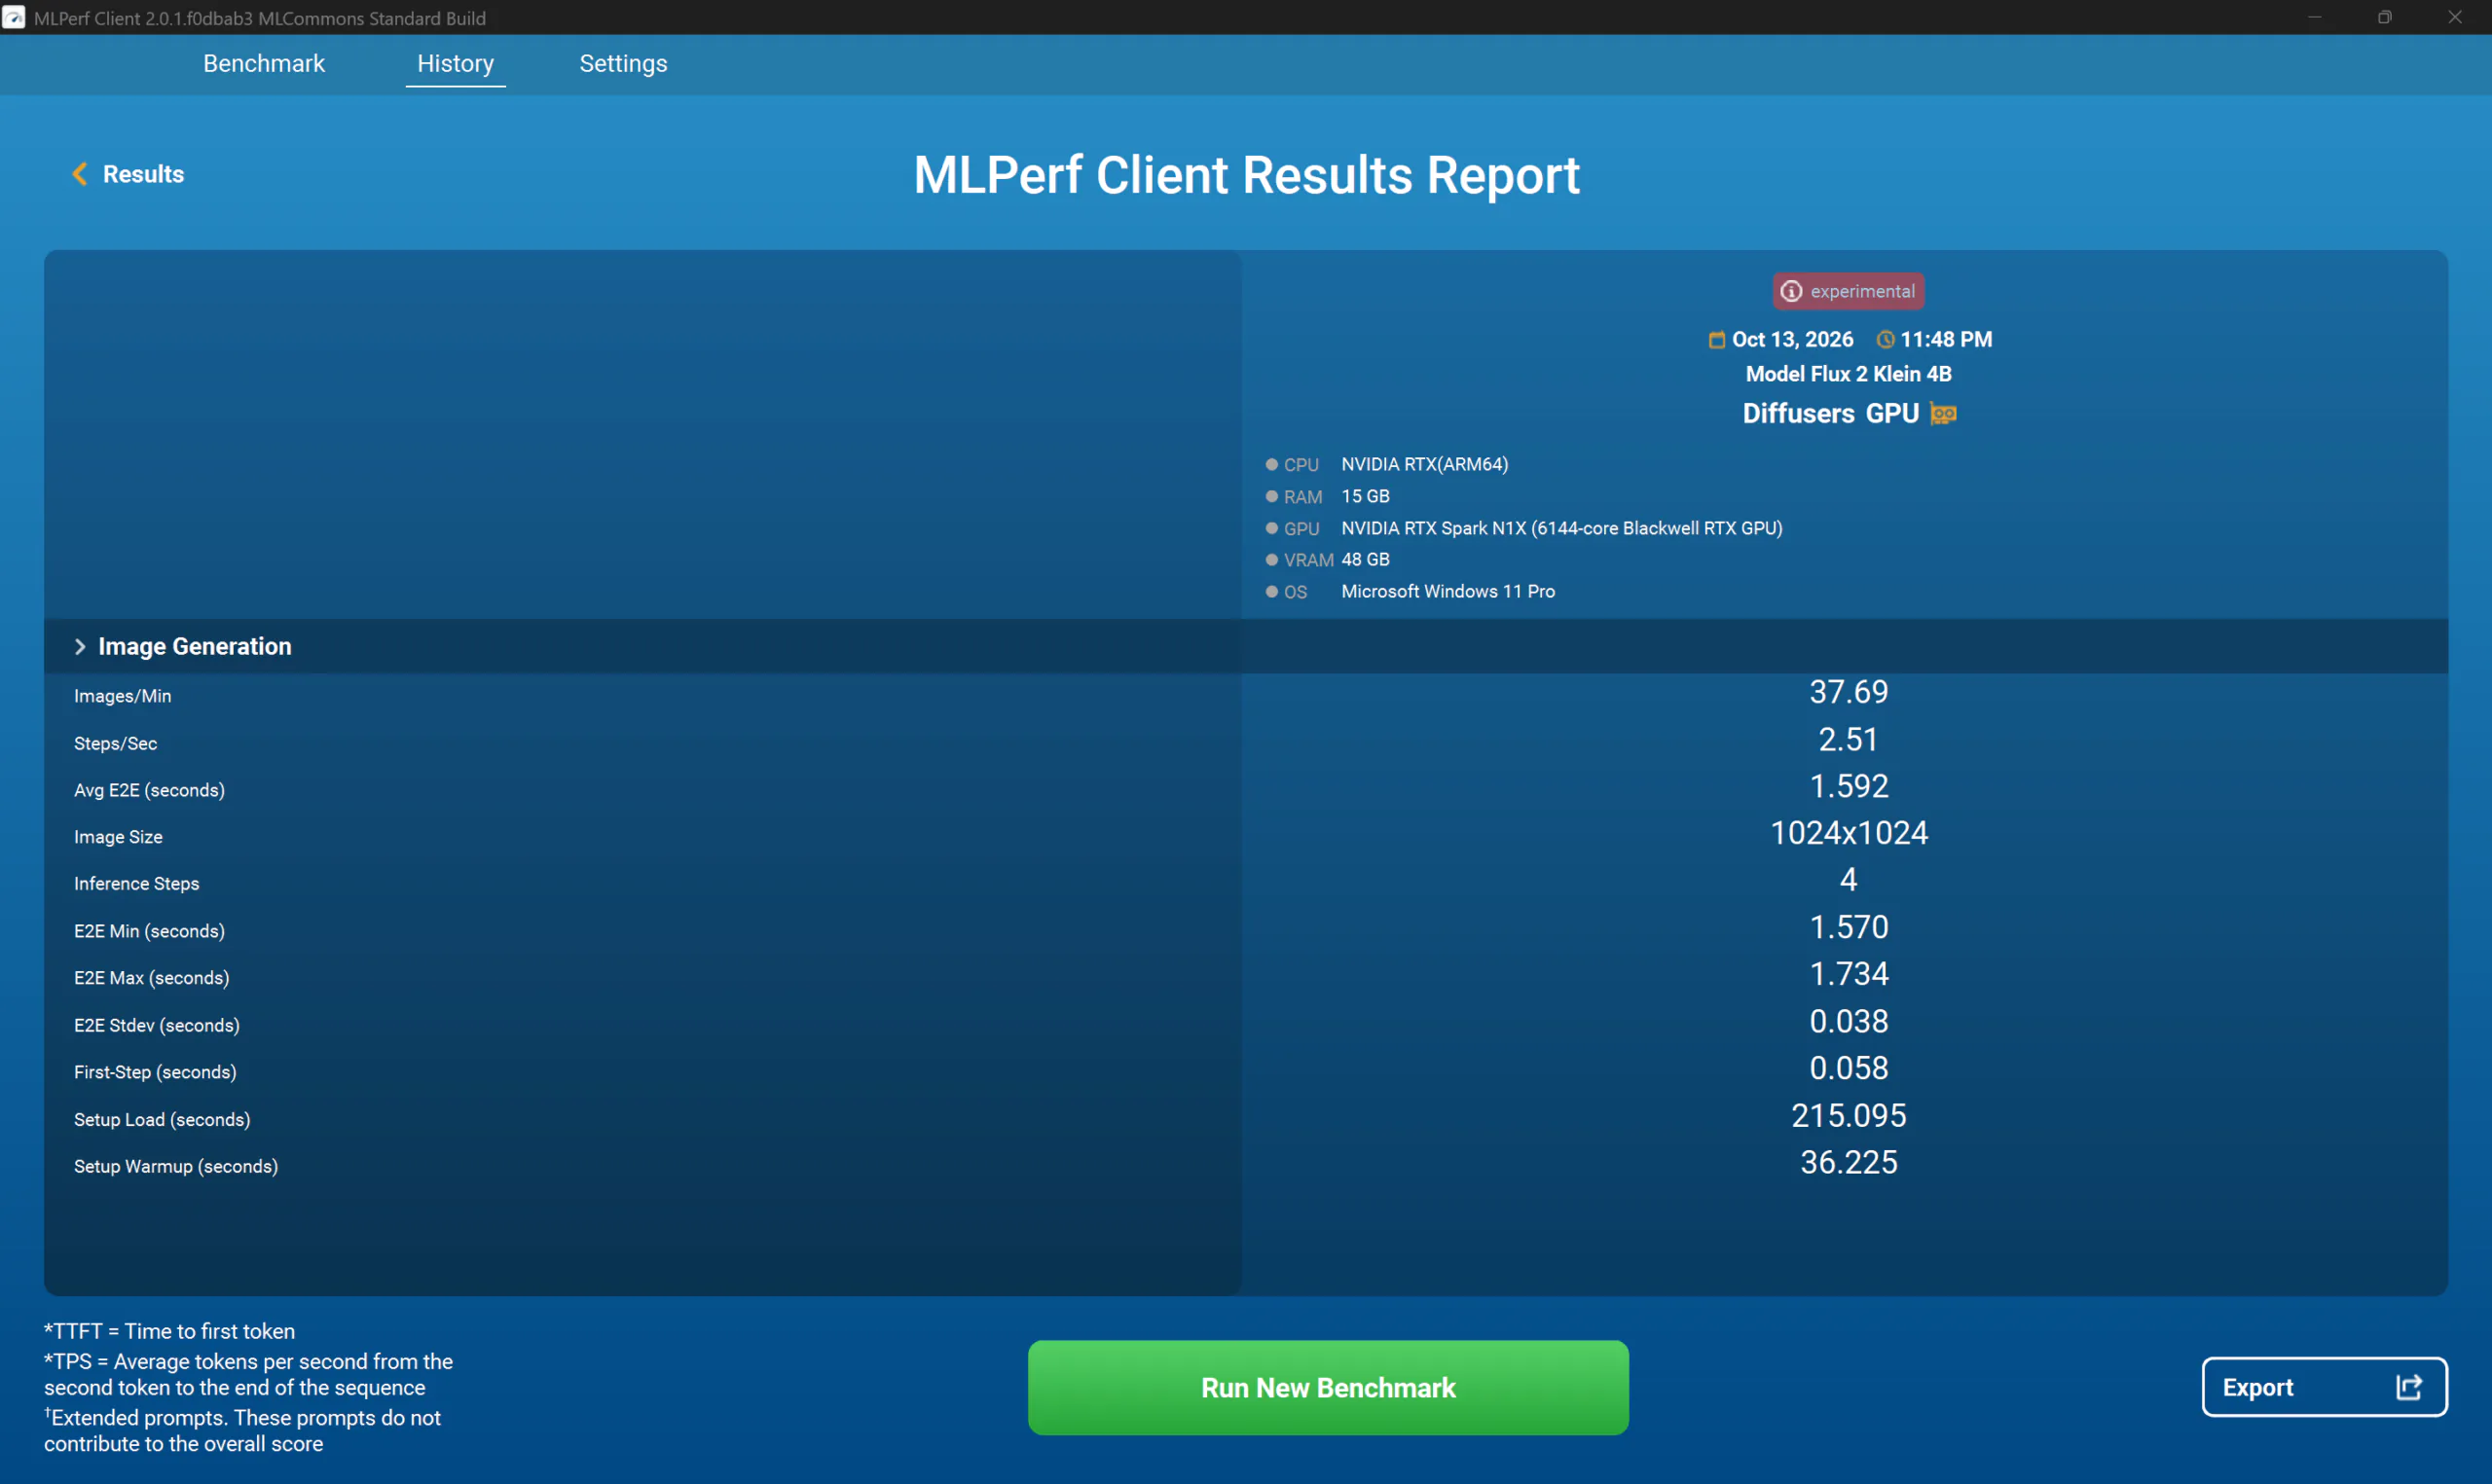
Ở bài kiểm tra Qwen3-8B Agentic Extended, hai lần chạy ghi nhận thời gian lần lượt 57,098 giây và 56,433 giây. Kết quả tương đối sát nhau, cho thấy hệ thống duy trì hiệu năng ổn định trong điều kiện thử nghiệm. Với tác vụ tạo hình ảnh bằng FLUX.2 Klein 4B NVFP4, hệ thống đạt khoảng 37,68–37,69 hình/phút, với thời gian xử lý đầu cuối được ghi nhận ở mức 1,592 giây.
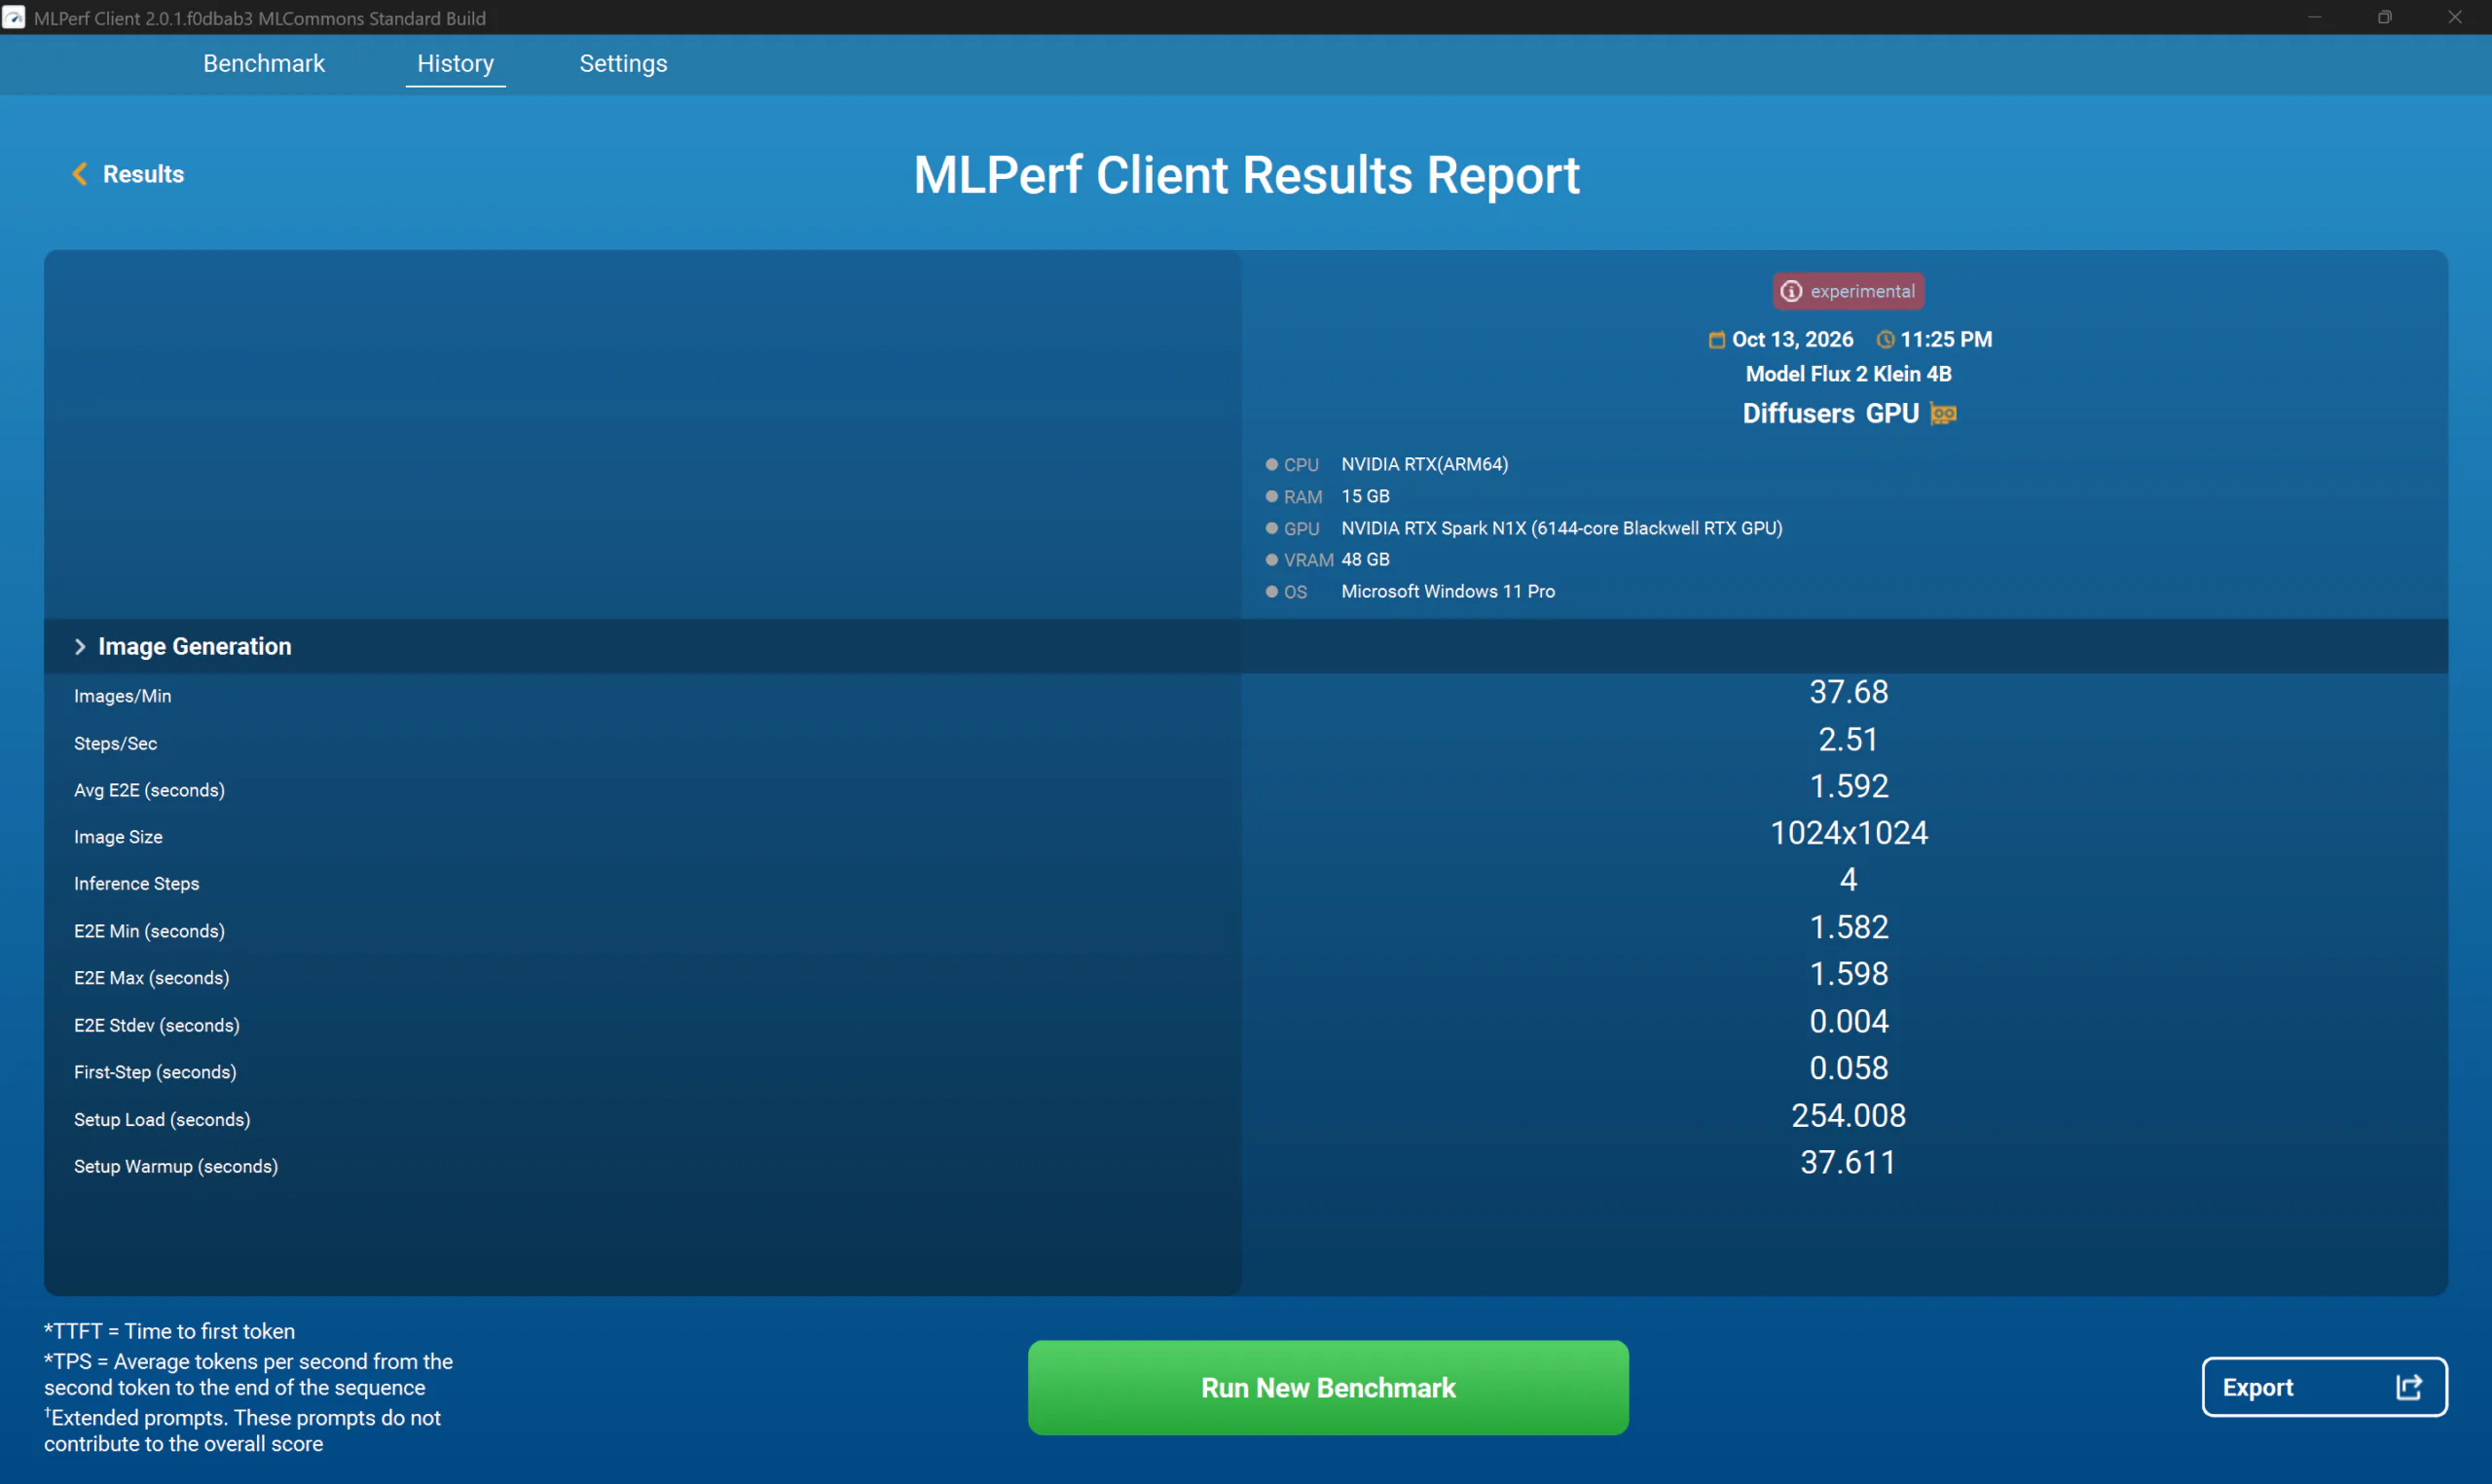
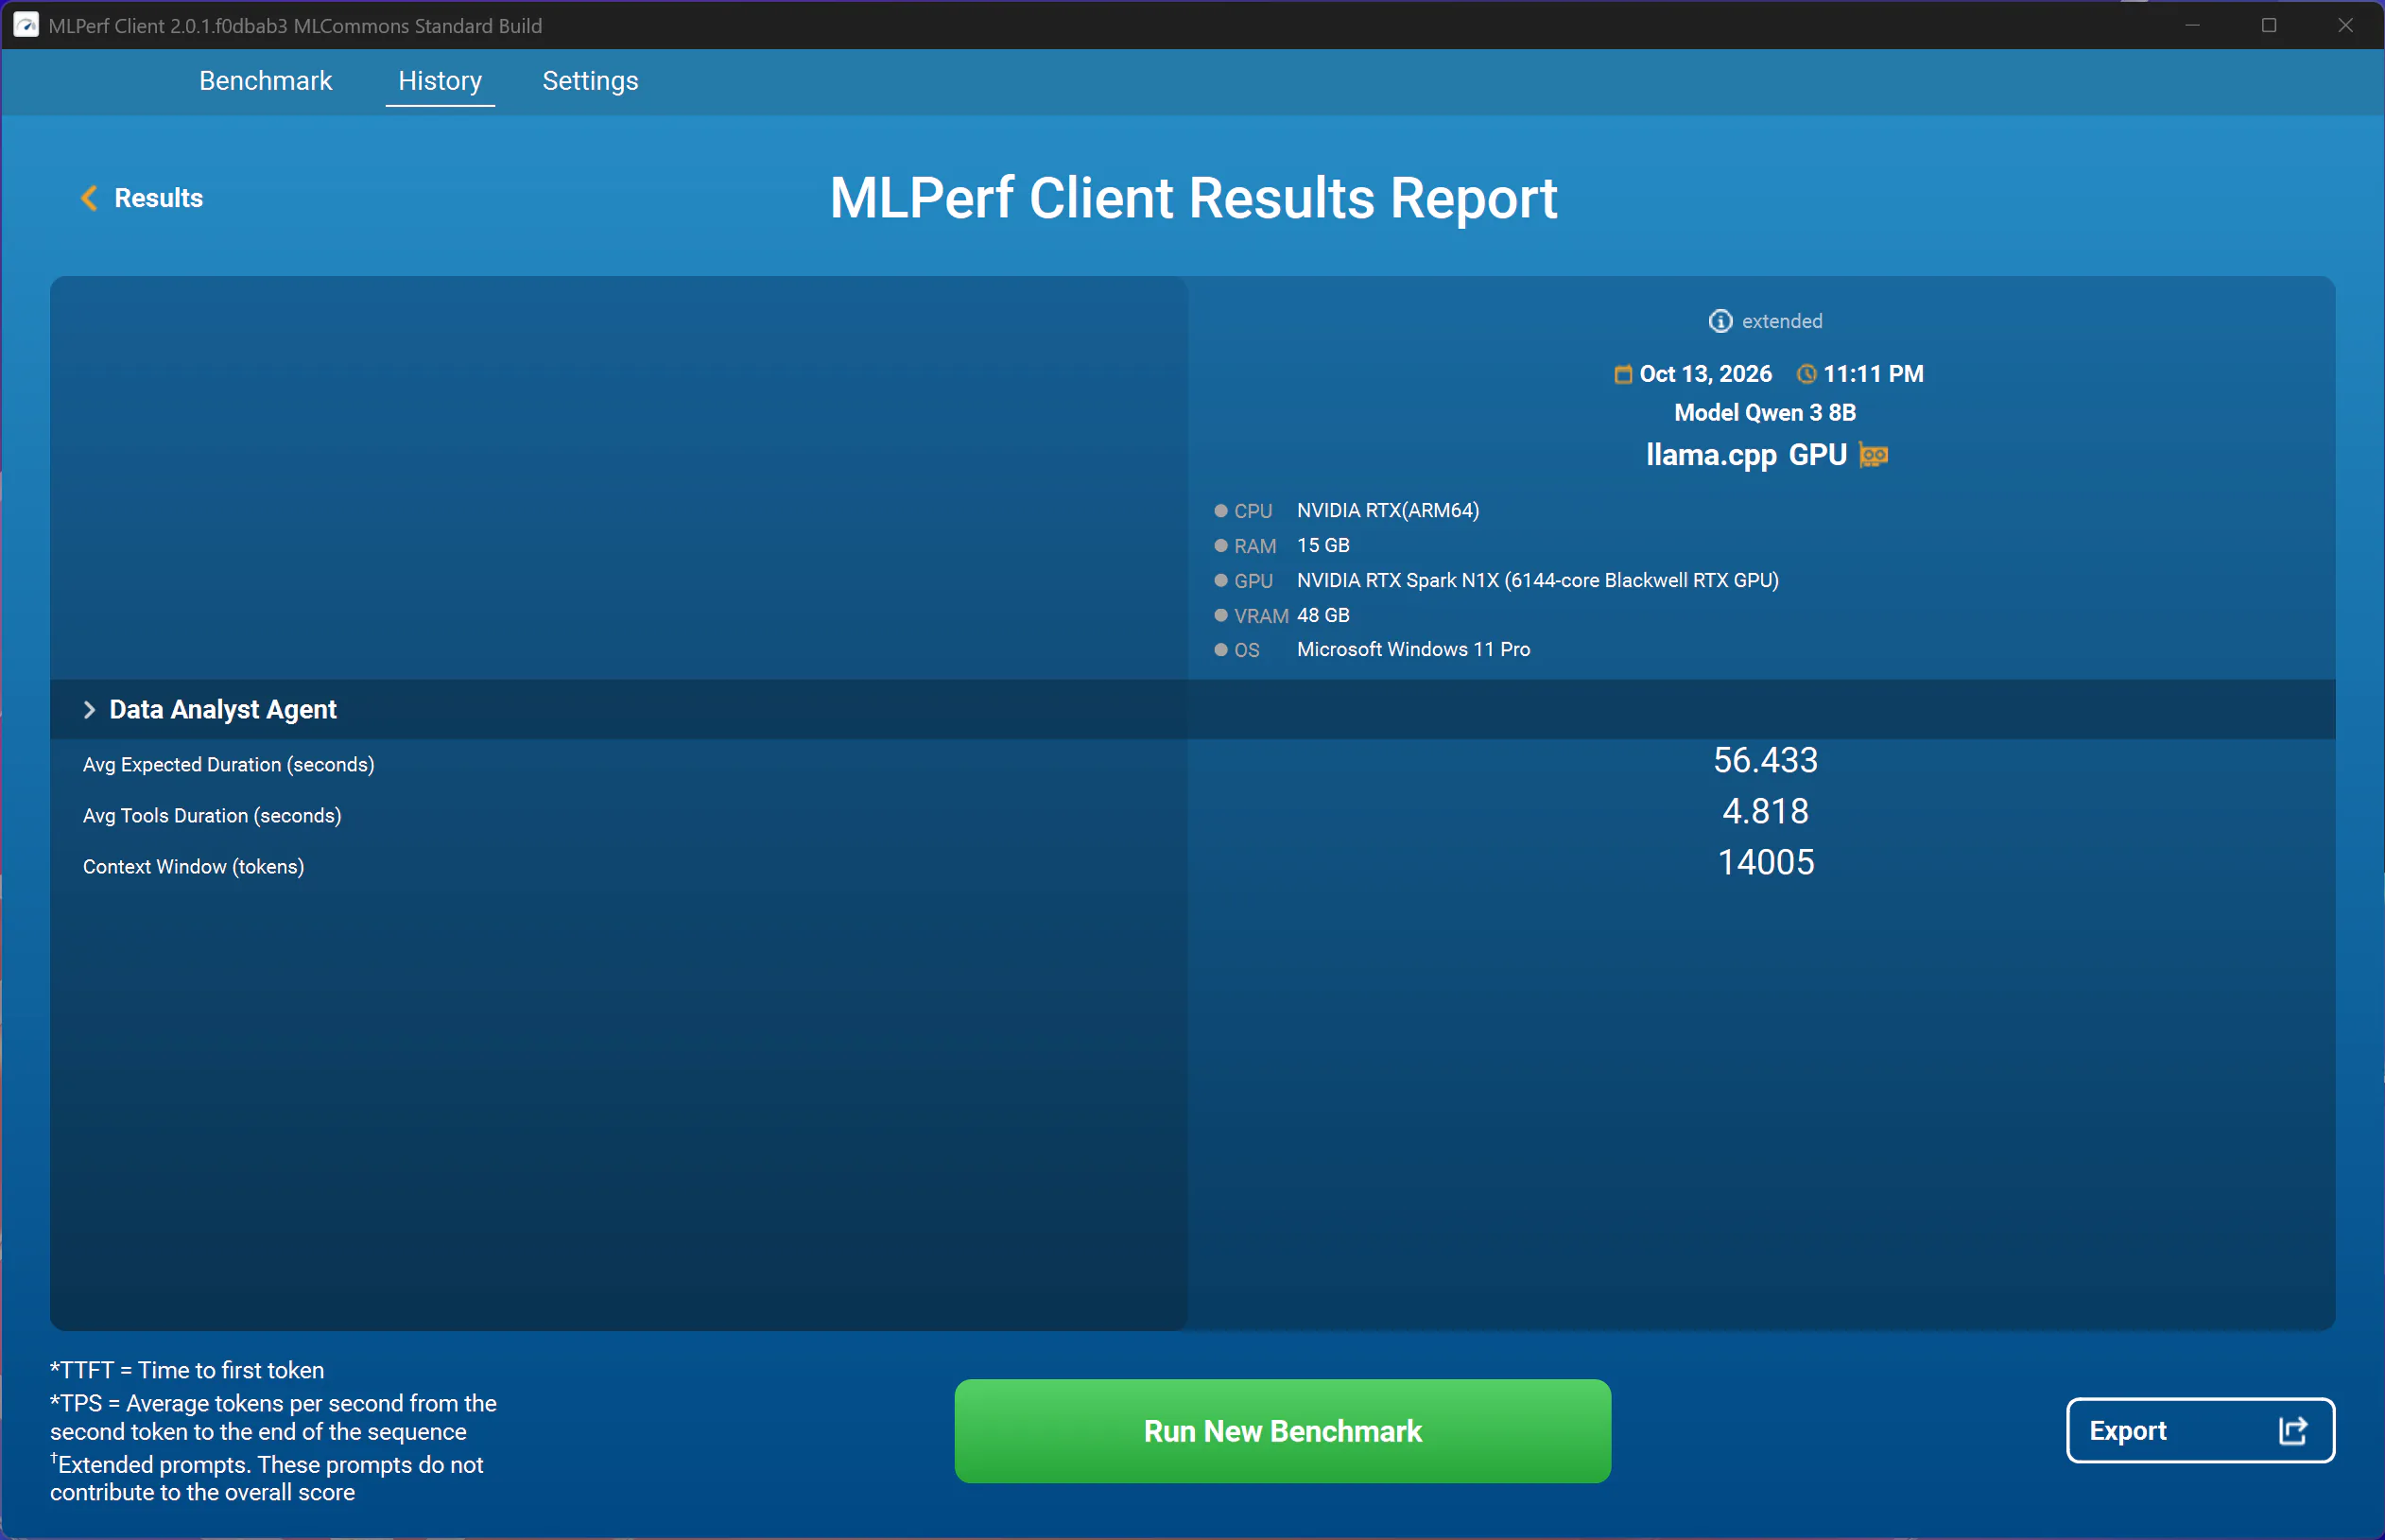
Tuy nhiên, những kết quả benchmark như vậy đôi khi khá khó hình dung. Vì thế, tôi tiếp tục sử dụng ComfyUI, một công cụ quen thuộc với những người thường xuyên thử nghiệm các mô hình tạo ảnh. Điểm thú vị của ComfyUI nằm ở cách xây dựng quy trình xử lý. Người dùng có thể kết nối các thành phần để kiểm soát từng bước tạo hình ảnh, thay vì chỉ nhập câu lệnh vào một giao diện đơn giản.
Tôi thực hiện các bài thử trên ComfyUI Desktop dành cho Windows ARM64. Sau một lần chạy khởi động, hệ thống được đo qua năm lần thực hiện tiếp theo.
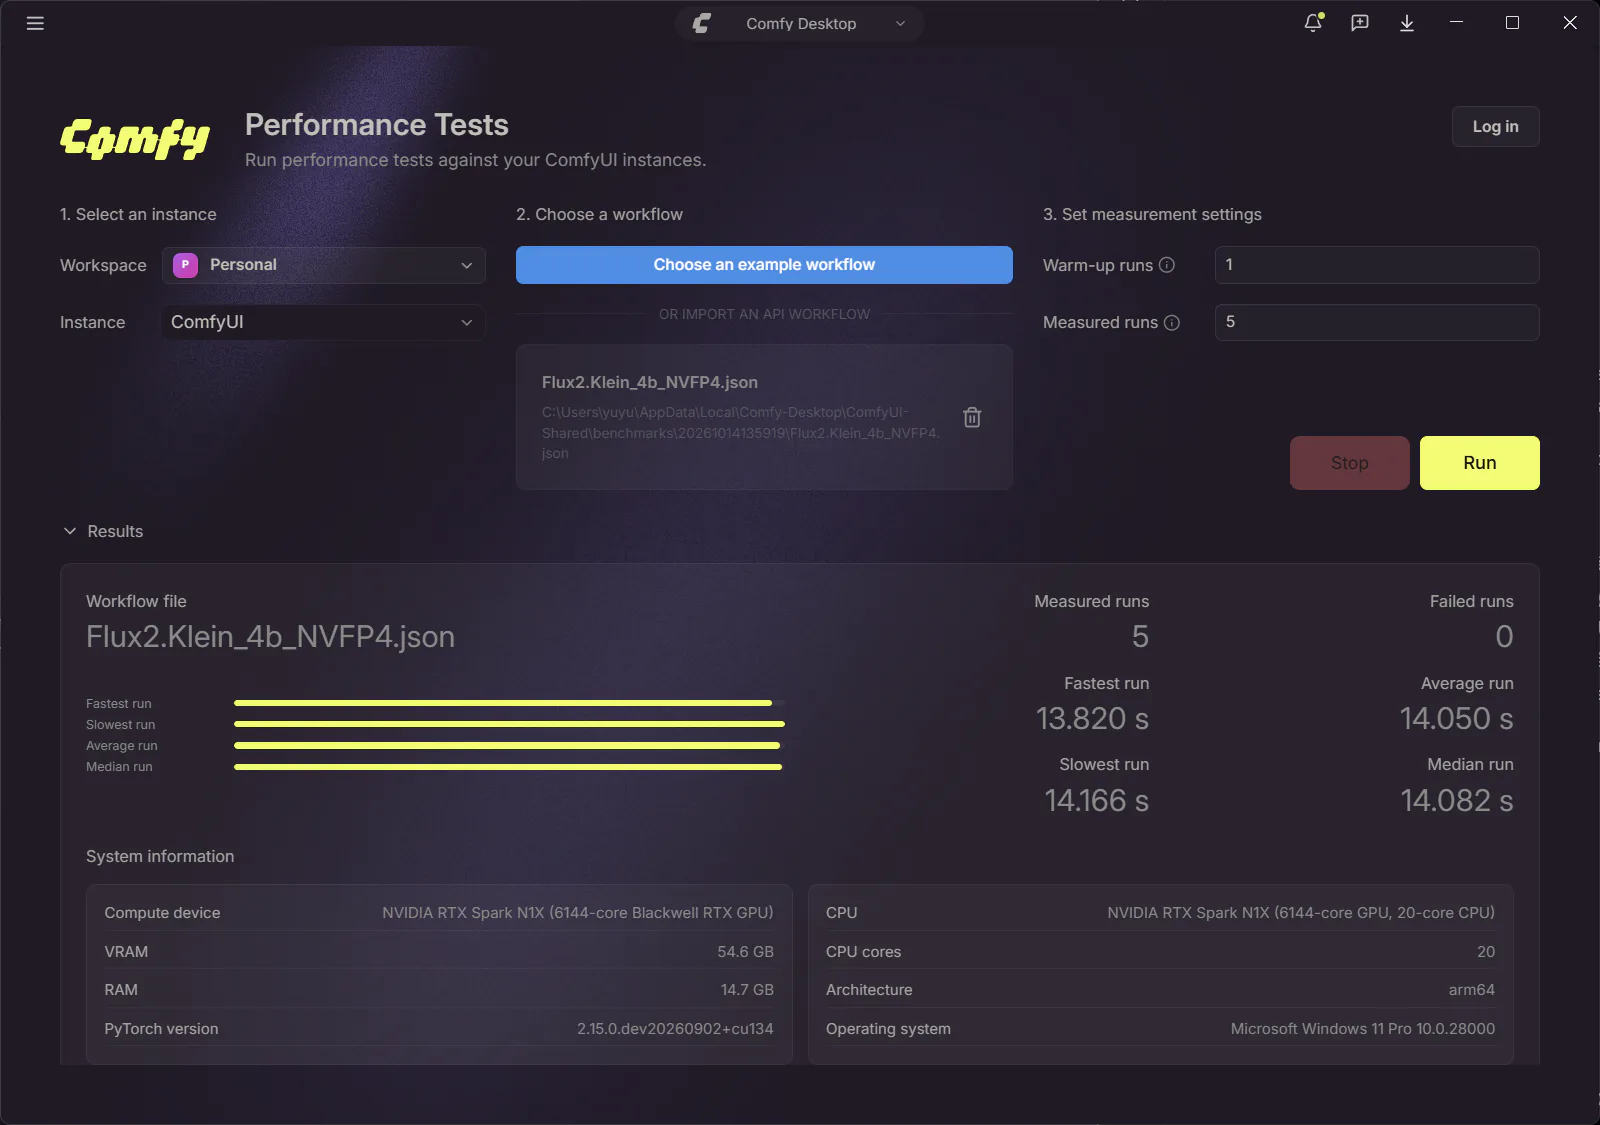
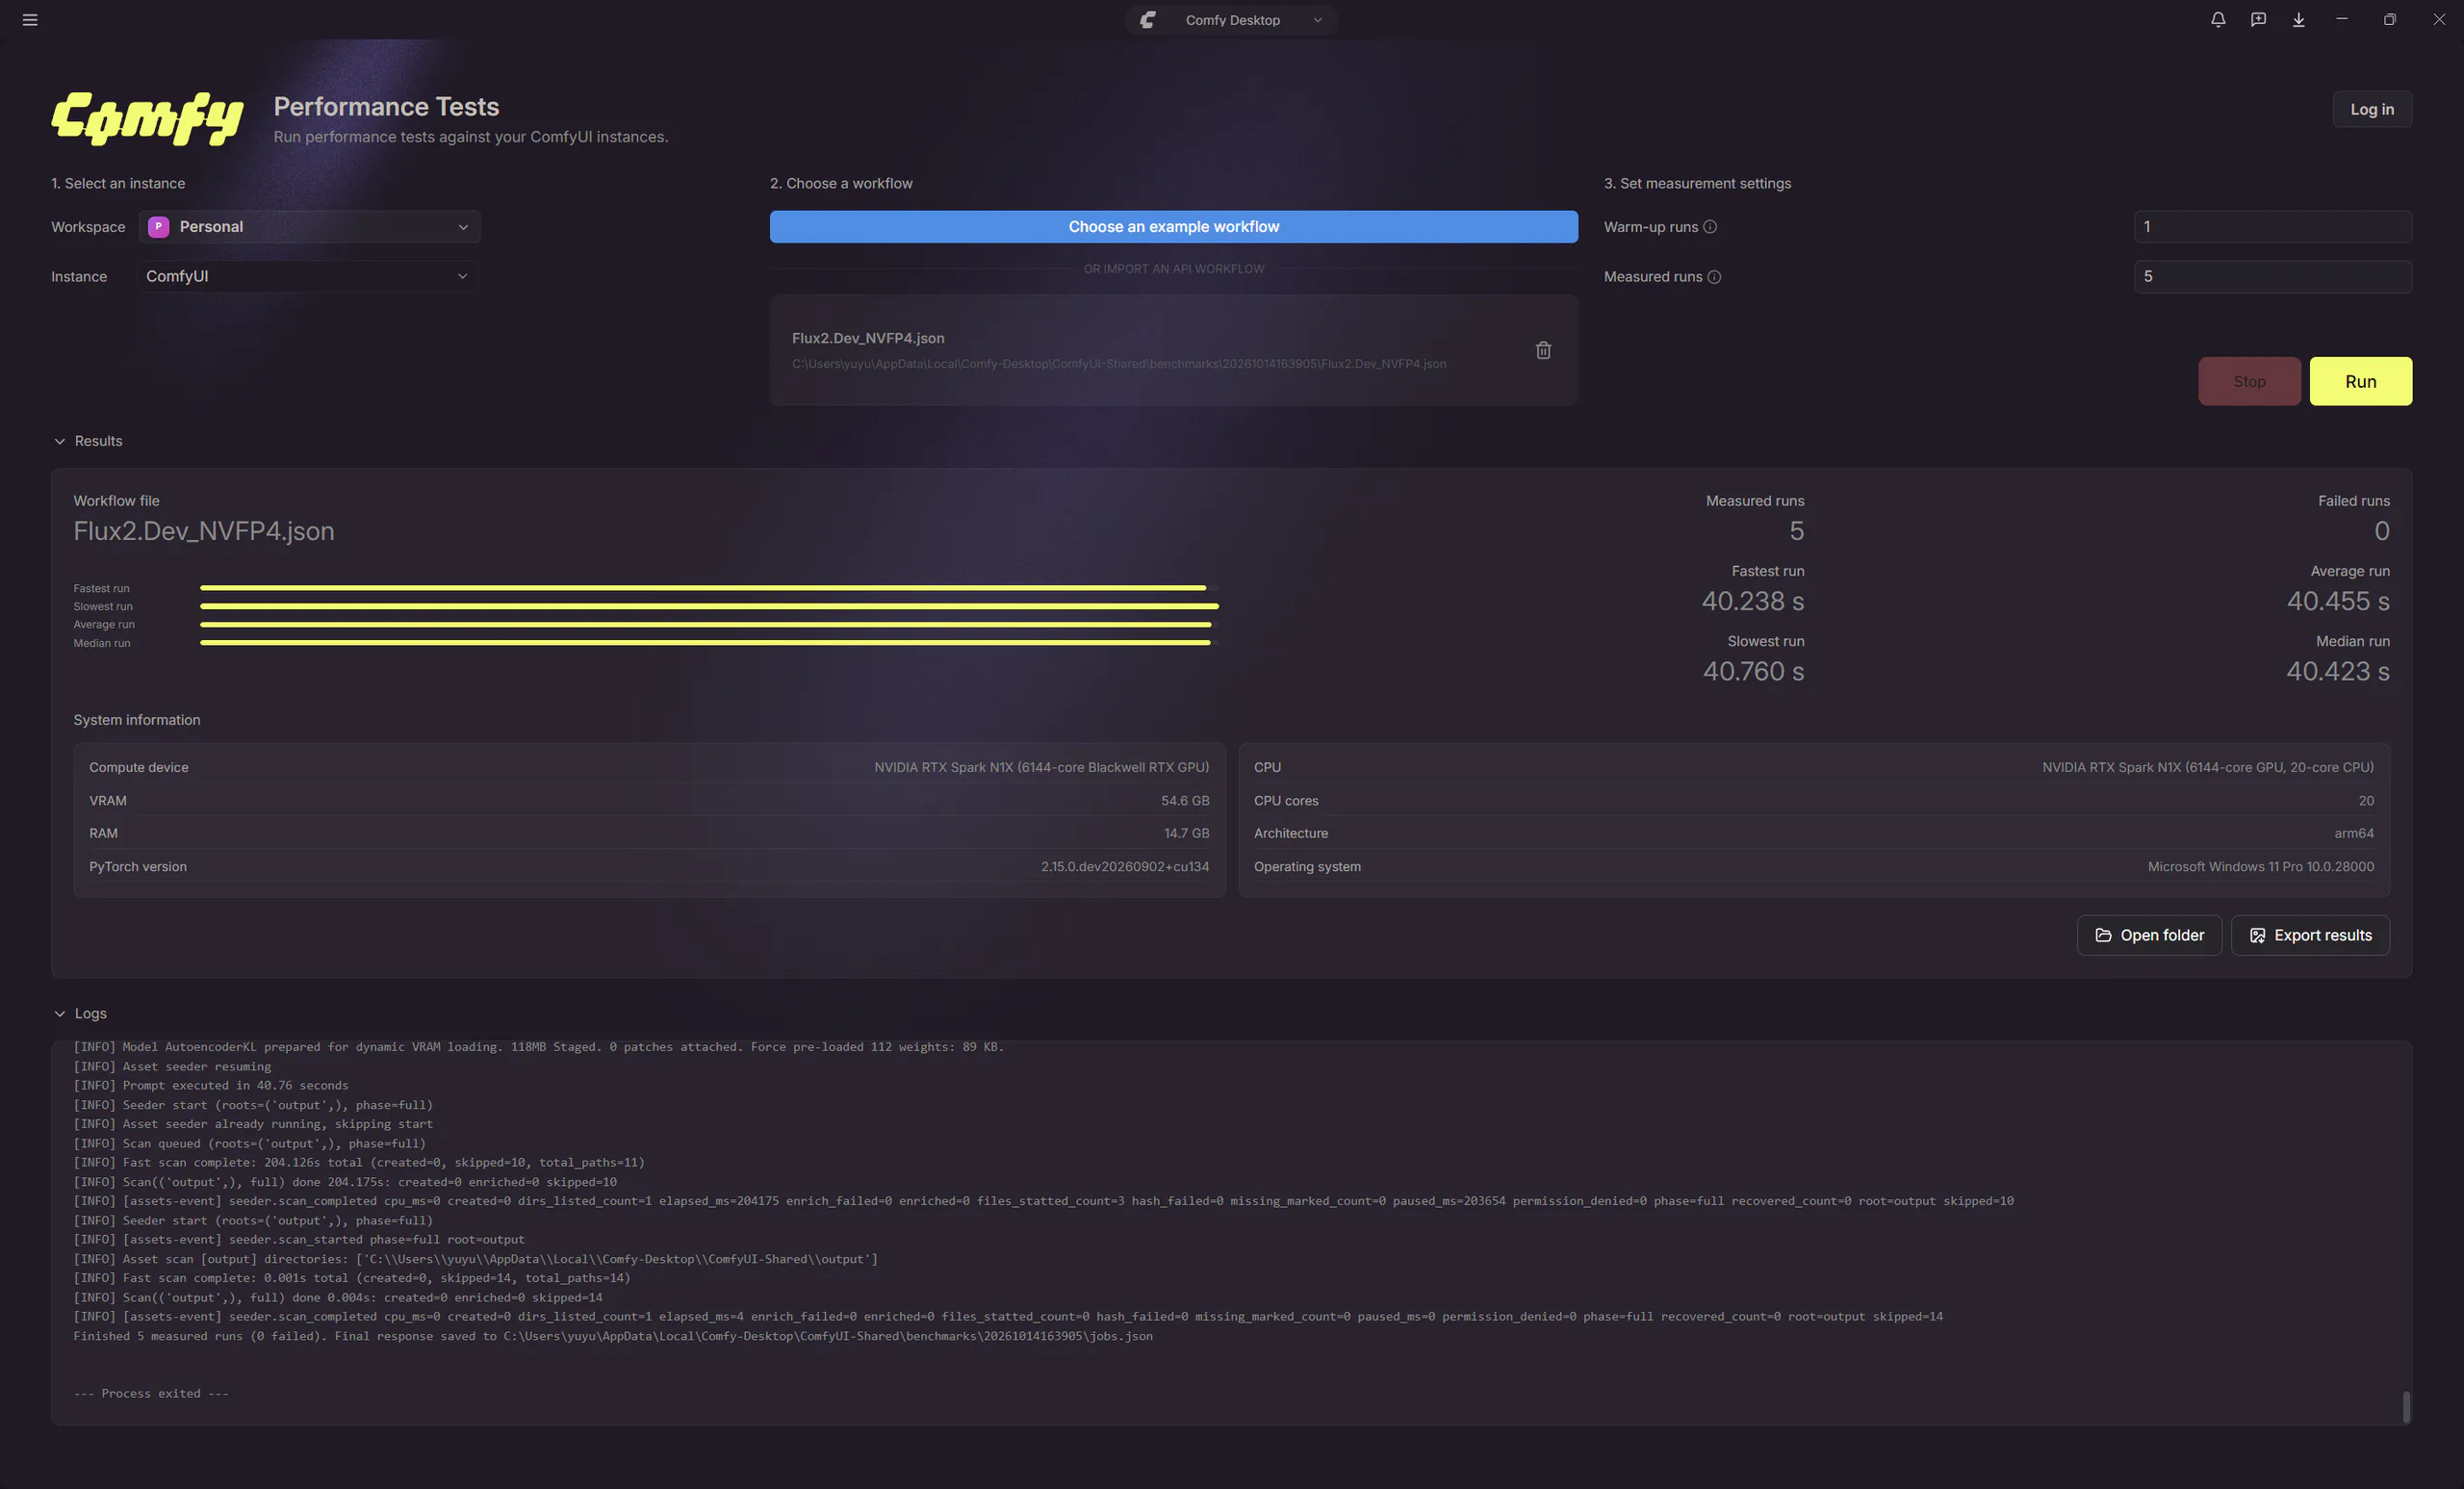
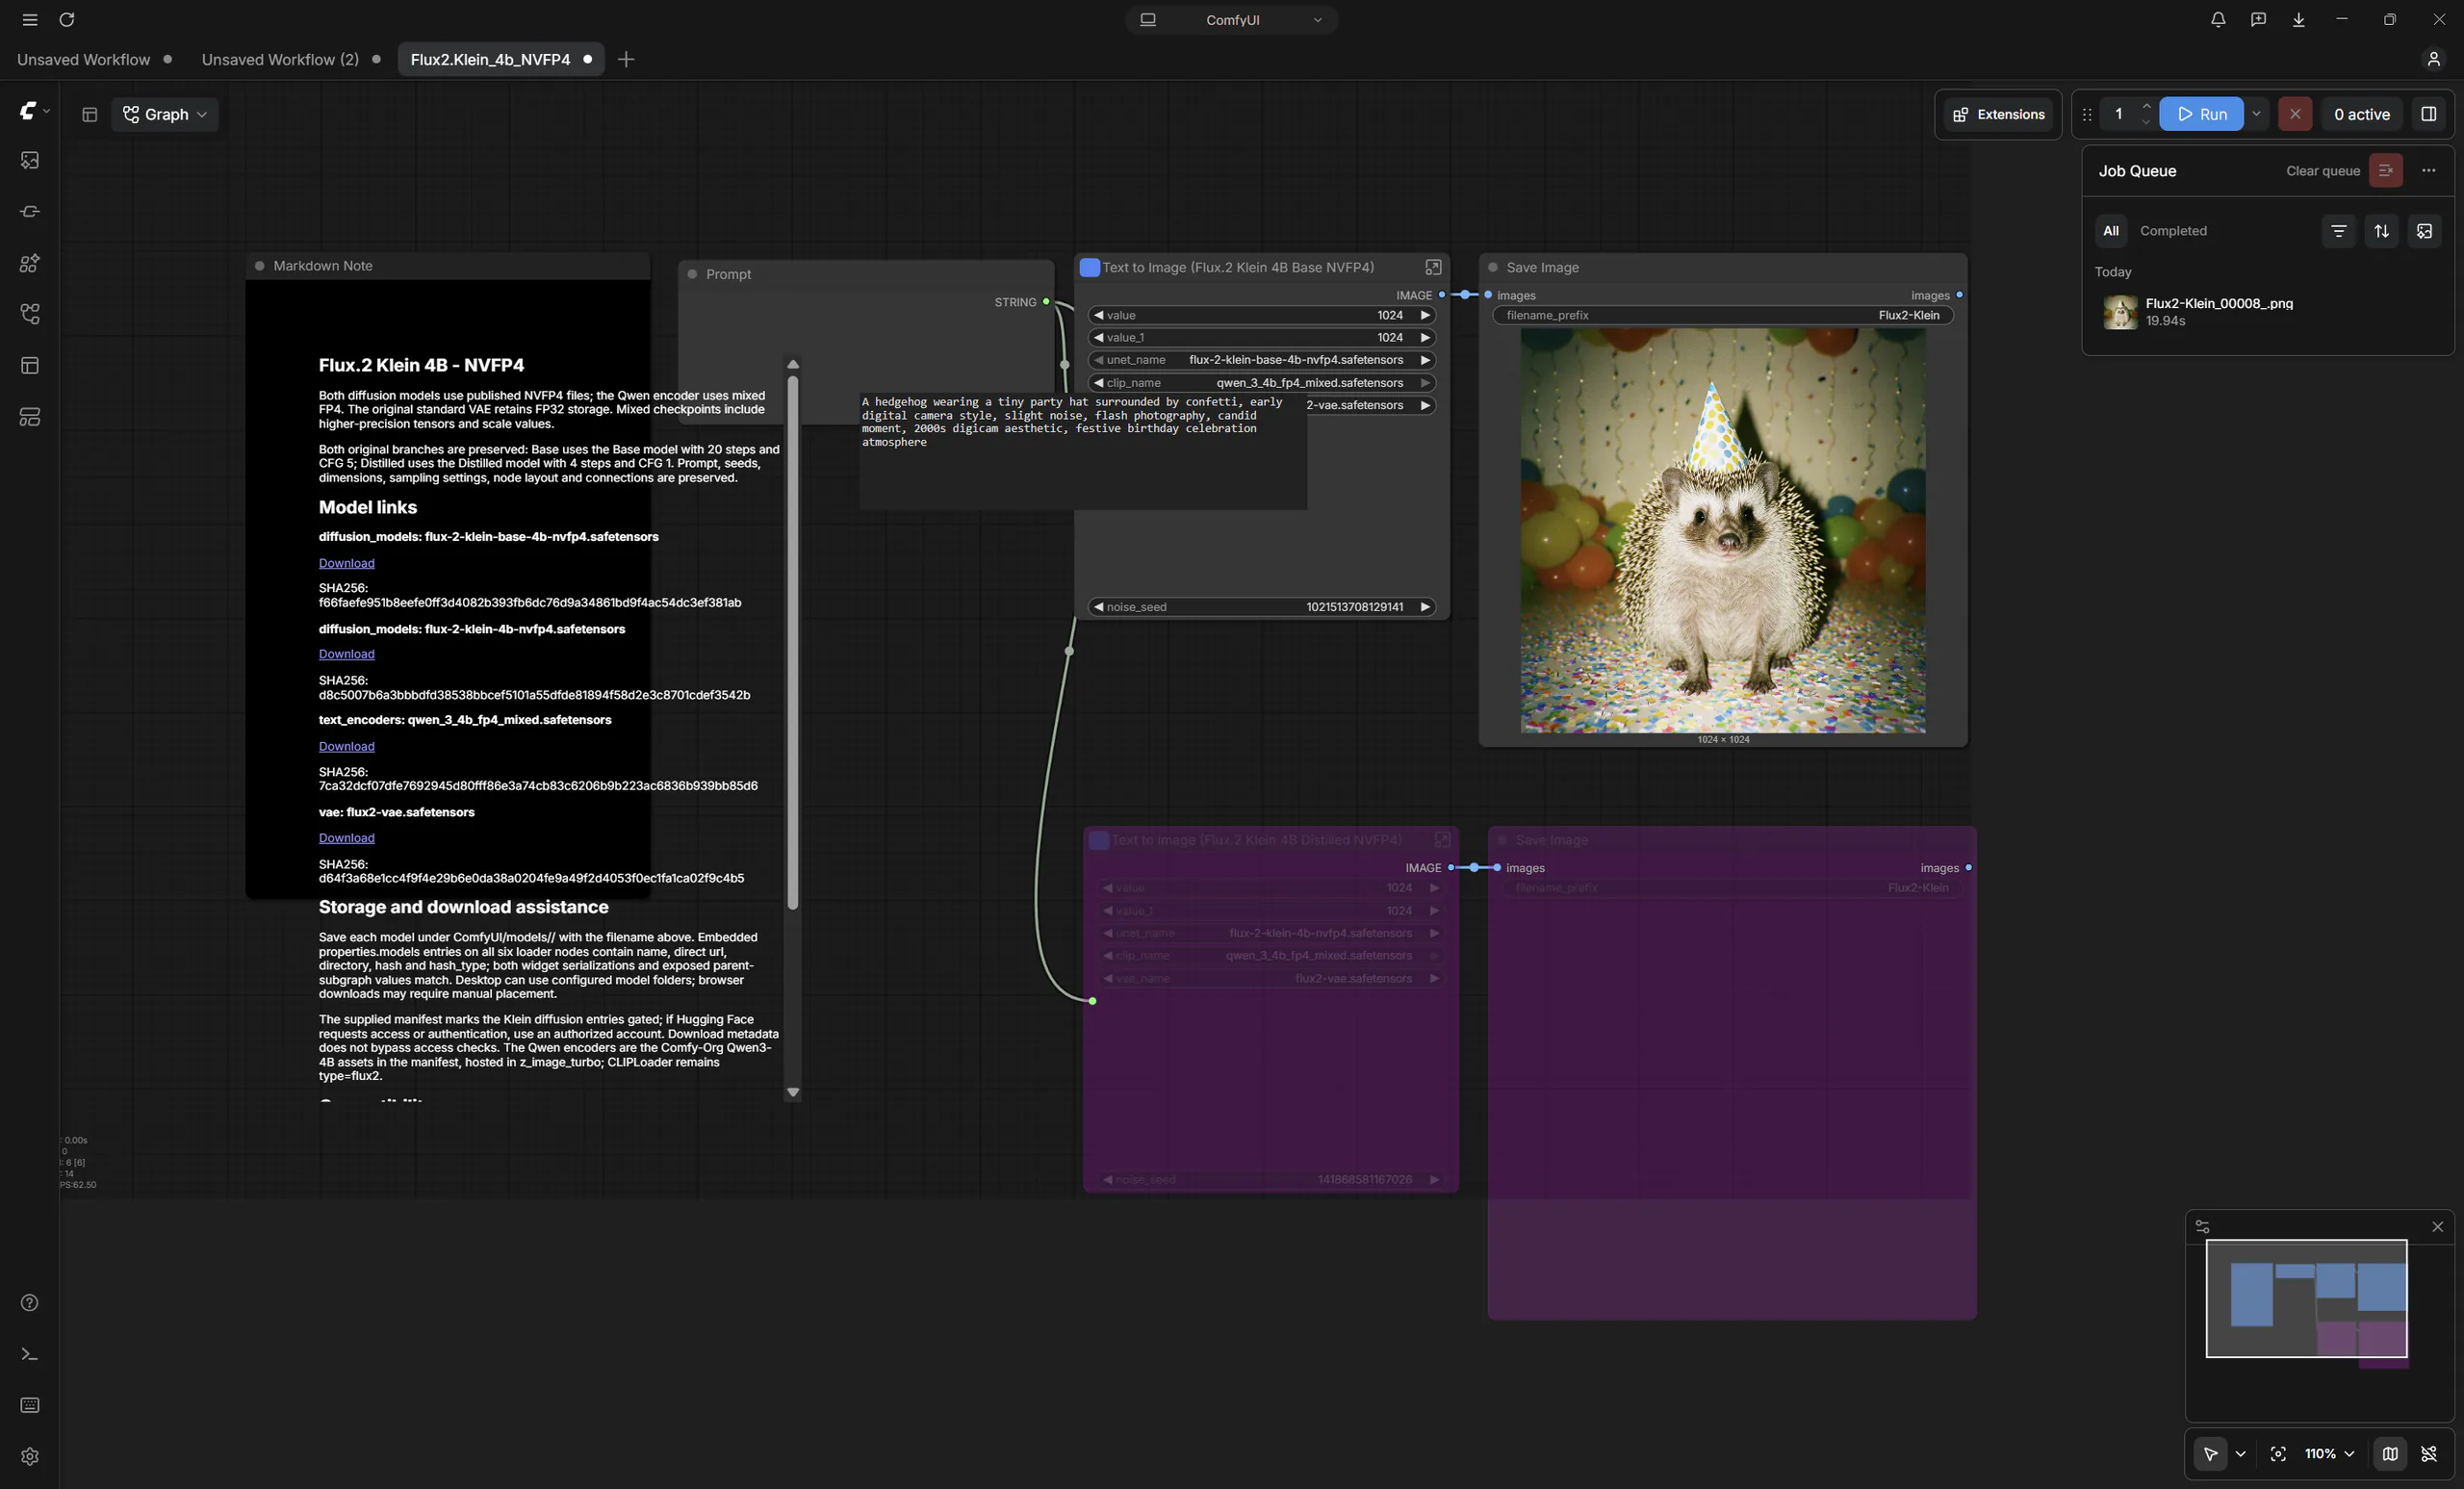
Với FLUX.2 Klein 4B NVFP4, thời gian xử lý trung bình là 14,05 giây. Khi chuyển sang FLUX.2 Dev NVFP4, thời gian tăng lên 40,46 giây.
| Mô hình trên ComfyUI | Thời gian trung bình |
|---|---|
| FLUX.2 Klein 4B NVFP4 | 14,05 giây |
| FLUX.2 Dev NVFP4 | 40,46 giây |
Sự chênh lệch giữa hai mô hình là điều có thể dự đoán, bởi chúng có yêu cầu xử lý khác nhau. Quan trọng hơn, cả hai đều có thể hoạt động trực tiếp trên chiếc laptop thử nghiệm.
Với tôi, lợi ích lớn nhất của AI cục bộ trong trường hợp này không nhất thiết là tốc độ nhanh hơn mọi dịch vụ trực tuyến. Điểm đáng giá nằm ở quyền chủ động. Người dùng có thể lựa chọn mô hình, điều chỉnh quy trình, thử nghiệm nhiều cấu hình và xử lý dữ liệu ngay trên thiết bị. Điều này đặc biệt hữu ích với những người làm sáng tạo nội dung hoặc phát triển các công cụ AI theo nhu cầu riêng.
Khi AI tự viết một phần mềm Windows
Nếu phải chọn ra trải nghiệm đáng nhớ nhất trong quá trình thử RTX Spark N1X, tôi sẽ chọn phần này. Tôi sử dụng Hermes, một AI agent chạy cục bộ với mô hình Qwen3.8 27B, để thử nghiệm khả năng tự thực hiện công việc trên Windows.
Khác với chatbot thông thường, AI agent có thể sử dụng các công cụ của hệ thống để đọc tệp, thực thi lệnh và xử lý nhiều bước liên tiếp. Thay vì chỉ đưa ra câu trả lời, nó có thể tham gia trực tiếp vào quá trình hoàn thành nhiệm vụ. Tôi quyết định giao cho Hermes một yêu cầu khá gần với công việc hằng ngày: tạo phần mềm Windows để thay đổi kích thước và chuyển đổi định dạng hình ảnh hàng loạt.
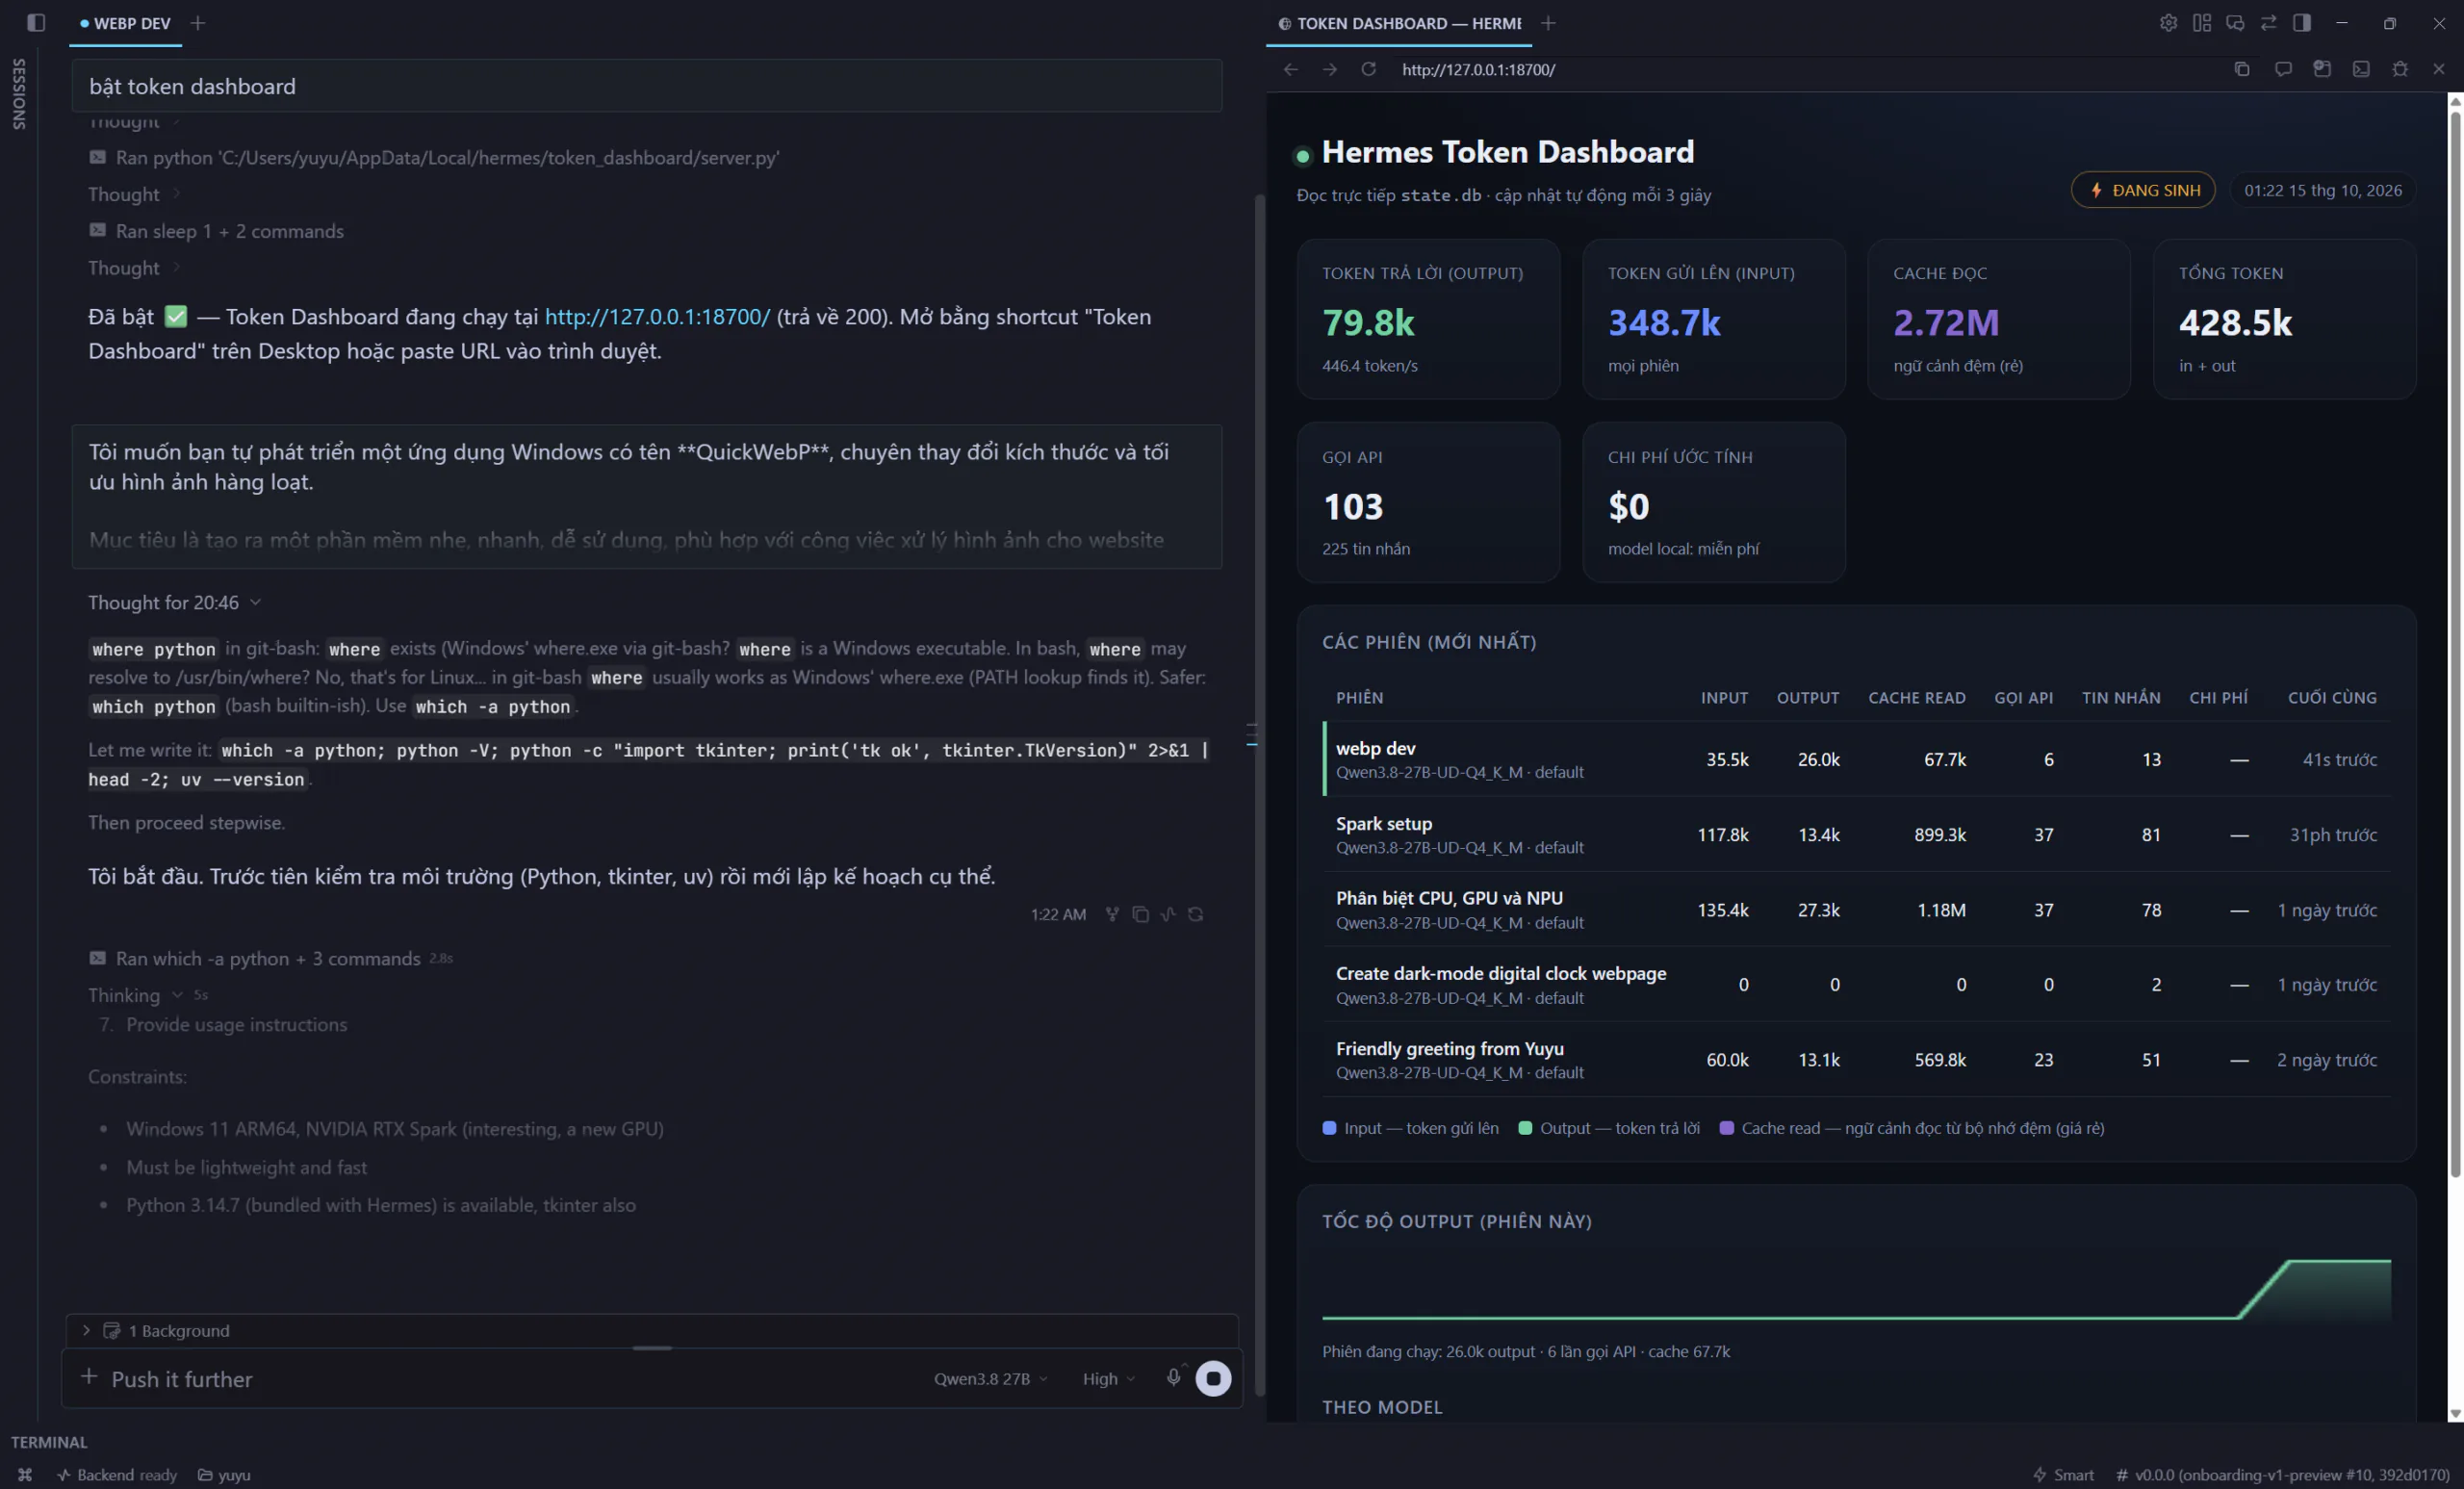
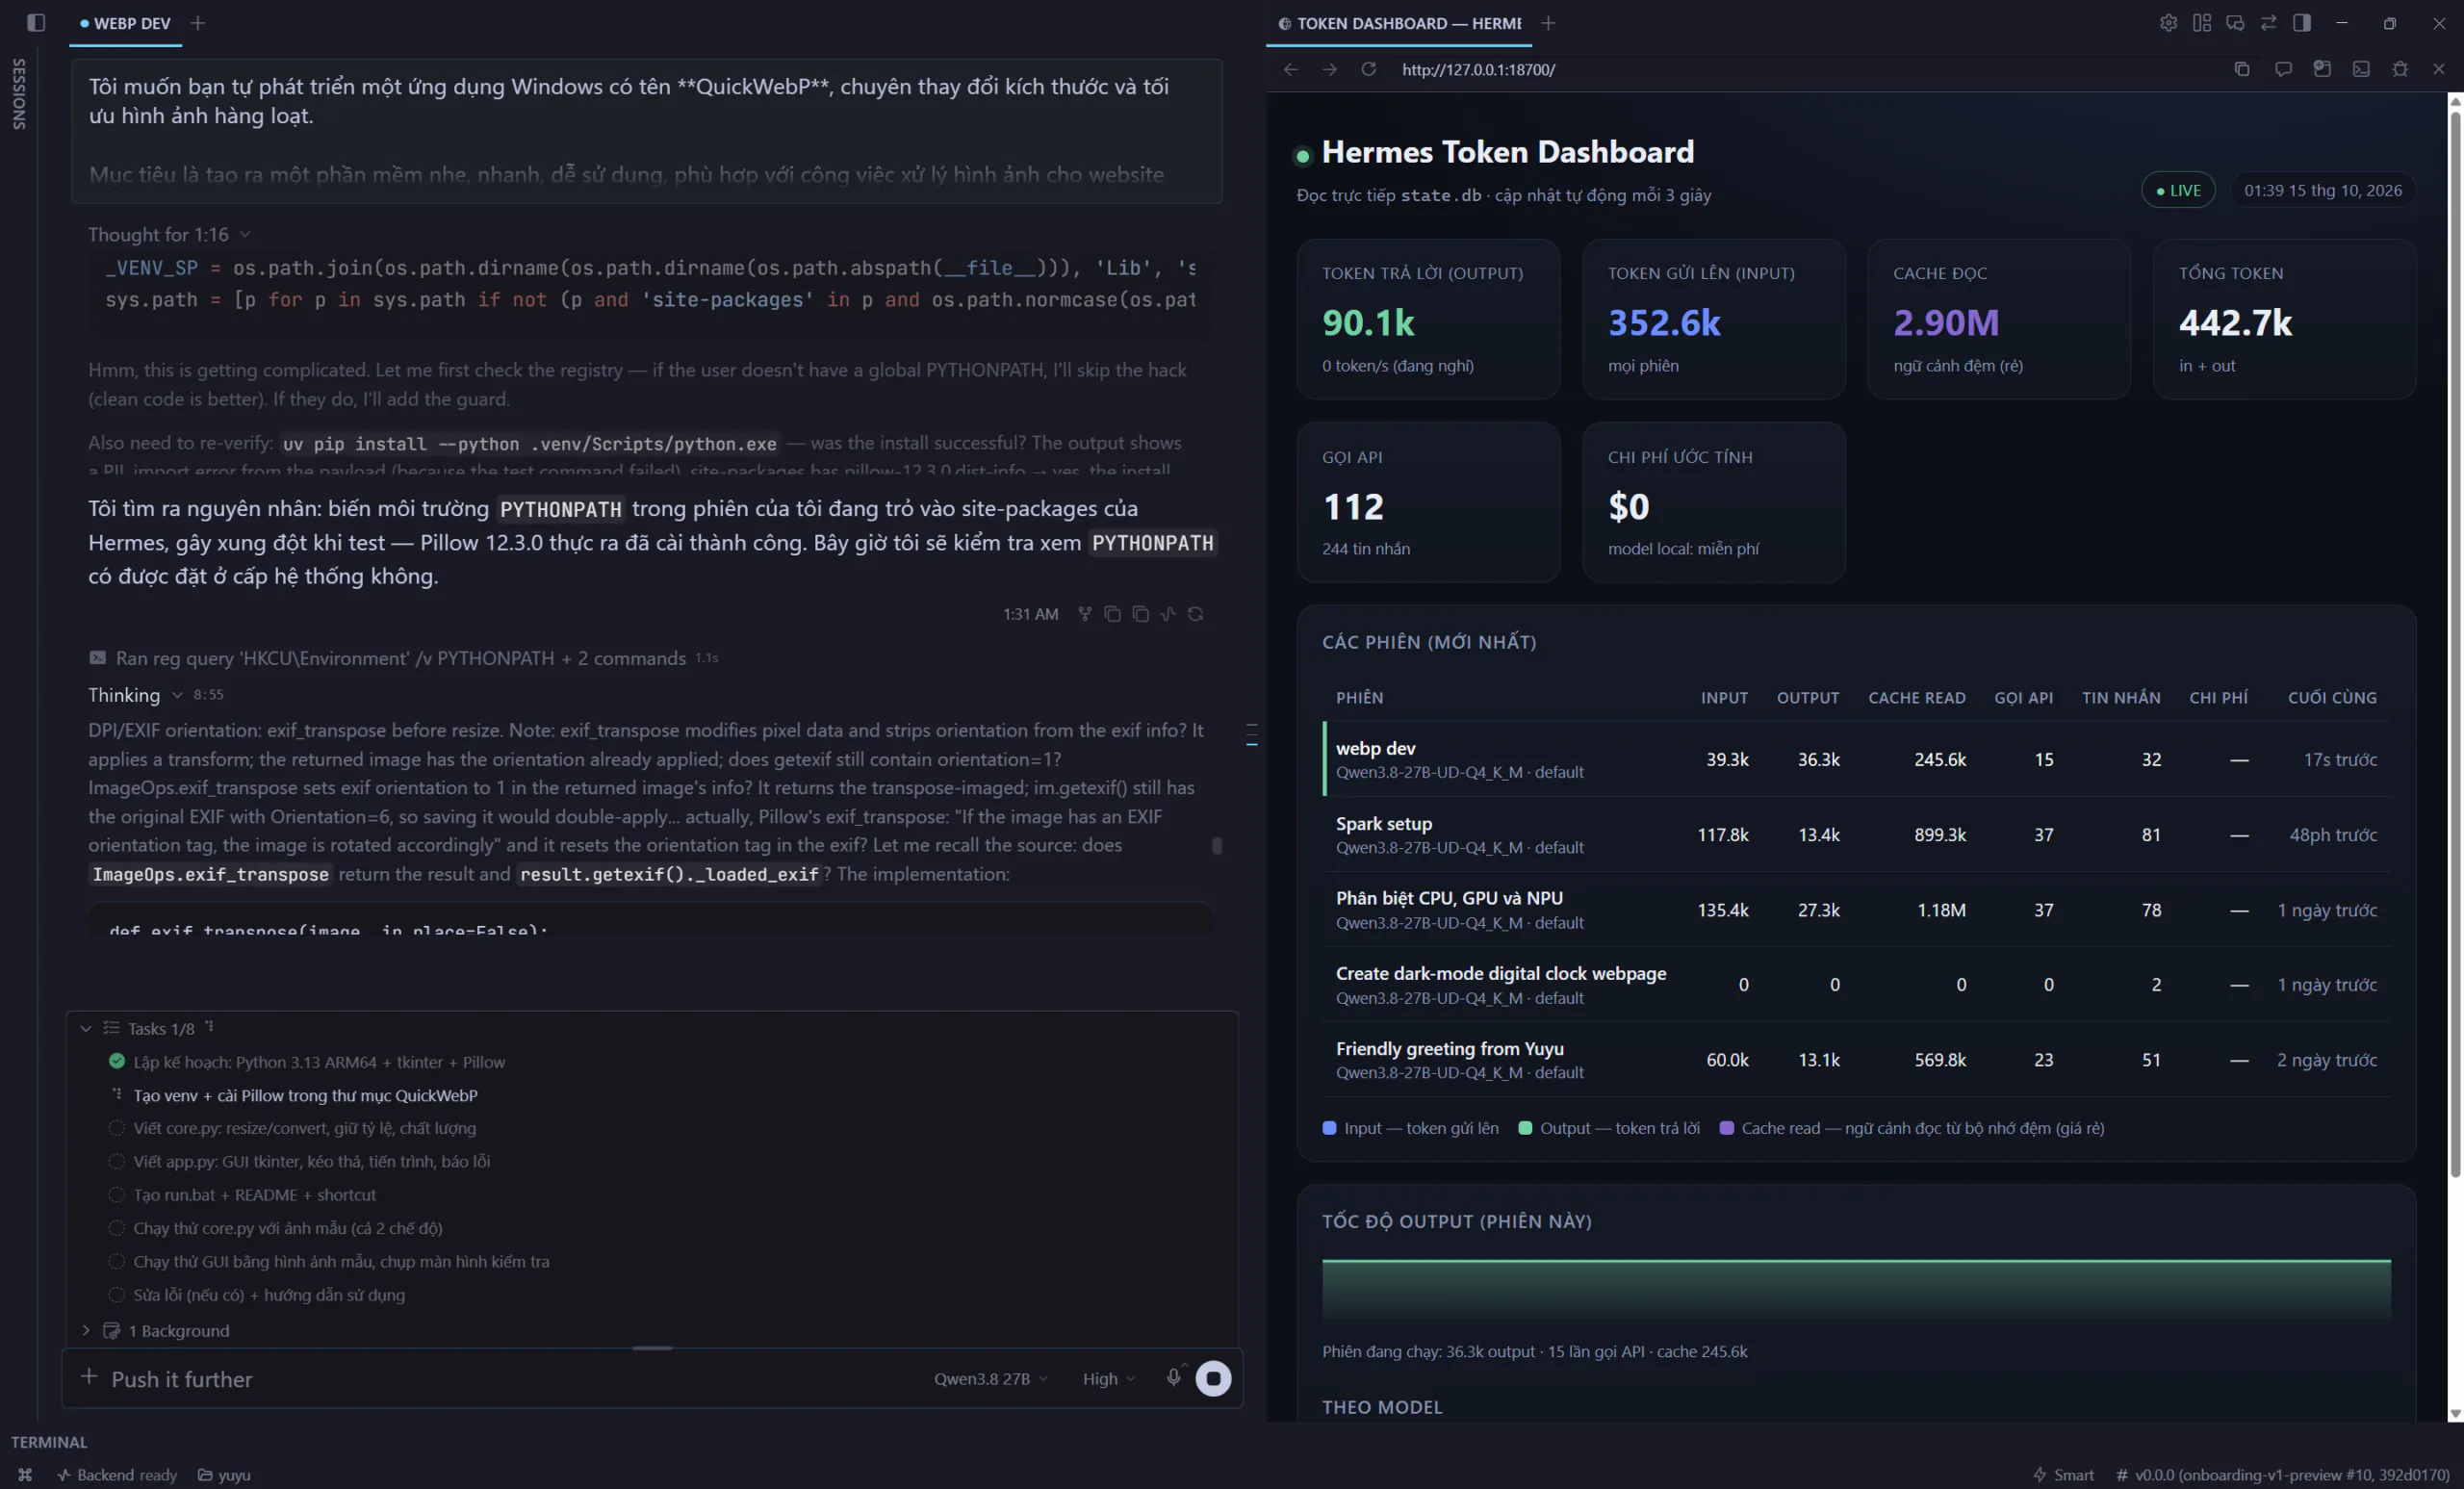
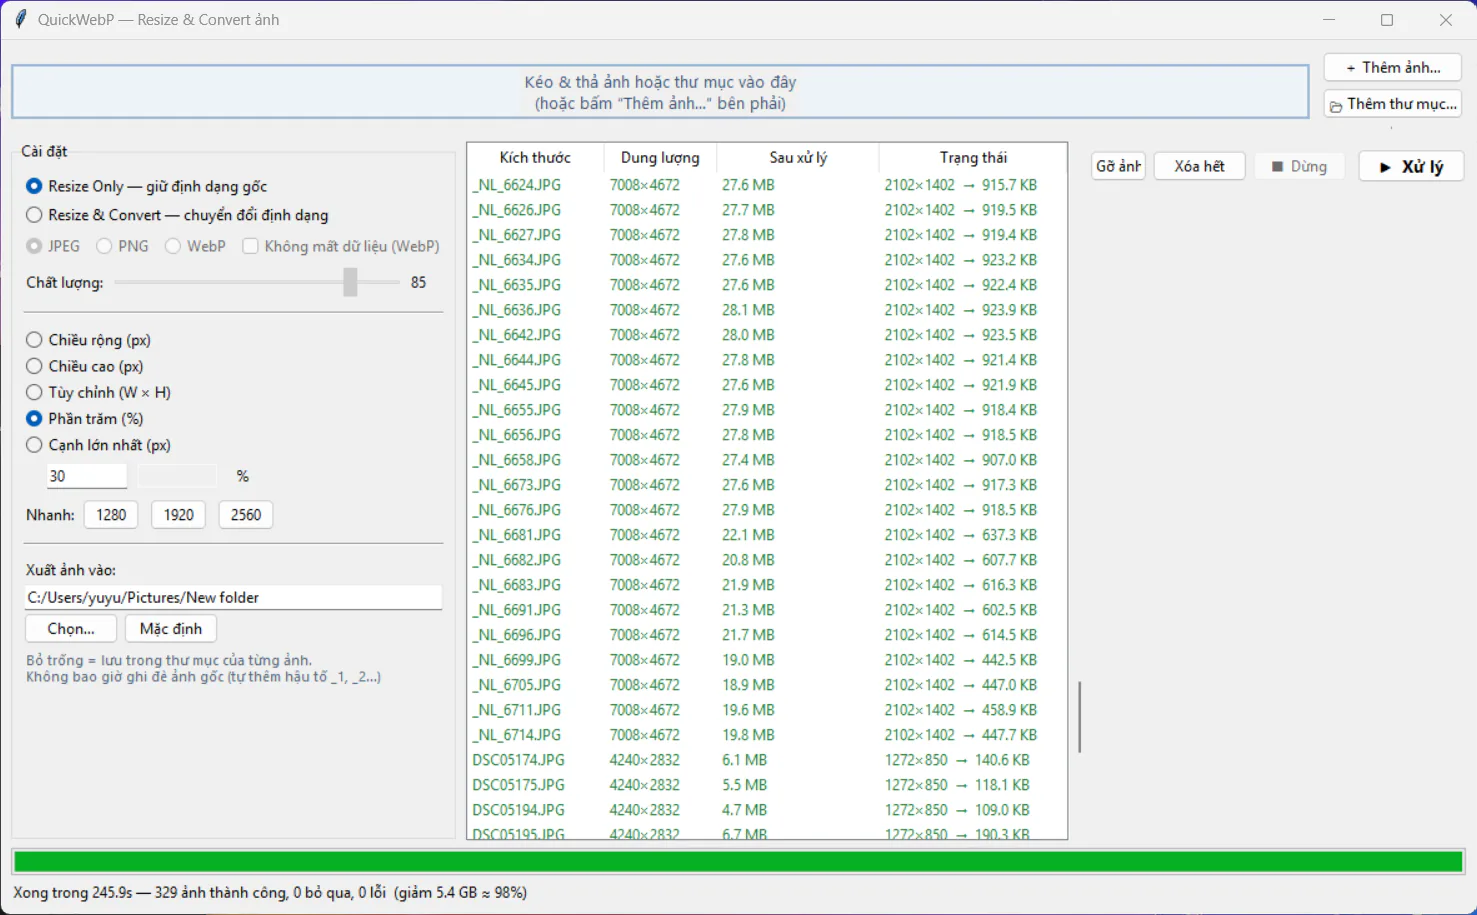
Đây không phải một bài toán quá phức tạp về mặt lập trình, nhưng đủ thực tế để kiểm tra khả năng của AI. Tôi thường xuyên phải xử lý ảnh trước khi đăng bài, từ giảm kích thước đến chuyển sang định dạng phù hợp nhằm tiết kiệm dung lượng lưu trữ. Thay vì tìm kiếm một phần mềm có sẵn, tôi muốn xem AI có thể tự xây dựng một công cụ đáp ứng nhu cầu này hay không. Hermes bắt đầu thực hiện các bước cần thiết và tạo ra một ứng dụng có giao diện đồ họa mang tên QuickWebP.
Phần mềm hỗ trợ thay đổi kích thước nhiều ảnh cùng lúc, giữ nguyên định dạng hoặc chuyển sang JPEG, PNG và WebP. Ngoài ra còn có thanh tiến trình, cơ chế hạn chế ghi đè tệp gốc và sử dụng thuật toán Lanczos khi thay đổi kích thước.
Điều khiến tôi hài lòng là sản phẩm cuối cùng không dừng lại ở một đoạn mã nguồn để tham khảo. QuickWebP có thể mở trên Windows và thực hiện những thao tác xử lý ảnh thực tế. Tôi bắt đầu bằng một bộ ảnh tương đối lớn, gồm 329 tệp với tổng dung lượng khoảng 5,4 GB. Khi thiết lập thu nhỏ ảnh về 30% kích thước ban đầu, QuickWebP hoàn thành công việc trong 245,9 giây, tương đương hơn 4 phút. Tổng dung lượng ảnh đầu ra giảm khoảng 98% và không ghi nhận lỗi trong quá trình xử lý.
Tôi tiếp tục thử chuyển đổi 20 ảnh sang JPEG. Lần này, phần mềm chỉ mất 8,8 giây. Với cùng số lượng ảnh chuyển sang WebP, thời gian xử lý là 12,3 giây.
| Tác vụ QuickWebP | Thời gian | Lỗi |
|---|---|---|
| Xử lý 329 ảnh | 245,9 giây | 0 |
| Chuyển 20 ảnh sang JPEG | 8,8 giây | 0 |
| Chuyển 20 ảnh sang WebP | 12,3 giây | 0 |
Tất nhiên, QuickWebP chưa thể được xem là một phần mềm hoàn thiện ở cấp độ thương mại. Nó vẫn cần được kiểm tra thêm với nhiều định dạng, kích thước ảnh và những tình huống sử dụng khác nhau. Nhưng mục tiêu ban đầu của tôi không phải tạo ra một đối thủ cho các phần mềm xử lý ảnh chuyên nghiệp.
Điều tôi muốn kiểm chứng là liệu AI cục bộ có thể biến một yêu cầu bằng ngôn ngữ tự nhiên thành một công cụ sử dụng được hay không. Và trong trường hợp này, Hermes đã thực hiện được điều đó. Đây là điểm khiến tôi đánh giá cao tiềm năng của AI agent. Thay vì phải tự viết từng dòng mã, người dùng có thể mô tả vấn đề, để AI thực hiện những bước cần thiết, sau đó kiểm tra và điều chỉnh kết quả.
Tuy nhiên, quá trình thử nghiệm cũng bộc lộ một hạn chế đáng chú ý của chiếc ASUS ProArt.
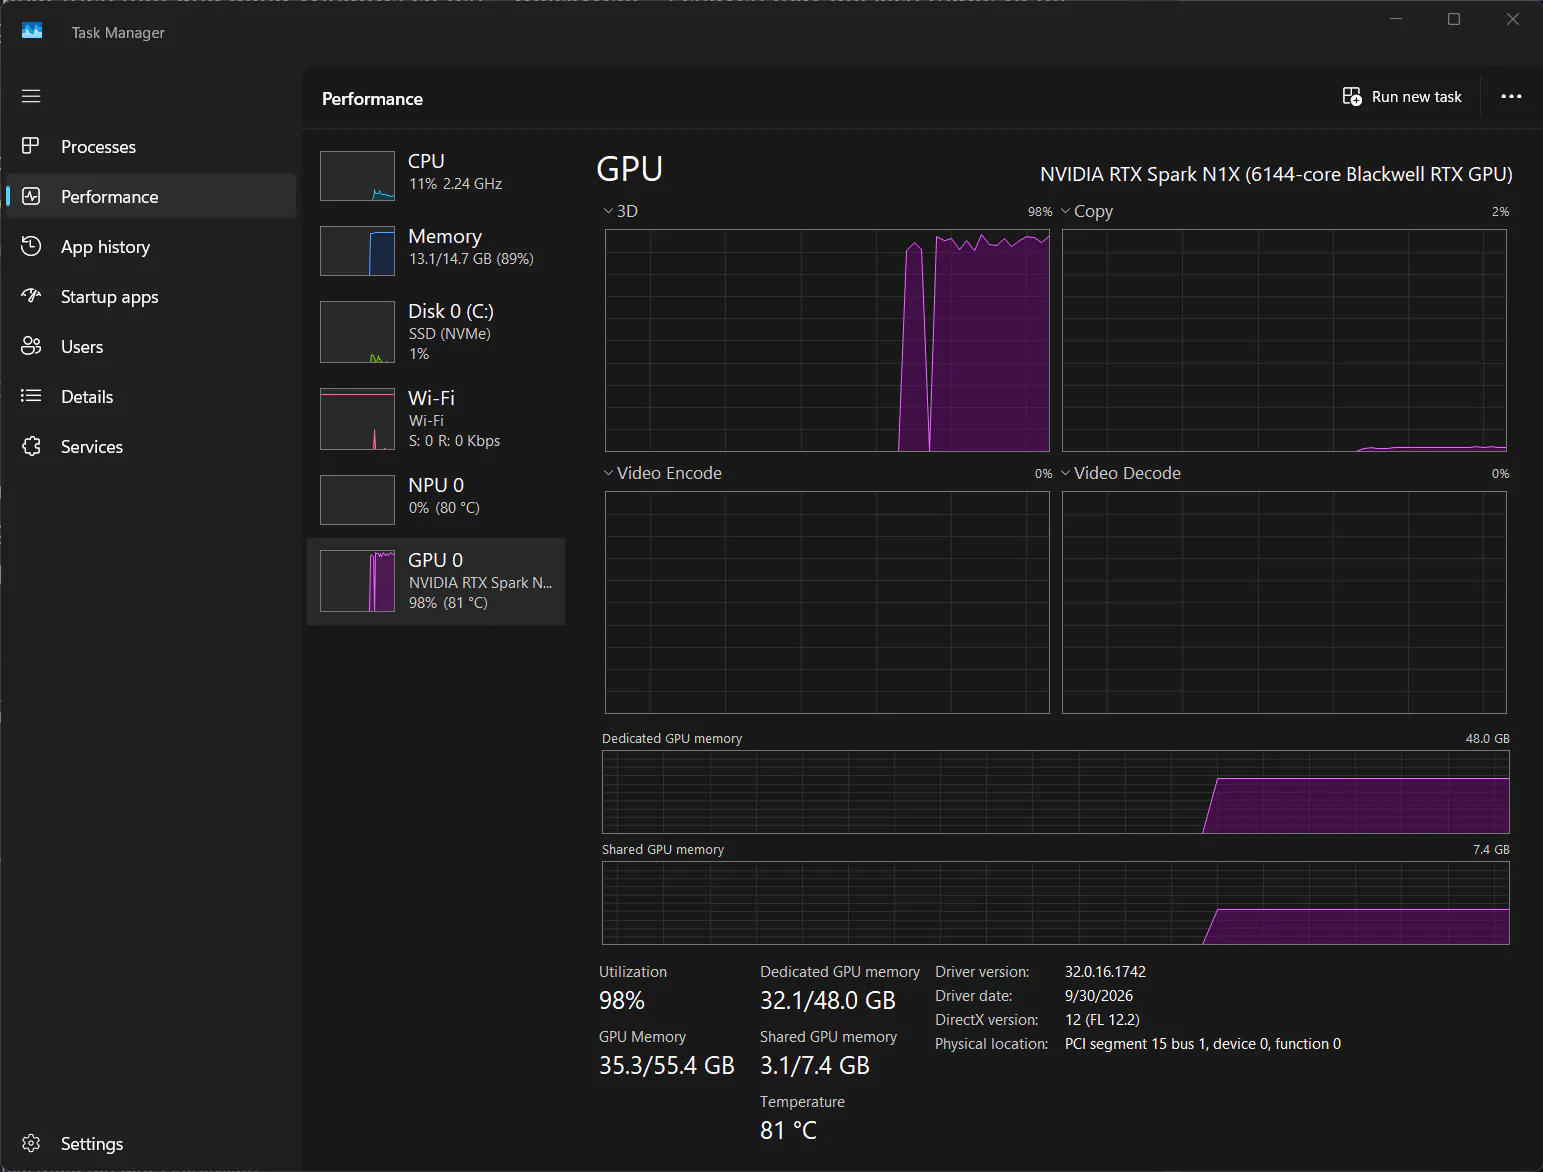
Khi Hermes chạy liên tục để viết và hoàn thiện phần mềm, nhiệt độ GPU có thời điểm đạt 85°C theo thông số hiển thị trong Task Manager. Cùng lúc đó, quạt tản nhiệt hoạt động khá ồn, dễ nhận thấy trong quá trình sử dụng.
Đây là điểm khiến trải nghiệm chưa thực sự thoải mái, nhất là khi AI phải thực hiện những chuỗi công việc kéo dài. Khác với việc gửi một câu hỏi đến dịch vụ AI trực tuyến, chạy mô hình cục bộ đồng nghĩa với việc laptop phải trực tiếp đảm nhận toàn bộ khối lượng tính toán. Dù hệ thống vẫn hoàn thành các tác vụ được giao, mức nhiệt GPU 85°C và tiếng quạt lớn cho thấy hệ thống tản nhiệt trên chiếc ASUS ProArt thử nghiệm phải hoạt động khá vất vả.
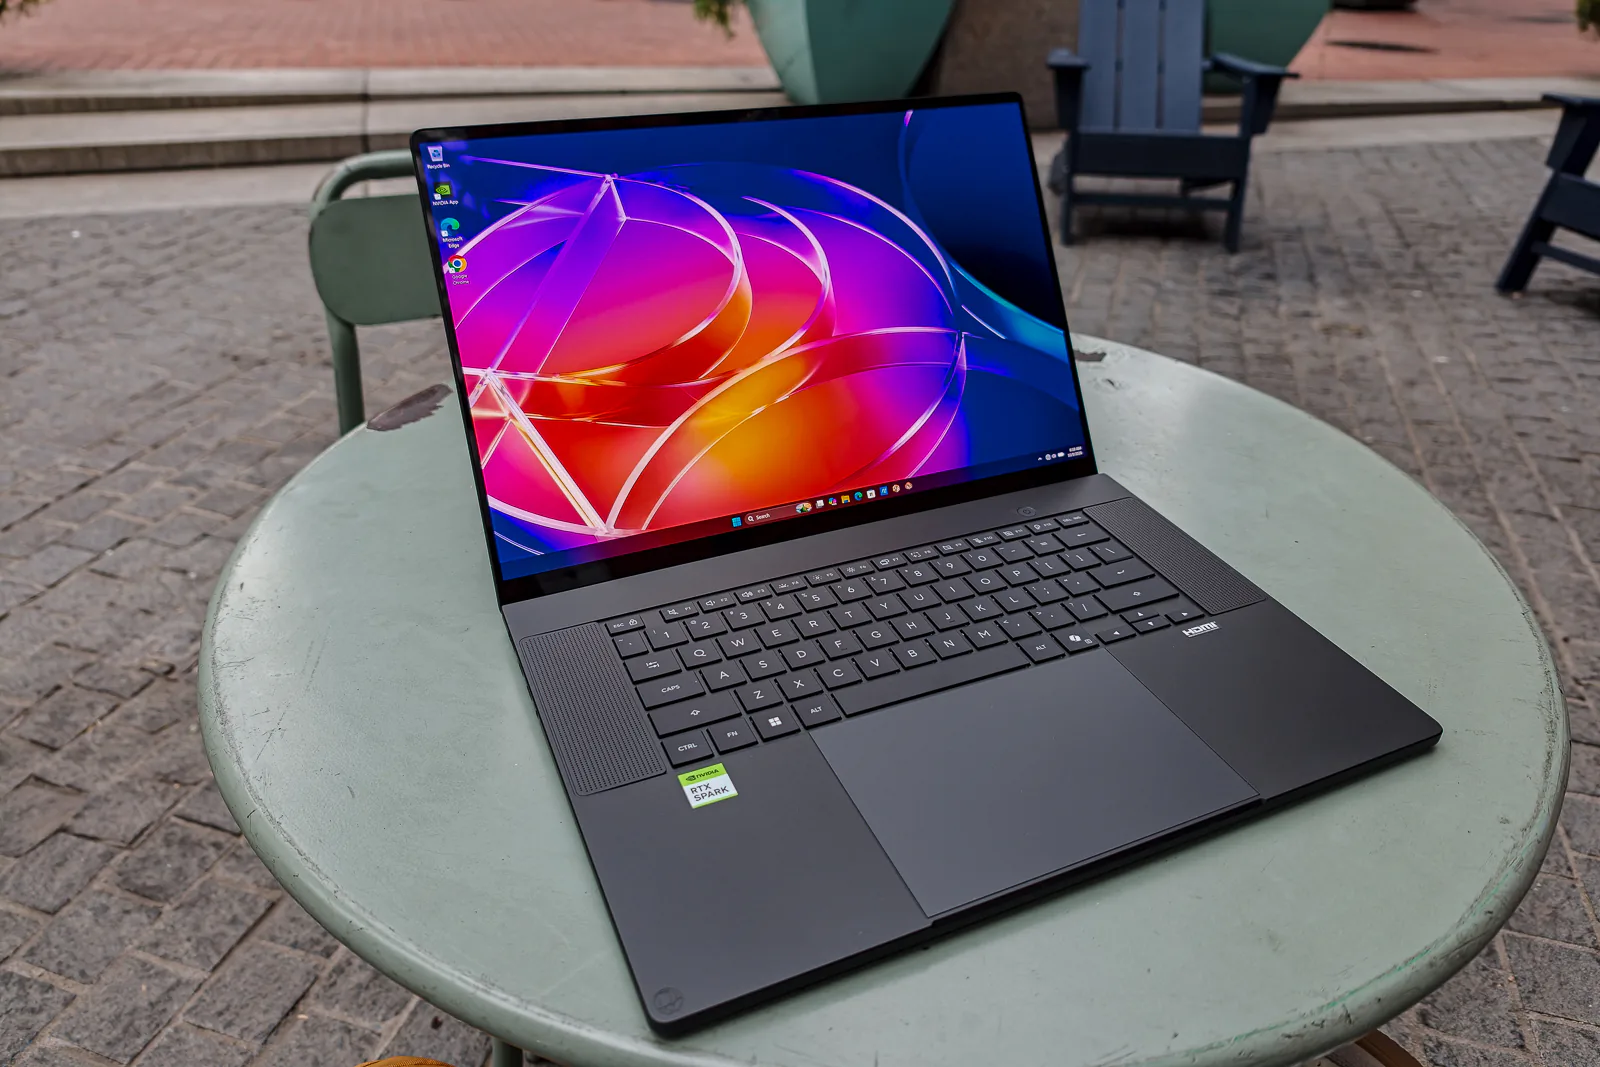
Cũng cần phân biệt rằng đây là nhiệt độ GPU được ghi nhận tại một thời điểm, không phải nhiệt độ bề mặt máy hay kết quả đo trung bình trong toàn bộ quá trình. Chỉ riêng con số 85°C chưa đủ để kết luận phần cứng hoạt động ngoài giới hạn an toàn. Tuy nhiên, xét từ góc độ người sử dụng, tiếng ồn vẫn là một nhược điểm thực tế. Với một chiếc laptop hướng đến các công việc sáng tạo và AI chuyên sâu, ASUS sẽ cần cân bằng tốt hơn giữa hiệu năng, nhiệt độ và độ ồn nếu muốn mang lại trải nghiệm dễ chịu trong thời gian dài.
Ngoài QuickWebP, tôi còn thử yêu cầu Hermes tìm hiểu những công cụ cần thiết để so sánh hai bản hợp đồng PDF hoặc DOCX. AI đã xác định được các công cụ đọc tài liệu và những kỹ năng có thể hỗ trợ việc đối chiếu nội dung, đồng thời chỉ ra một số thư viện còn thiếu và các vấn đề liên quan đến độ chính xác, bảo mật dữ liệu. Tôi dừng thử nghiệm ở bước khảo sát, chưa tiến hành cài đặt thêm thành phần hay so sánh hợp đồng thực tế. Dù vậy, khả năng tự xác định những gì cần chuẩn bị cho một nhiệm vụ mới vẫn là một đặc điểm đáng chú ý.
Hiệu năng đồ họa của RTX Spark N1X
Dù AI là trọng tâm của bài trải nghiệm, tôi vẫn muốn kiểm tra khả năng đồ họa của RTX Spark N1X.
GPU Blackwell với 6.144 nhân CUDA không chỉ phục vụ suy luận AI mà còn có thể đảm nhận những tác vụ dựng hình truyền thống. Vì vậy, tôi sử dụng 3DMark để có thêm dữ liệu tham khảo.
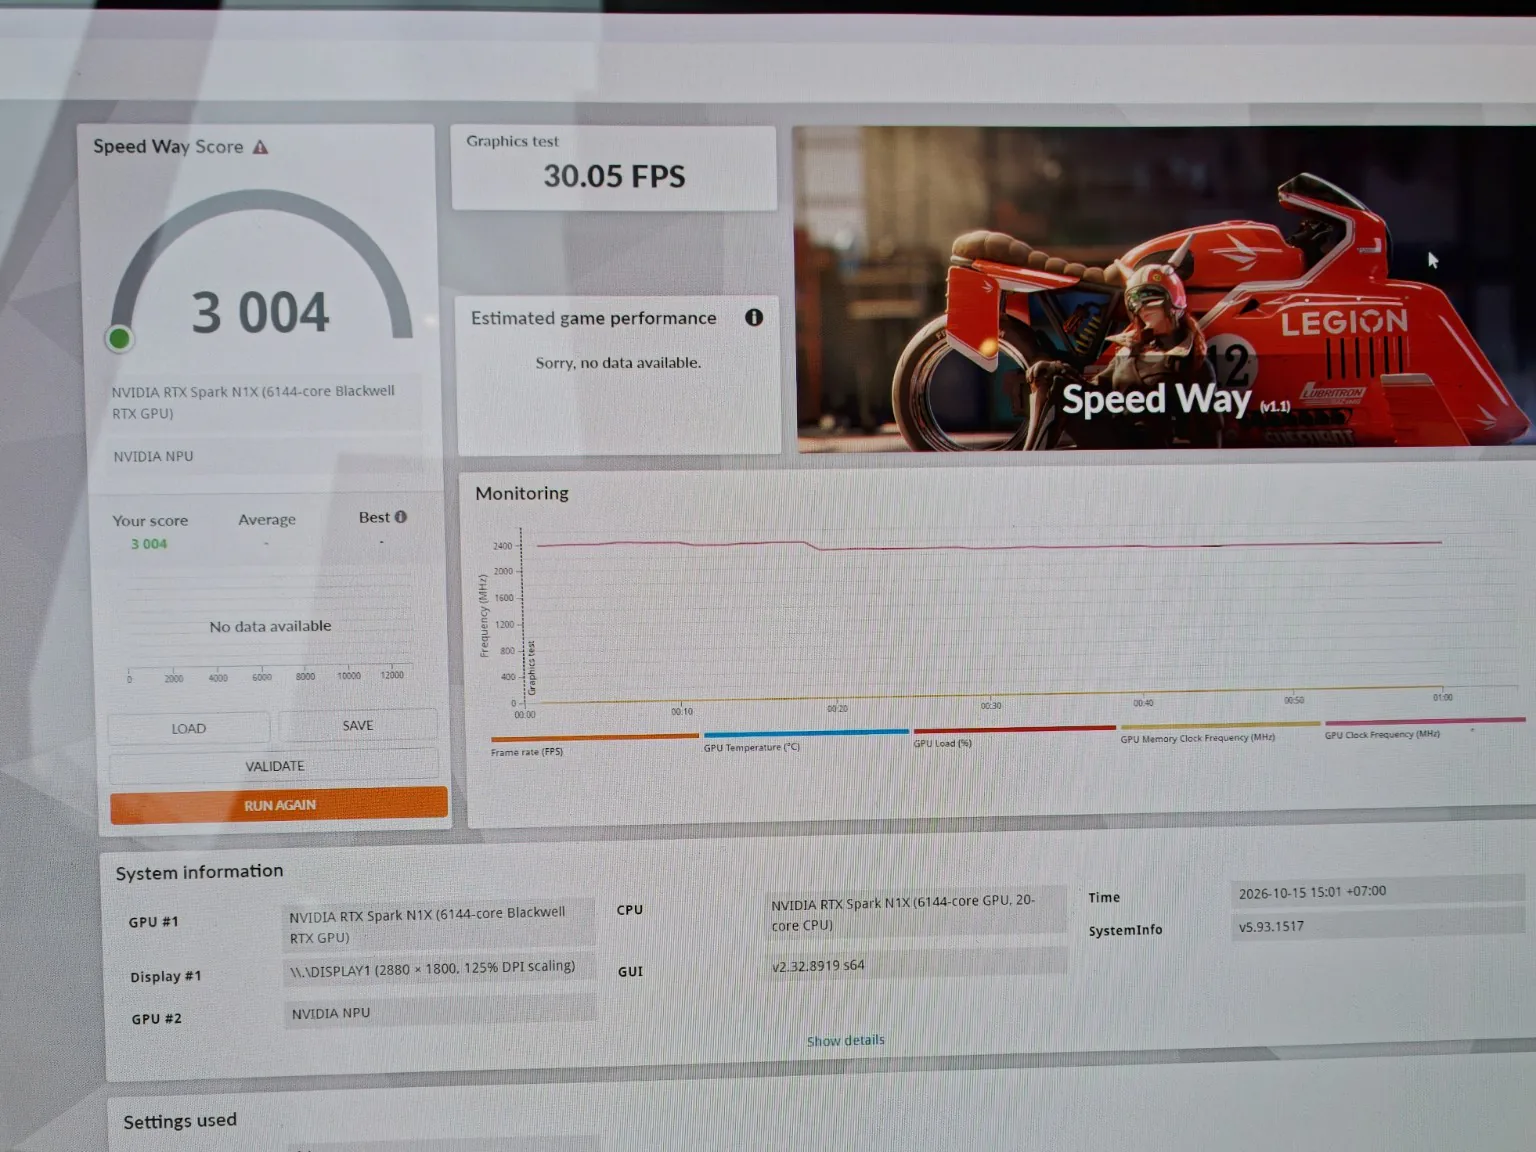
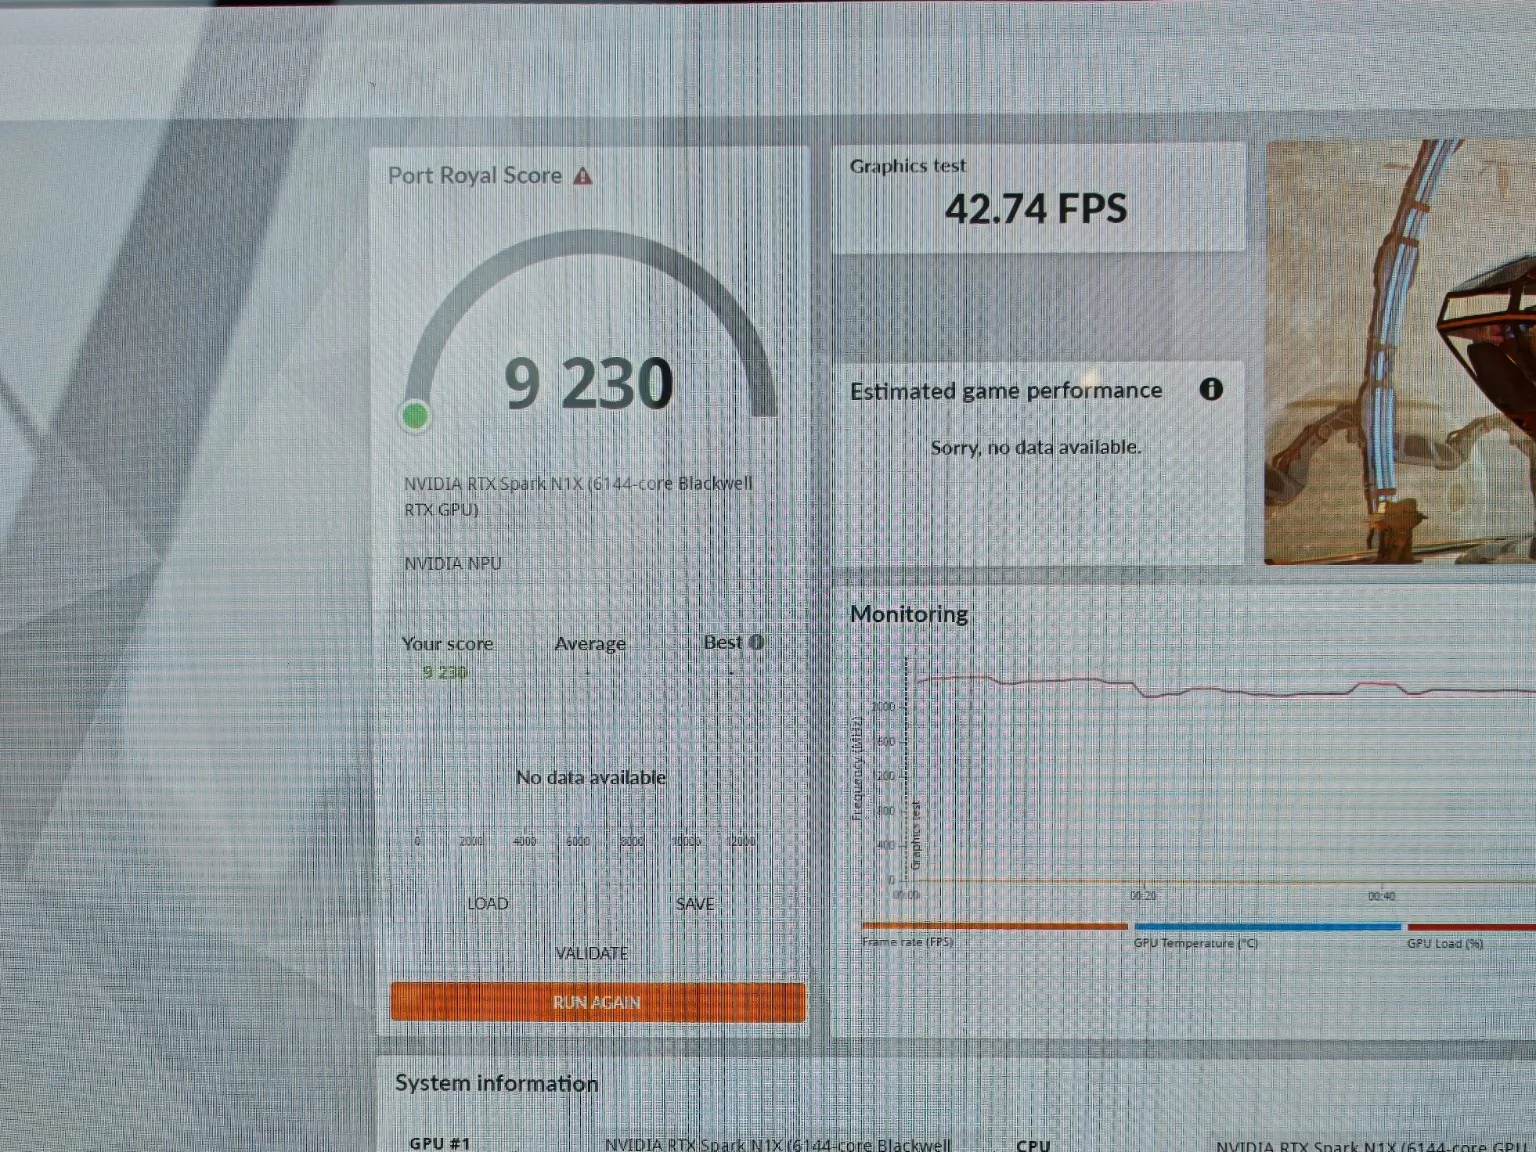
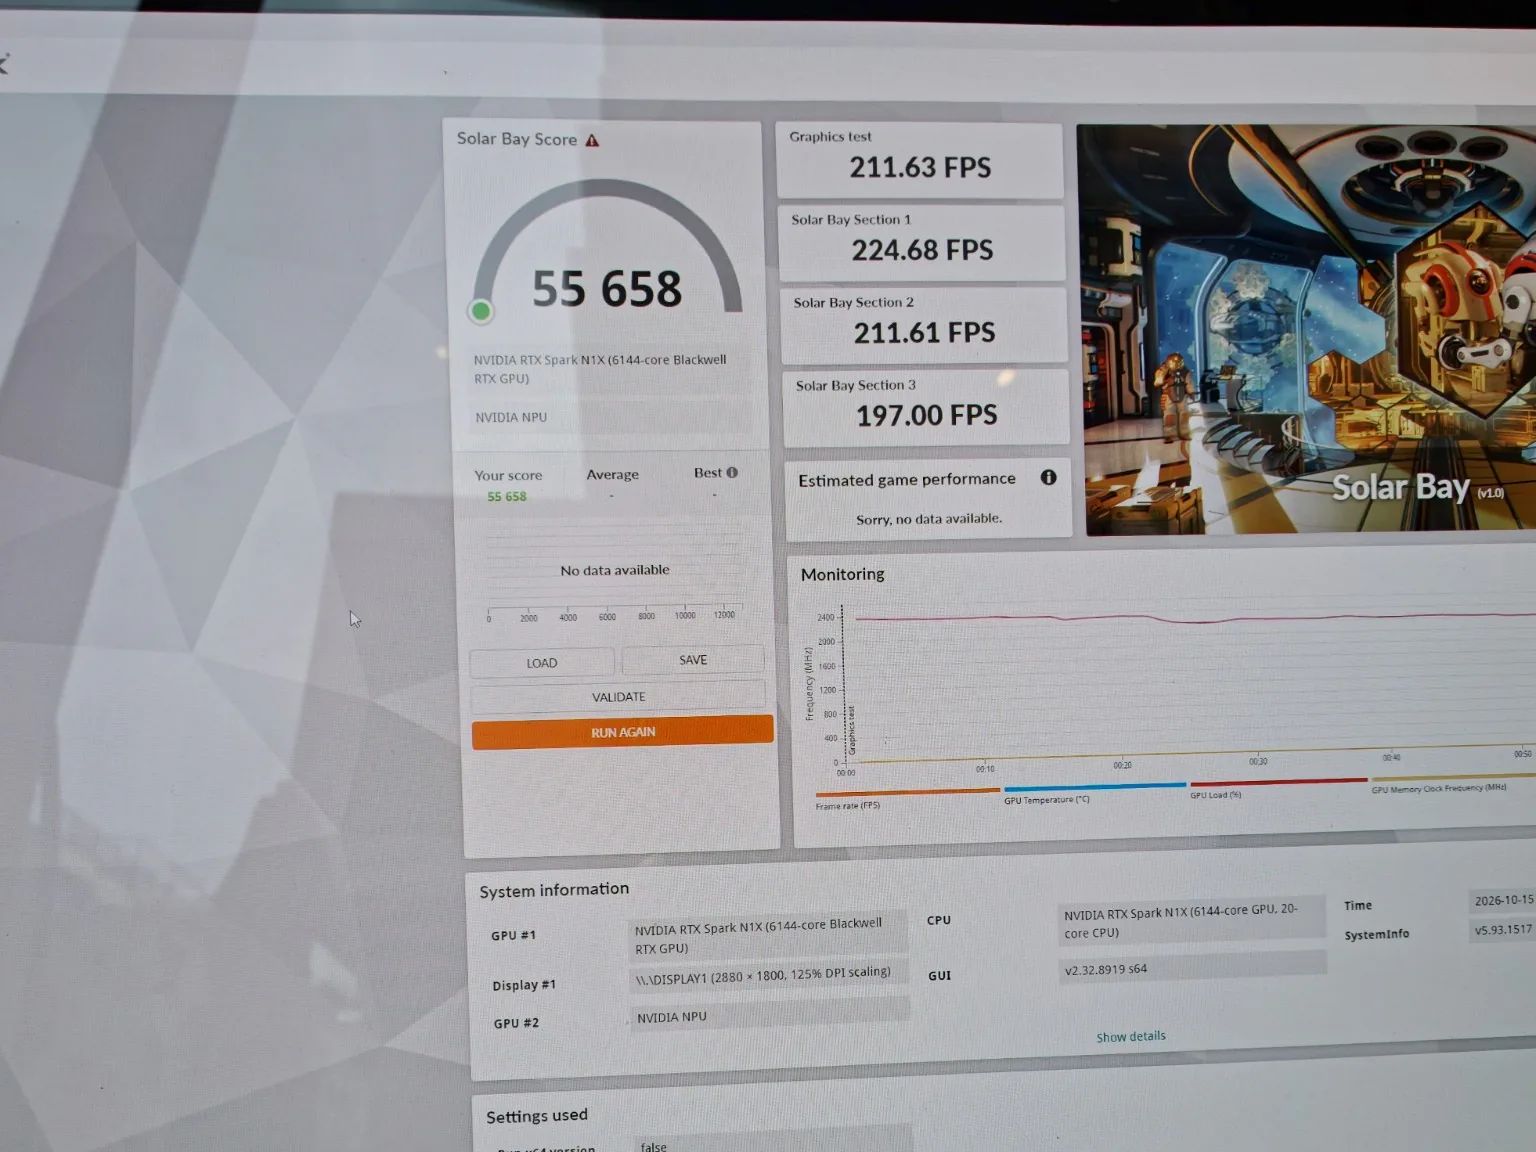
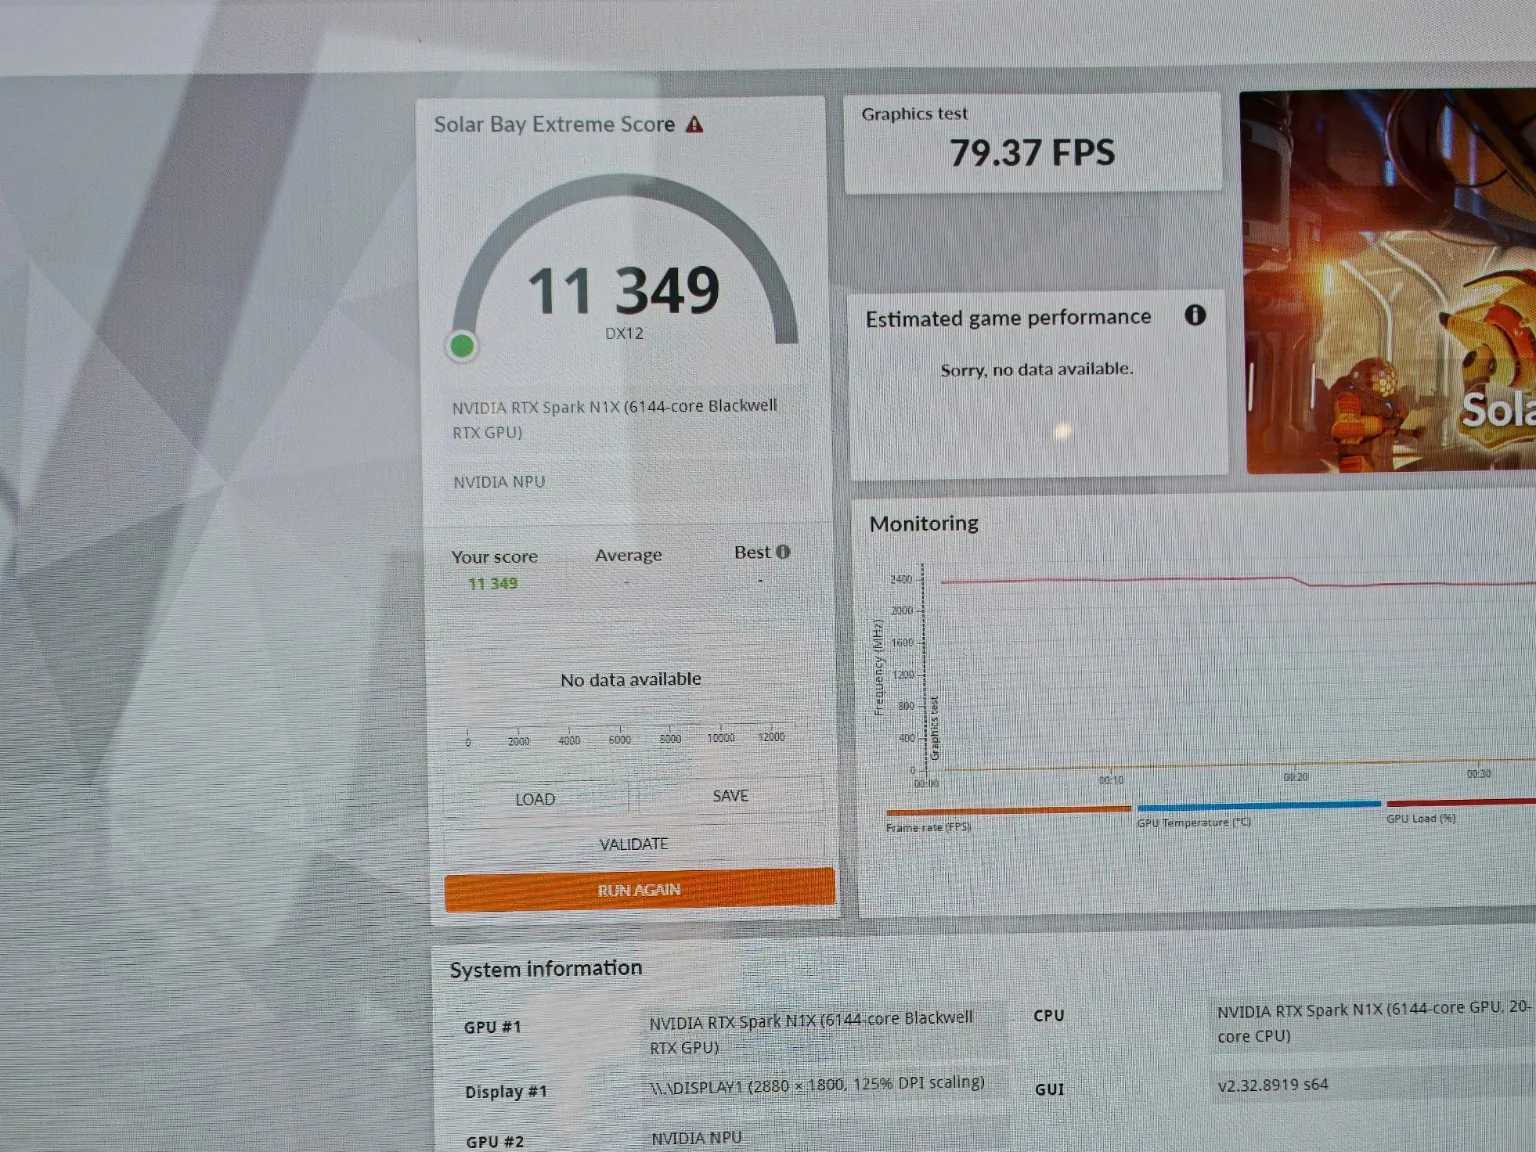
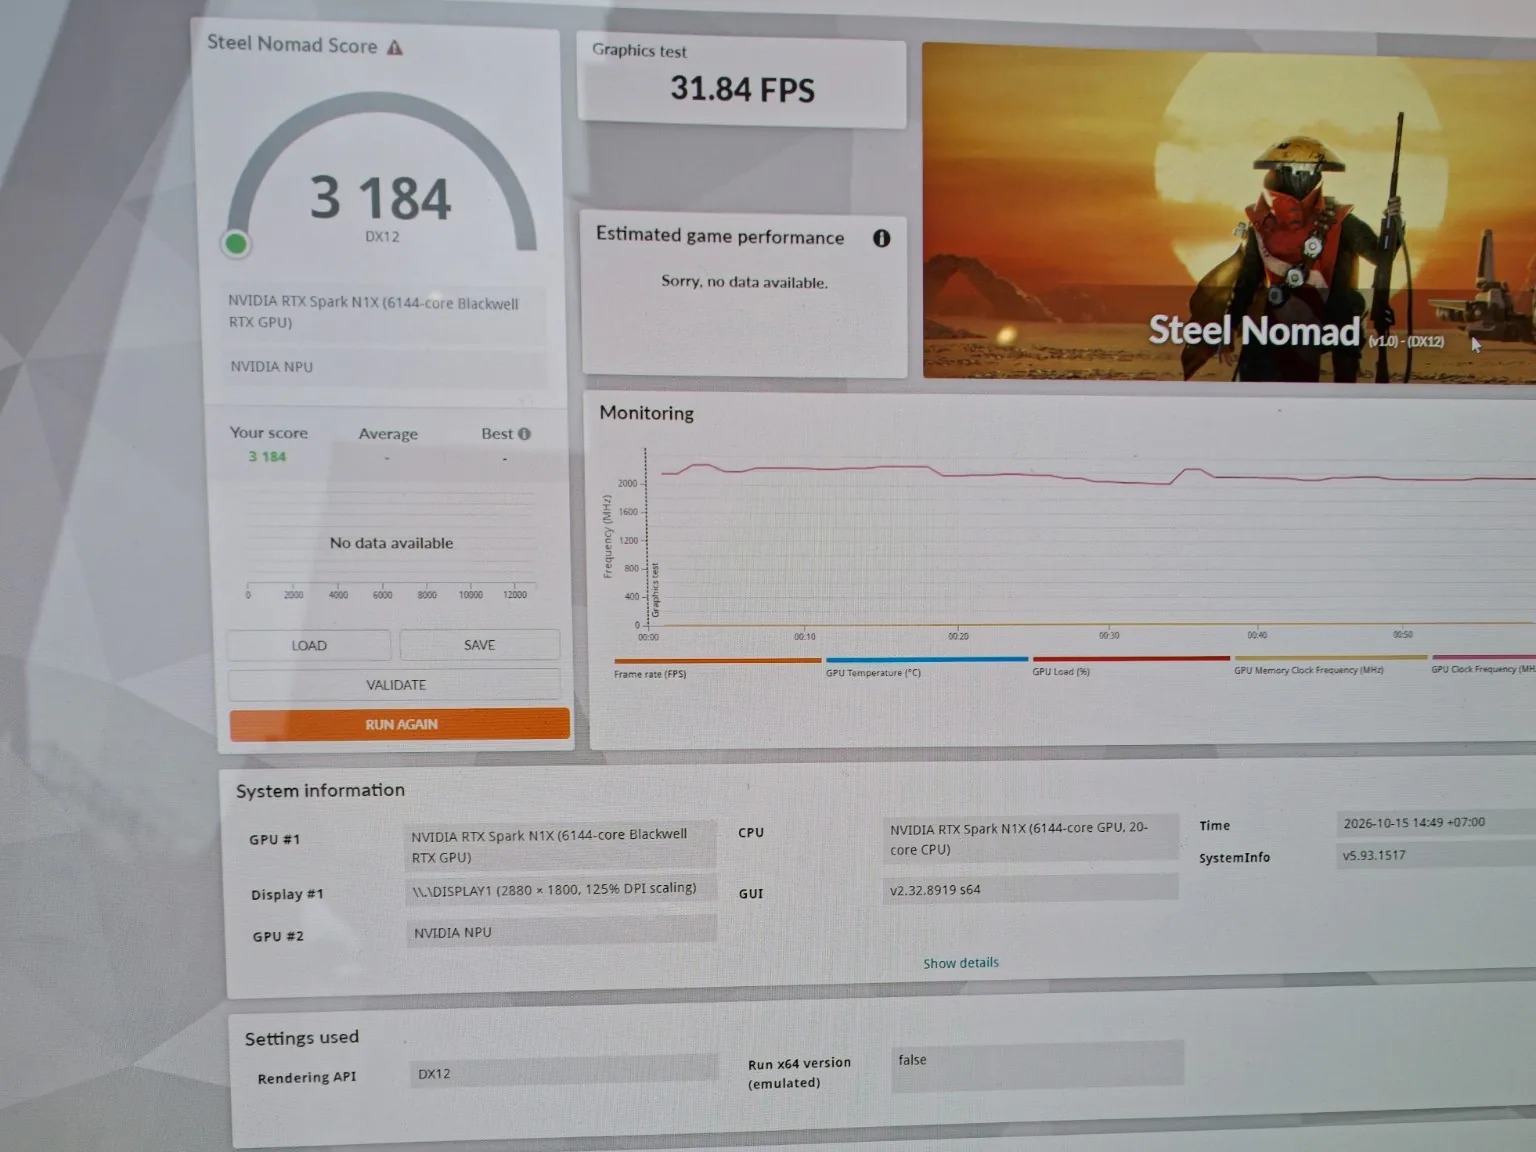
Các bài kiểm tra được lựa chọn gồm Port Royal, Solar Bay, Solar Bay Extreme, Steel Nomad và Speed Way.
| Bài kiểm tra | Điểm 3DMark | FPS |
|---|---|---|
| Solar Bay | 55.658 | 211,63 |
| Solar Bay Extreme | 11.349 | 79,37 |
| Port Royal | 9.230 | 42,74 |
| Steel Nomad | 3.184 | 31,84 |
| Speed Way | 3.004 | 30,05 |
Trong hai lần chạy Solar Bay, hệ thống đạt lần lượt 55.529 và 55.658 điểm. Tôi sử dụng kết quả cao hơn để tổng hợp vào bảng.
Cần lưu ý rằng các bài 3DMark có phương pháp đo và khối lượng xử lý khác nhau. Vì vậy, không thể lấy điểm Solar Bay so sánh trực tiếp với Port Royal hay Steel Nomad để kết luận bài nào thể hiện hiệu năng tốt hơn.
Port Royal và Speed Way tập trung vào những khối lượng đồ họa có dò tia, trong khi Steel Nomad là bài kiểm tra đồ họa nặng hơn theo phương pháp dựng hình truyền thống. Các kết quả cho thấy RTX Spark N1X có khả năng xử lý nhiều dạng tác vụ đồ họa hiện đại. Tuy nhiên, đối với một nền tảng mới sử dụng Windows ARM64, trải nghiệm thực tế còn phụ thuộc vào mức độ tương thích và tối ưu của từng ứng dụng.
Đó cũng là lý do tôi tiếp tục kiểm tra bằng một trò chơi cụ thể thay vì chỉ dựa vào benchmark tổng hợp. Cyberpunk 2077 là một lựa chọn phù hợp để thử nghiệm khả năng đồ họa, bởi trò chơi có nhiều thiết lập chất lượng hình ảnh và hỗ trợ những công nghệ dựng hình mới của NVIDIA.
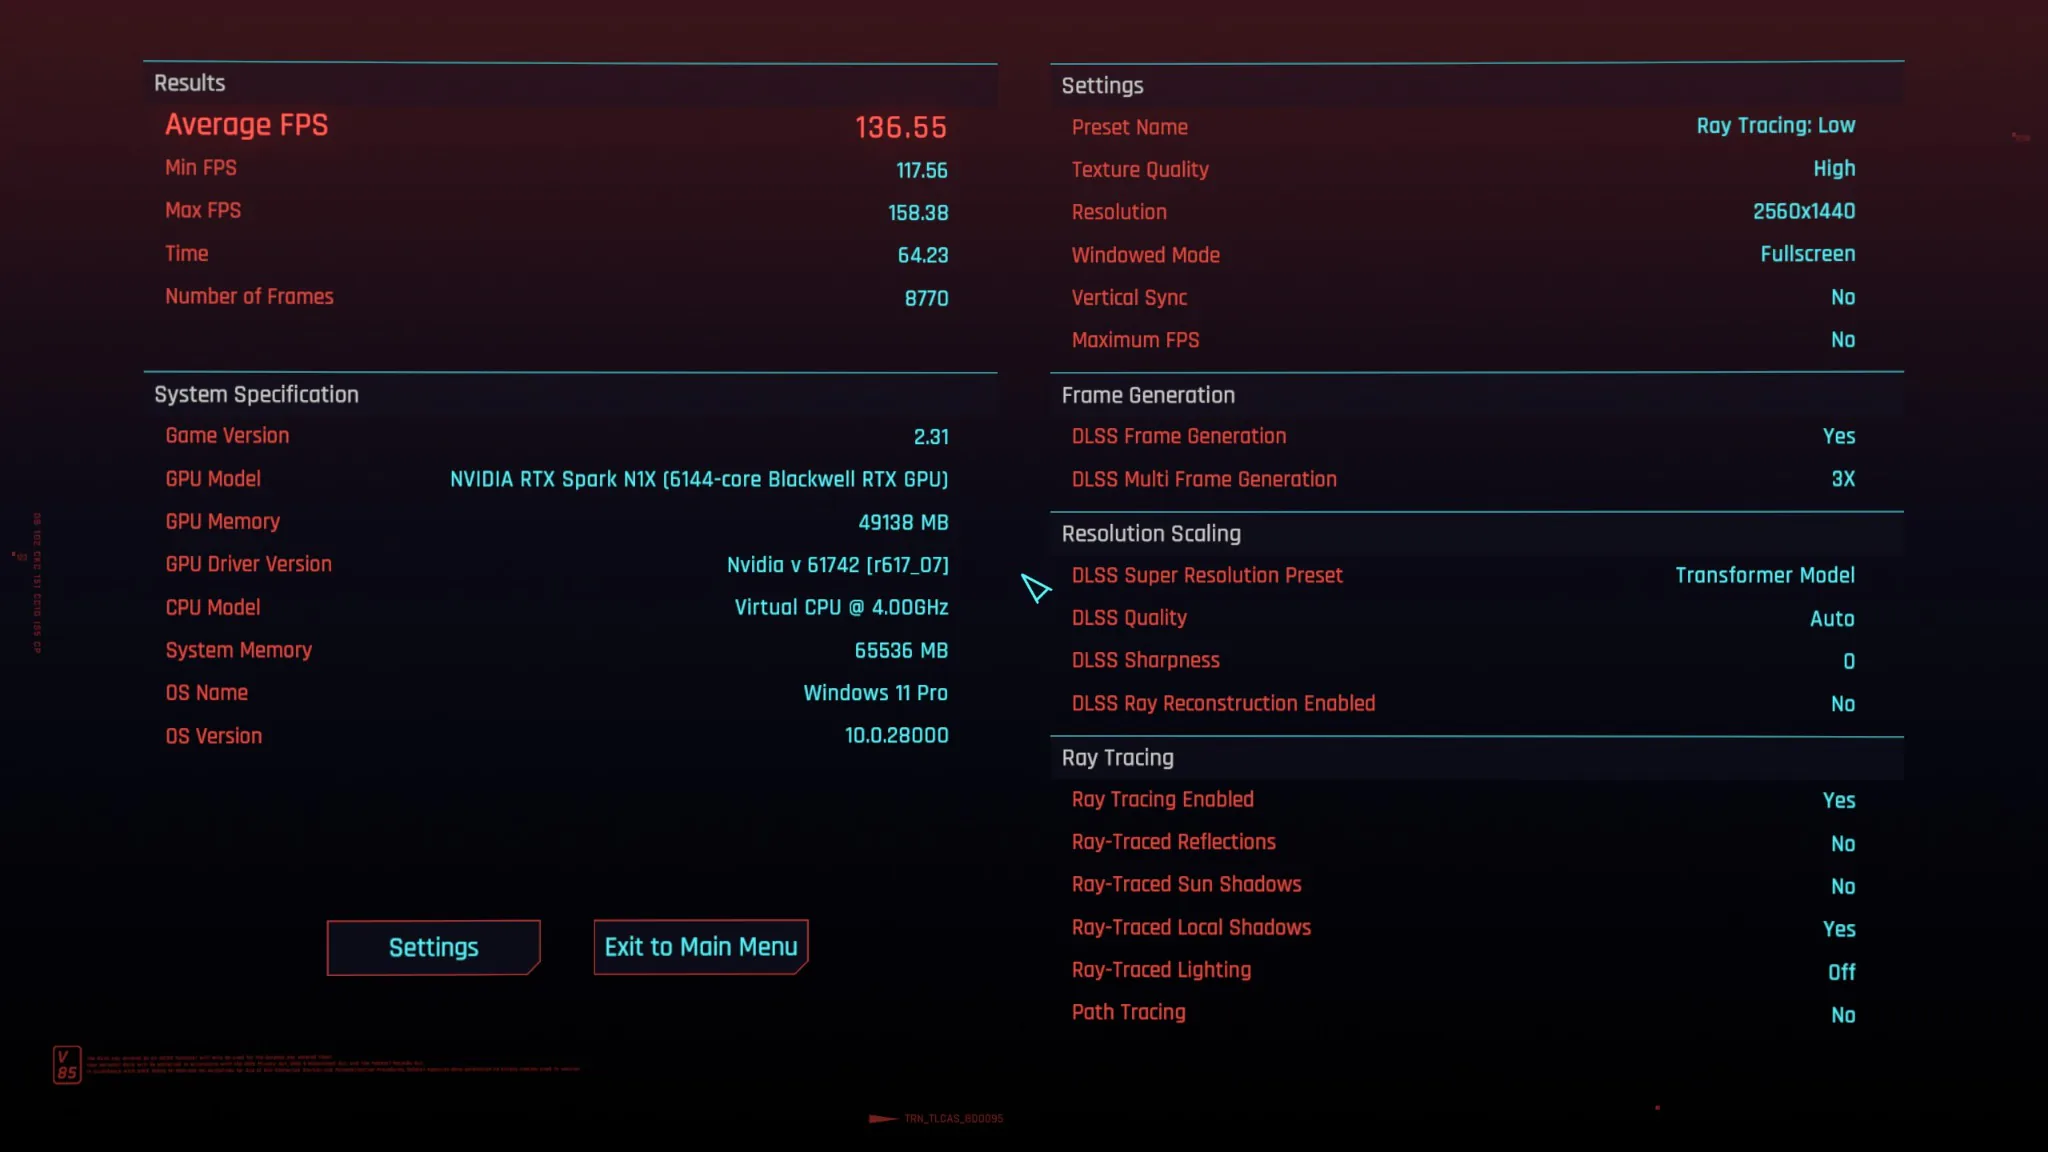
Tôi thực hiện benchmark ở độ phân giải 2.560 × 1.440 pixel, chế độ toàn màn hình, thiết lập Ray Tracing Low và chất lượng kết cấu High. DLSS được đặt ở chế độ Quality với mô hình Transformer. Đồng thời, tôi bật DLSS Multi Frame Generation ở mức 3X. Kết quả ghi nhận tốc độ khung hình trung bình 136,55 FPS, thấp nhất 117,56 FPS và cao nhất 158,38 FPS.
| Cyberpunk 2077 | Kết quả |
|---|---|
| Độ phân giải | 2.560 × 1.440 |
| Ray Tracing | Low |
| Texture Quality | High |
| DLSS | Quality |
| Multi Frame Generation | 3X |
| FPS trung bình | 136,55 |
| FPS thấp nhất | 117,56 |
| FPS cao nhất | 158,38 |
Đây là kết quả khá ấn tượng về số khung hình hiển thị. Tuy nhiên, tôi cho rằng cần nhìn nhận đúng vai trò của DLSS Multi Frame Generation.
Khi công nghệ tạo khung hình được bật, một phần FPS đến từ những khung hình do AI tạo ra, thay vì toàn bộ đều được GPU dựng theo cách truyền thống. Vì vậy, mức trung bình 136,55 FPS không đồng nghĩa với việc GPU có thể dựng hình gốc ở tốc độ tương ứng. Trải nghiệm điều khiển còn chịu ảnh hưởng bởi độ trễ và tốc độ xử lý những khung hình thực.
Dù vậy, đây vẫn là một ví dụ đáng chú ý về cách NVIDIA khai thác AI để cải thiện trải nghiệm đồ họa. Những công nghệ như DLSS giúp mở rộng khả năng của GPU, đặc biệt khi thiết bị phải cân bằng giữa hiệu năng, điện năng tiêu thụ và giới hạn tản nhiệt.
Ở góc độ sử dụng thực tế, tôi xem khả năng chơi game là một giá trị bổ sung của RTX Spark N1X, thay vì mục tiêu chính của nền tảng này.
Người dùng quan tâm đến RTX Spark nhiều khả năng sẽ dành phần lớn thời gian cho AI, lập trình hoặc sáng tạo nội dung. Tuy nhiên, việc vẫn có thể sử dụng GPU để chơi những tựa game hiện đại giúp chiếc laptop trở nên đa dụng hơn.
RTX Spark có thể thay đổi cách sử dụng laptop như thế nào?
Sau những bài thử nghiệm, điều khiến tôi suy nghĩ nhiều nhất là cách AI cục bộ có thể thay đổi mối quan hệ giữa người dùng và máy tính.
Trong mô hình sử dụng AI phổ biến hiện nay, người dùng thường mở một trang web hoặc ứng dụng, gửi yêu cầu đến máy chủ rồi nhận câu trả lời. Mọi thứ tương đối đơn giản, nhưng khả năng kiểm soát mô hình và quy trình xử lý thường bị giới hạn bởi dịch vụ đang sử dụng.
Với AI cục bộ, người dùng có thể chủ động hơn trong việc lựa chọn mô hình, cấu hình hệ thống và kết hợp các công cụ để giải quyết một công việc cụ thể.
Thử nghiệm Hermes là ví dụ rõ ràng nhất. Tôi không cần yêu cầu AI giải thích cách viết phần mềm xử lý ảnh. Thay vào đó, tôi giao một nhiệm vụ và để AI tham gia trực tiếp vào quá trình tạo ra công cụ đáp ứng nhu cầu. Đó là sự khác biệt đáng kể giữa việc sử dụng AI như một công cụ hỏi đáp và sử dụng AI như một trợ lý có khả năng thực hiện công việc.
Tuy nhiên, trải nghiệm cũng cho thấy AI cục bộ chưa phải giải pháp chỉ cần cài đặt là mọi thứ sẽ hoạt động tối ưu.Hiệu năng phụ thuộc nhiều vào mô hình, phương thức suy luận và phần mềm sử dụng. Bài thử AgentPerf cho thấy thay đổi cấu hình có thể rút ngắn thời gian xử lý hơn 30%, dù phần cứng không thay đổi.
Bên cạnh đó, Windows ARM64 đòi hỏi người dùng quan tâm hơn đến khả năng tương thích của những ứng dụng chuyên dụng. Một số công cụ có thể cần phiên bản phù hợp hoặc thêm bước thiết lập trước khi khai thác được GPU. Về phía phần cứng, nhiệt độ và tiếng ồn cũng là những yếu tố không nên bỏ qua. Trải nghiệm trên ASUS ProArt cho thấy khi chạy AI liên tục, hệ thống tản nhiệt phải làm việc với cường độ cao hơn đáng kể so với những tác vụ văn phòng thông thường.
Điều này đặc biệt quan trọng với người dùng muốn sử dụng laptop như một máy trạm AI cá nhân. Khả năng chạy được mô hình lớn là một chuyện, còn duy trì trải nghiệm thoải mái trong nhiều giờ lại là một yêu cầu khác.
Kết luận
Sau thời gian trải nghiệm, tôi cho rằng NVIDIA RTX Spark N1X là một nền tảng đáng chú ý, không chỉ vì cấu hình phần cứng mà còn bởi những khả năng AI cục bộ mà nó mang lại. Bộ nhớ hợp nhất dung lượng lớn giúp laptop tiếp cận những mô hình ngôn ngữ hàng chục tỉ tham số. GPU Blackwell hỗ trợ nhiều công cụ AI và vẫn đáp ứng được những bài kiểm tra đồ họa hiện đại.
Nếu chỉ xét những con số benchmark, RTX Spark N1X có thể được nhìn nhận như một nền tảng CPU và GPU mới. Nhưng sau khi trực tiếp sử dụng AI để xây dựng một phần mềm Windows, tôi cho rằng giá trị thú vị hơn nằm ở khả năng biến chiếc laptop thành một môi trường làm việc AI độc lập.
Đó cũng là điều khiến tôi muốn tiếp tục khám phá RTX Spark: không chỉ xem nó xử lý nhanh đến đâu, mà còn tìm hiểu những công việc nào trước đây cần nhiều thao tác thủ công nay có thể được AI thực hiện ngay trên máy.