Home Blog Page 2

Qualcomm bác bỏ tin đồn Snapdragon 8 Elite Extreme Gen 6 bị quá nhiệt

0

Hôm qua, một trang tin Hàn Quốc đã chia sẻ những thông tin đáng lo ngại về mẫu Samsung Galaxy S27 Ultra sắp ra mắt. Theo báo cáo này, Samsung đang cân nhắc việc sử dụng toàn bộ chip Exynos vào năm tới, bởi các bài thử nghiệm nội bộ cho thấy vi xử lý Snapdragon 8 Elite Extreme Gen 6 mới ra mắt đang gặp tình trạng nhiệt độ quá cao, dẫn đến hiện tượng thermal throttling (bóp hiệu năng do nhiệt). Ngược lại, Exynos 2700 lại đang thể hiện phong độ rất ổn định.

Lời đáp trả mạnh mẽ từ Qualcomm

Ngay khi tin đồn này lan truyền rộng rãi trên internet, Giám đốc Marketing (CMO) của Qualcomm đã trực tiếp phản hồi trên một bài đăng của nền tảng X, khẳng định những thông tin trên là hoàn toàn sai lệch. Cụ thể, ông chia sẻ:
“Những báo cáo gần đây về vấn đề nhiệt độ liên quan đến Snapdragon 8 Elite Extreme Gen 6 là không chính xác. Chúng tôi tự hào về những đổi mới và động lực phát triển mạnh mẽ phía sau nền tảng flagship thế hệ tiếp theo của mình, đồng thời tiếp tục hợp tác chặt chẽ với các đối tác OEM toàn cầu để mang đến những trải nghiệm người dùng cao cấp nhất.”
Vị lãnh đạo này cũng làm rõ thêm rằng SoC mới không hề gặp phải bất kỳ lỗi hệ thống nào liên quan đến vấn đề tản nhiệt. Ông cho rằng những tin đồn xoay quanh kết quả thử nghiệm nội bộ của Samsung nhiều khả năng là thiếu chính xác, bởi các đối tác OEM luôn chủ động tinh chỉnh nền tảng của họ nhằm đạt được sự cân bằng giữa hiệu năng và mức tiêu thụ điện năng tùy thuộc vào từng kịch bản sử dụng khác nhau. Do đó, những thông tin rò rỉ từ phòng thí nghiệm của Samsung có thể đã bị hiểu sai hoặc truyền đạt gây nhầm lẫn.
Qualcomm bác bỏ tin đồn Snapdragon 8 Elite Extreme Gen 6 bị quá nhiệt 1

Sức mạnh quá lớn cho một hệ thống tản nhiệt thụ động?

Giới công nghệ hiện vẫn chưa có cơ hội thử nghiệm thực tế bất kỳ thiết bị nào chạy vi xử lý tối tân nhất của Qualcomm để đưa ra nhận định cuối cùng. Tuy nhiên, nếu nhìn lại những thế hệ trước, việc chip Snapdragon 8 Elite Extreme Gen 6 tỏa ra lượng nhiệt lớn không phải là điều quá khó tin.
Qualcomm denies rumors about Snapdragon 8 Elite Extreme Gen 6 overheating
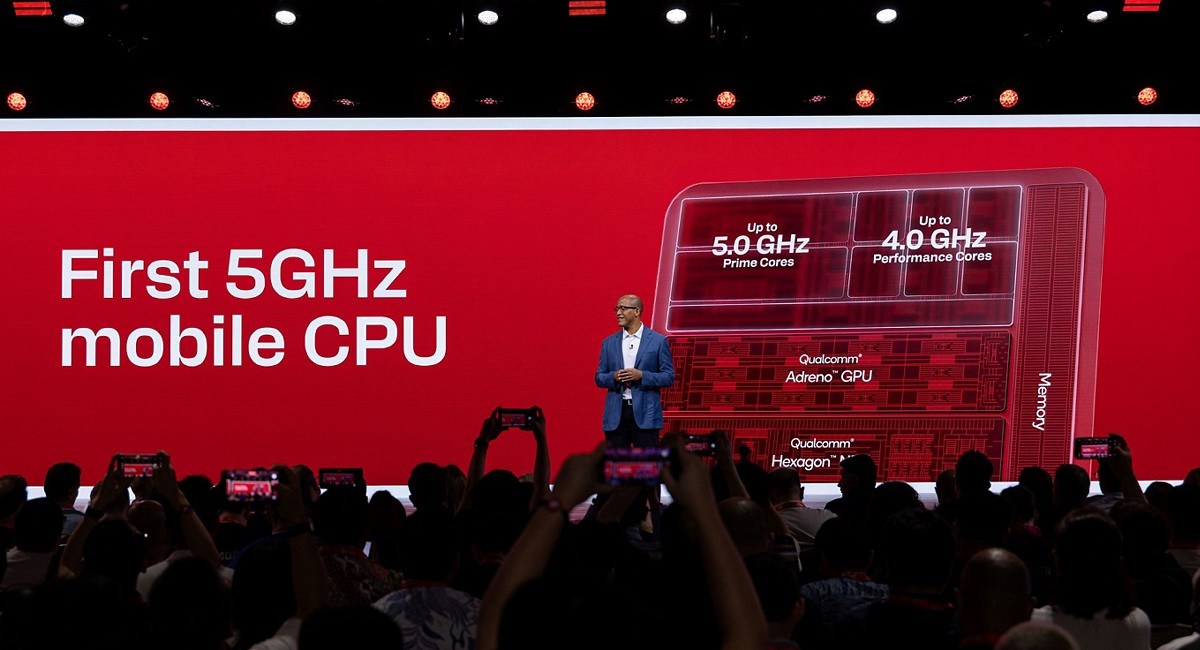
Các dòng chip di động gần đây đã trở nên mạnh mẽ đến mức, về mặt lý thuyết, chúng hoàn toàn đủ khả năng gánh vác các tựa game ngang tầm PC. Dòng chipset Snapdragon 8 Elite Gen 6 hiện tại sở hữu hai nhân Prime với xung nhịp chạm ngưỡng 5.0 GHz, cùng sáu nhân Performance chạy ở mức 4.0 GHz. Đây là một khối lượng tính toán khổng lồ đối với bất kỳ hệ thống tản nhiệt thụ động (passive cooling) nào.
Kể từ khi thế hệ Snapdragon 8 Elite đầu tiên trình làng, các bài kiểm tra stress test trên những chiếc flagship hiện đại thường ghi nhận sự sụt giảm đáng kể về hiệu năng duy trì (sustained performance). Điều này không đồng nghĩa với việc máy sẽ bị quá nhiệt trong quá trình sử dụng thông thường, nhưng nó là một dấu hiệu rõ ràng cho thấy các vi xử lý di động đang dần trở nên quá mạnh mẽ so với giới hạn vật lý của chính chúng.
Nguồn: gsmarena

Galaxy S27 Ultra gặp lỗi với Snapdragon 8 Elite Extreme Gen 6

0

Theo các rò rỉ từ những bài kiểm tra hiệu năng nội bộ, Exynos 2700 đã đánh bại Snapdragon 8 Elite Extreme Gen 6 khi ghi nhận điểm số multi-core trên Geekbench cao hơn khoảng 10%. Và hoạt động ổn định hơn trên Galaxy S27 Ultra.

Trong quá trình thử nghiệm mẫu Galaxy S27 Ultra sắp ra mắt, Samsung phát hiện ra rằng Snapdragon 8 Elite Extreme Gen 6 đã vượt quá các ngưỡng nhiệt độ an toàn và bắt đầu xảy ra hiện tượng throttling khi phải gánh các tác vụ nặng trong thời gian dài.
Hiện tại, thị trường đã có một vài mẫu điện thoại được trang bị dòng chip Extreme, nhưng các nhà sản xuất từ Trung Quốc thường có xu hướng sử dụng hệ thống tản nhiệt vapor chamber hầm hố hơn nhiều so với tiêu chuẩn thông thường của Samsung. Dù vậy, Samsung và Qualcomm hiện đang nỗ lực hợp tác để giải quyết dứt điểm vấn đề này. Theo các báo cáo, Samsung đã ra thời hạn cho Qualcomm đến giữa tháng này để tìm ra giải pháp. Mặc dù hiện tại đã là giữa tháng 10 và các tin đồn thường xuất hiện với một độ trễ nhất định, nhưng thông tin mới nhất từ các nguồn tin nội bộ cho biết vẫn chưa có biện pháp khắc phục nào được đưa ra.
Tình trạng này đã buộc Samsung phải đánh giá lại tiềm năng của Exynos 2700. Quá trình sản xuất hàng loạt cho dòng Galaxy S27 dự kiến sẽ bắt đầu vào cuối năm nay, đảm bảo hãng có đủ nguồn hàng sẵn sàng cho đợt ra mắt truyền thống vào tháng 2 hoặc tháng 3. Điều này đồng nghĩa với việc quyết định cuối cùng sẽ phải được đưa ra trong thời gian sớm nhất.
Snapdragon 8 Elite Extreme Gen 6
Một chi tiết vẫn chưa được làm rõ trong báo cáo là liệu sự cố này có dẫn đến chiến lược phân chia thị trường hay không – tức là một số khu vực sẽ nhận được S27 Ultra chạy Snapdragon, trong khi các khu vực khác sử dụng bản Exynos – hay Samsung sẽ loại bỏ hoàn toàn Snapdragon để sử dụng độc quyền con chip nội bộ của mình. Khả năng cao kịch bản phân chia sẽ xảy ra, bởi Ultra luôn là mẫu máy bán chạy nhất của dòng Galaxy S và sẽ đòi hỏi một nguồn cung chipset cực kỳ khổng lồ.
Một nguồn tin nội bộ giải thích: “Không phải việc tích hợp chip AP của Qualcomm trên mẫu Galaxy S27 Ultra đã hoàn toàn bị hủy bỏ. Nhưng nếu vấn đề quá nhiệt không thể được giải quyết, các phương án thay thế bắt buộc phải được xem xét để đảm bảo đúng tiến độ sản xuất hàng loạt.”
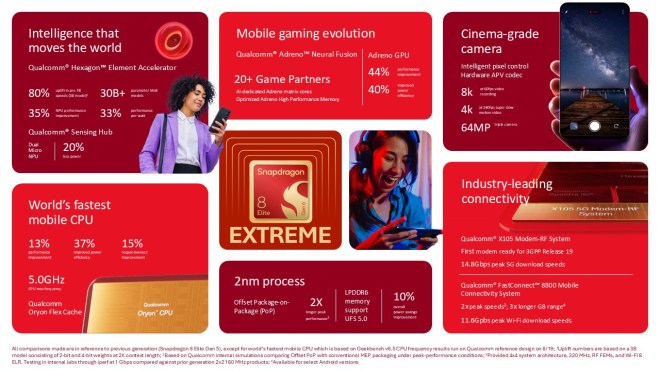
The Snapdragon 8 Elite Extreme Gen 6 is the first mobile chipset to crack the 5GHz barrier
Ngay cả khi chỉ áp dụng giải pháp phân chia thị trường, đây vẫn sẽ là một chiến thắng vang dội đối với Samsung LSI, bộ phận chuyên thiết kế chip Exynos. Thị trường nội địa Hàn Quốc đã không còn thấy sự xuất hiện của một chiếc điện thoại dòng Ultra chạy Exynos kể từ năm 2021, và thị trường toàn cầu cũng đã vắng bóng phiên bản này từ năm 2022.
Việc đưa Exynos trở lại dòng Ultra không chỉ mang đến danh tiếng cực lớn cho LSI mà còn bổ sung một nguồn doanh thu thiết yếu. Đồng thời, động thái này cũng sẽ giúp Samsung DX, bộ phận chịu trách nhiệm sản xuất điện thoại, tiết kiệm được một khoản ngân sách không nhỏ bởi các mẫu chip Snapdragon đầu bảng hiện đang có mức giá vô cùng đắt đỏ.
Nguồn: gsmarena

Nhóm phát triển Vera của NVIDIA nhận định Agentic AI đang buộc ngành công nghiệp phải đảo chiều thiết kế chipset

0

CPU Vera của NVIDIA báo hiệu một sự tái định nghĩa về kiến trúc máy tính, chuyển từ mô hình cô lập tác vụ truyền thống sang một hệ sinh thái trí tuệ nhân tạo Agentic được điều phối chặt chẽ. Sự thay đổi này biến vai trò của CPU từ một bộ vi xử lý đa nhiệm thông thường thành một “nhạc trưởng” chuyên biệt, được thiết kế riêng để quản lý các vòng lặp suy luận đa bước, phức tạp của các AI agent.

Mới đây, trang tin Wccftech đã có cơ hội ngồi lại cùng nhóm phát triển Vera của NVIDIA trong một buổi trò chuyện chuyên sâu về vai trò mới nổi của CPU trong nền kinh tế Agentic AI đang phát triển bùng nổ. Dưới đây là những nội dung thảo luận chi tiết về sự hồi sinh của hiệu năng đơn nhân, quy mô khổng lồ của các hệ thống AI sandbox do CPU kiểm soát, và sự dịch chuyển của tỷ lệ giữa CPU và GPU.
Nhóm phát triển Vera của NVIDIA nhận định Agentic AI đang buộc ngành công nghiệp phải đảo chiều thiết kế chipset 2
SAU NHIỀU NĂM HẠ TẦNG CLOUD ƯU TIÊN SỐ LƯỢNG NHÂN VÀ HY SINH TỐC ĐỘ ĐƠN NHÂN, AGENTIC AI ĐANG BUỘC NGÀNH CÔNG NGHIỆP ĐẢO CHIỀU, VÀ NVIDIA VERA CHÍNH LÀ MINH CHỨNG
Hỏi: Bạn có thể đưa ra một cái nhìn tổng quan ngắn gọn về CPU Vera là gì không?
Đáp: Vào đầu những năm 2010, thiết kế trung tâm dữ liệu tập trung vào việc tối đa hóa hiệu năng của từng nhân vi xử lý riêng lẻ thay vì chạy đua về số lượng nhân. Trong giai đoạn này, các ông lớn như Intel tập trung vào những kiến trúc sở hữu ít nhân hơn nhưng chạy ở mức xung nhịp cao hơn. Kỷ nguyên này mang đặc trưng là hiệu năng đơn nhân cao nhưng tổng thông lượng thấp.
Tuy nhiên, khi các nền tảng cloud ngày càng bành trướng, ngành công nghiệp bắt đầu xoay trục sang bài toán kinh tế quy mô. Nhu cầu chuyển sang việc nhồi nhét càng nhiều nhân vào một máy chủ càng tốt để tối đa hóa lợi nhuận. Để đạt được mật độ này và kiểm soát chi phí, các nhà cung cấp x86 đã từ bỏ thiết kế nguyên khối để chuyển sang bố cục đa chiplet. Nhưng sự mở rộng ồ ạt về số lượng nhân này đã phải đánh đổi trực tiếp bằng khả năng tối ưu hóa đơn nhân và chỉ số IPC. Đó là lúc thị trường ngập tràn các dòng chip mang lại thông lượng khổng lồ nhưng hiệu năng đơn nhân lại rất thấp.
Sự trỗi dậy của Agentic AI đã đưa CPU trở lại vị trí trung tâm của lộ trình thiết kế. Các AI agent hoạt động trong một vòng lặp liên tục, chớp nhoáng giữa GPU và CPU. Vì GPU là tài sản đắt đỏ và giá trị nhất trong một nhà máy AI, CPU phải hoàn thành các tác vụ tuần tự của mình ngay lập tức để tránh tình trạng GPU bị bỏ không chờ đợi. Mô hình này đòi hỏi một sự kết hợp chưa từng có giữa tốc độ, khả năng truy xuất bộ nhớ và độ trễ tối thiểu.
CPU Vera của NVIDIA giải quyết nút thắt cổ chai của Agentic bằng cách phá vỡ sự đánh đổi lịch sử của kỷ nguyên cloud. Hãng định vị bản thân ở góc độ khó nhằn nhất: hiệu năng đơn nhân cao kết hợp cùng thông lượng lớn. Vera đạt được điều này thông qua ba thiết kế cốt lõi: tốc độ đơn nhân cực cao, hệ thống bộ nhớ LPDDR5X tùy chỉnh cho băng thông khổng lồ, và một đế silicon tính toán nguyên khối (monolithic compute die) duy nhất được tiếp sức bởi công nghệ Scalable Coherent Fabric thế hệ thứ hai nhằm triệt tiêu hoàn toàn độ trễ. Nhờ đó, tất cả các nhân trên đế tính toán nguyên khối có thể giao tiếp với nhau mà không phải vượt qua bất kỳ rào cản I/O nào.
SỰ PHÂN TÁCH TRONG CHỨC NĂNG CPU VÀ BÀI TOÁN HIỆU NĂNG TỪ SPATIAL MULTITHREADING
Hỏi: Với việc SK Hynix công bố HTPU – nơi có khoảng 100 bộ vi xử lý nhỏ xíu bên trong một ổ SSD đảm nhận các tác vụ cấp thấp lặp đi lặp lại, nhường lại cho vi xử lý chính tập trung vào các tác vụ cấp cao – liệu NVIDIA có đang quan tâm hay theo đuổi một sự phân tách tương tự trong các chức năng của CPU?
Đáp: Bức tranh cơ sở hạ tầng AI đang dịch chuyển khỏi các cụm máy chủ đồng nhất để hướng tới các thiết lập chuyên biệt hóa và không đồng nhất. Một ví dụ điển hình là trong các khối lượng công việc suy luận AI hiện đại, các giai đoạn xử lý riêng biệt từ việc đọc dữ liệu ban đầu (pre-fill) cho đến việc tạo ra các token tuần tự (decode) hiện đã được chia tách sang các cụm phần cứng hoàn toàn khác nhau để tối ưu hóa hiệu quả.
NVIDIA Pivots to CPUs to Salvage China Revenue After GPU Restrictions, As Several Customers Show Interest In Vera CPUs
Chiến lược CPU ban đầu của NVIDIA với vi xử lý Grace tập trung vào việc tạo ra một host node tối thượng – một bộ vi xử lý được thiết kế hoàn toàn để đẩy dữ liệu cho một cụm GPU trong tủ rack máy chủ. Tuy nhiên, những đòi hỏi đặc thù của các luồng công việc Agentic và reinforcement learning đã buộc hãng phải xoay trục, đặc biệt là khi NVIDIA nhận ra rằng thị trường đang rất cần các tủ rack thuần CPU để xử lý các lệnh gọi công cụ của agent.
Bởi vì bước ngoặt này, CPU Vera không còn bị xem đơn thuần là một thành phần tích hợp bị mắc kẹt bên trong một kiến trúc kết hợp (như hệ thống Vera-Rubin). Thay vào đó, Vera đang được thương mại hóa như một tài sản CPU độc lập riêng biệt, chuyên xử lý những khối lượng dữ liệu khổng lồ từ các agent tool calls và các vòng lặp suy luận.
Hỏi: NVIDIA đề cập rằng Vera có IPC cao hơn khoảng 50% so với Grace. Và CPU này cũng có độ rộng giải mã 10-wide. Nếu xảy ra lỗi dự đoán, độ trễ sẽ như thế nào? Cần bao nhiêu chu kỳ để Vera phục hồi so với Grace?
Đáp: CPU Vera đạt được một bước nhảy vọt khổng lồ về sức mạnh xử lý, mang lại hiệu năng nhanh hơn 1.5 lần so với người tiền nhiệm Grace. Khi được đo lường với các bộ vi xử lý x86 hàng đầu hiện nay, đặc biệt là trên các tác vụ Agentic vốn phụ thuộc nhiều vào khả năng xử lý tuần tự, Vera có thể hoạt động nhanh gấp 2 lần.
Thay vì dựa vào các phương pháp Simultaneous Multithreading truyền thống, NVIDIA đã triển khai một công nghệ nội bộ có tên gọi Spatial Multithreading. Tính năng độc quyền này cho phép con chip cấp phát cố định các luồng worker và luồng I/O chuyên dụng. Sự phân chia này đảm bảo rằng ngay cả dưới khối lượng tính toán cực nặng, một nhân cũng sẽ không bao giờ bị tước đoạt chu kỳ xử lý của luồng worker để nhường cho I/O hoặc các nhân khác.
Để giải quyết những lo ngại về việc liệu cơ chế lập lịch luồng phức tạp này có gây ra độ trễ kiến trúc hay suy giảm hiệu năng hay không, trang phần cứng Phoronix đã thực hiện các bài đánh giá độc lập và xác nhận rằng SMT của NVIDIA trên Vera thực sự mang lại mức tăng hiệu năng lên tới khoảng 20%, hoàn toàn không có sự đánh đổi nào.
GÓC NHÌN CỦA NVIDIA VỀ TỶ LỆ CPU VÀ GPU TRONG TƯƠNG LAI
Hỏi: Khi Meta ra mắt agent Muse, một số thông tin cho thấy tỷ lệ CPU và GPU trong môi trường AI cuối cùng có thể đạt mức 80:1. Điều này có thực tế không, và nó tác động thế nào đến nhu cầu đối với Vera?
Đáp: Dù NVIDIA không chính thức dự báo tỷ lệ 80:1, nhưng số lượng các lệnh gọi công cụ agent trong ngành hiện đang rất khổng lồ, với một số nhà cung cấp dịch vụ sandbox phải duy trì tới 400.000 sandbox cho chỉ một khách hàng duy nhất. Cơ sở hạ tầng đang dịch chuyển mạnh mẽ về phía CPU để hỗ trợ hàng nghìn tỷ sandbox đang thực thi. Đây chính là động lực thúc đẩy NVIDIA đẩy mạnh các hệ thống rack trang bị thuần CPU Vera độc lập để phục vụ cho các khối lượng công việc Agentic và reinforcement learning.
THIẾT KẾ ĐẾ NGUYÊN KHỐI MONOLITHIC CỦA NVIDIA VERA
Hỏi: Tại sao NVIDIA chọn thiết kế đế nguyên khối cho Vera thay vì kiến trúc chiplet mà các đối thủ đang sử dụng?
Đáp: Khác với các nhà sản xuất x86 truyền thống buộc phải thiết kế những kiến trúc phức tạp để phục vụ cả người dùng phổ thông lẫn trung tâm dữ liệu cao cấp, NVIDIA bước vào không gian CPU mà hoàn toàn không bị vướng bận bởi các phân khúc tệp khách hàng trong quá khứ. Vị thế độc đáo này cho phép họ có được sự xa xỉ khi thiết kế Vera dành riêng cho một mục tiêu duy nhất là thị trường trung tâm dữ liệu.
Để đáp ứng các vòng lặp truy xuất bộ nhớ dồn dập của AI agent, NVIDIA đã chủ động gạt bỏ xu hướng multi-chiplet để chọn thiết kế đế nguyên khối monolithic. Bằng cách giữ tất cả các nhân trên một mảnh silicon liền mạch duy nhất, NVIDIA đã triệt tiêu hoàn toàn sự sụt giảm hiệu năng nội bộ xảy ra khi dữ liệu buộc phải giao tiếp chéo qua lại giữa ranh giới của các chiplet riêng biệt.
Thiết kế nguyên khối này chuyển hóa thành một lợi thế hiệu năng khổng lồ cho việc xử lý điện toán cộng tác. CPU Vera đạt được băng thông phân đôi chưa từng có lên tới 3.4 terabyte/giây, cho phép các nhân vi xử lý cộng tác và chia sẻ thông tin ngữ cảnh nhanh hơn 3 lần so với các chip x86 hàng đầu. Mặc dù cách tiếp cận nguyên khối là điều bắt buộc để đạt được các mục tiêu hiệu năng đặc thù của Vera, NVIDIA vẫn duy trì một lập trường thực tế và hoàn toàn có thể xoay trục sang các thiết kế chiplet nếu thị trường trong tương lai đòi hỏi.
Nguồn: wccftech

GTA V: NPC giờ đây có thể giao tiếp theo thời gian thực nhờ bản mod AI NPCTalk

0

Một bộ công cụ mod tích hợp AI hoàn toàn mới mang tên NPCTalk đang đưa những cuộc trò chuyện không theo kịch bản, diễn ra theo thời gian thực vào GTA V. Đột phá này cho phép game thủ trò chuyện trực tiếp với các NPC và nhận lại câu trả lời bằng chính chất giọng gốc của họ thông qua công nghệ AI voice cloning. Được phát triển bởi Universal Modder, dự án open-source này đặt mục tiêu mang tính năng tương tự lên gần như mọi tựa game hỗ trợ mod.

BƯỚC ĐỘT PHÁ TỪ KHUNG HỘI THOẠI TRUYỀN THỐNG
Khác với các hệ thống hội thoại NPC truyền thống vốn phụ thuộc vào những đoạn ghi âm sẵn và kịch bản cố định, NPCTalk tạo ra các cuộc trò chuyện linh hoạt nhờ sử dụng các AI model. Người chơi có thể tiếp cận gần như bất kỳ nhân vật nào trong GTA V, nói chuyện qua micro và nhận lại những phản hồi bám sát ngữ cảnh, phản ánh đúng tính cách của nhân vật, môi trường xung quanh cũng như tình huống hiện tại.
gta-v-npc-gio-day-co-the-giao-tiep-theo-thoi-gian-thuc
Nhóm phát triển đã trình diễn công nghệ này với các nhân vật như Michael và Lamar, bên cạnh những người đi đường bình thường và lực lượng cảnh sát. Các NPC thậm chí có thể phản ứng về mặt thể chất với cuộc trò chuyện, thực hiện các animation hoặc tuân theo một số mệnh lệnh bằng giọng nói. Chẳng hạn, một sĩ quan cảnh sát có thể vừa buông lời lăng mạ người chơi vừa thực hiện một cử chỉ phù hợp, thay vì chỉ đưa ra một câu thoại chung chung.
SỨC MẠNH TỪ SỰ KẾT HỢP CỦA HÀNG LOẠT AI MODEL
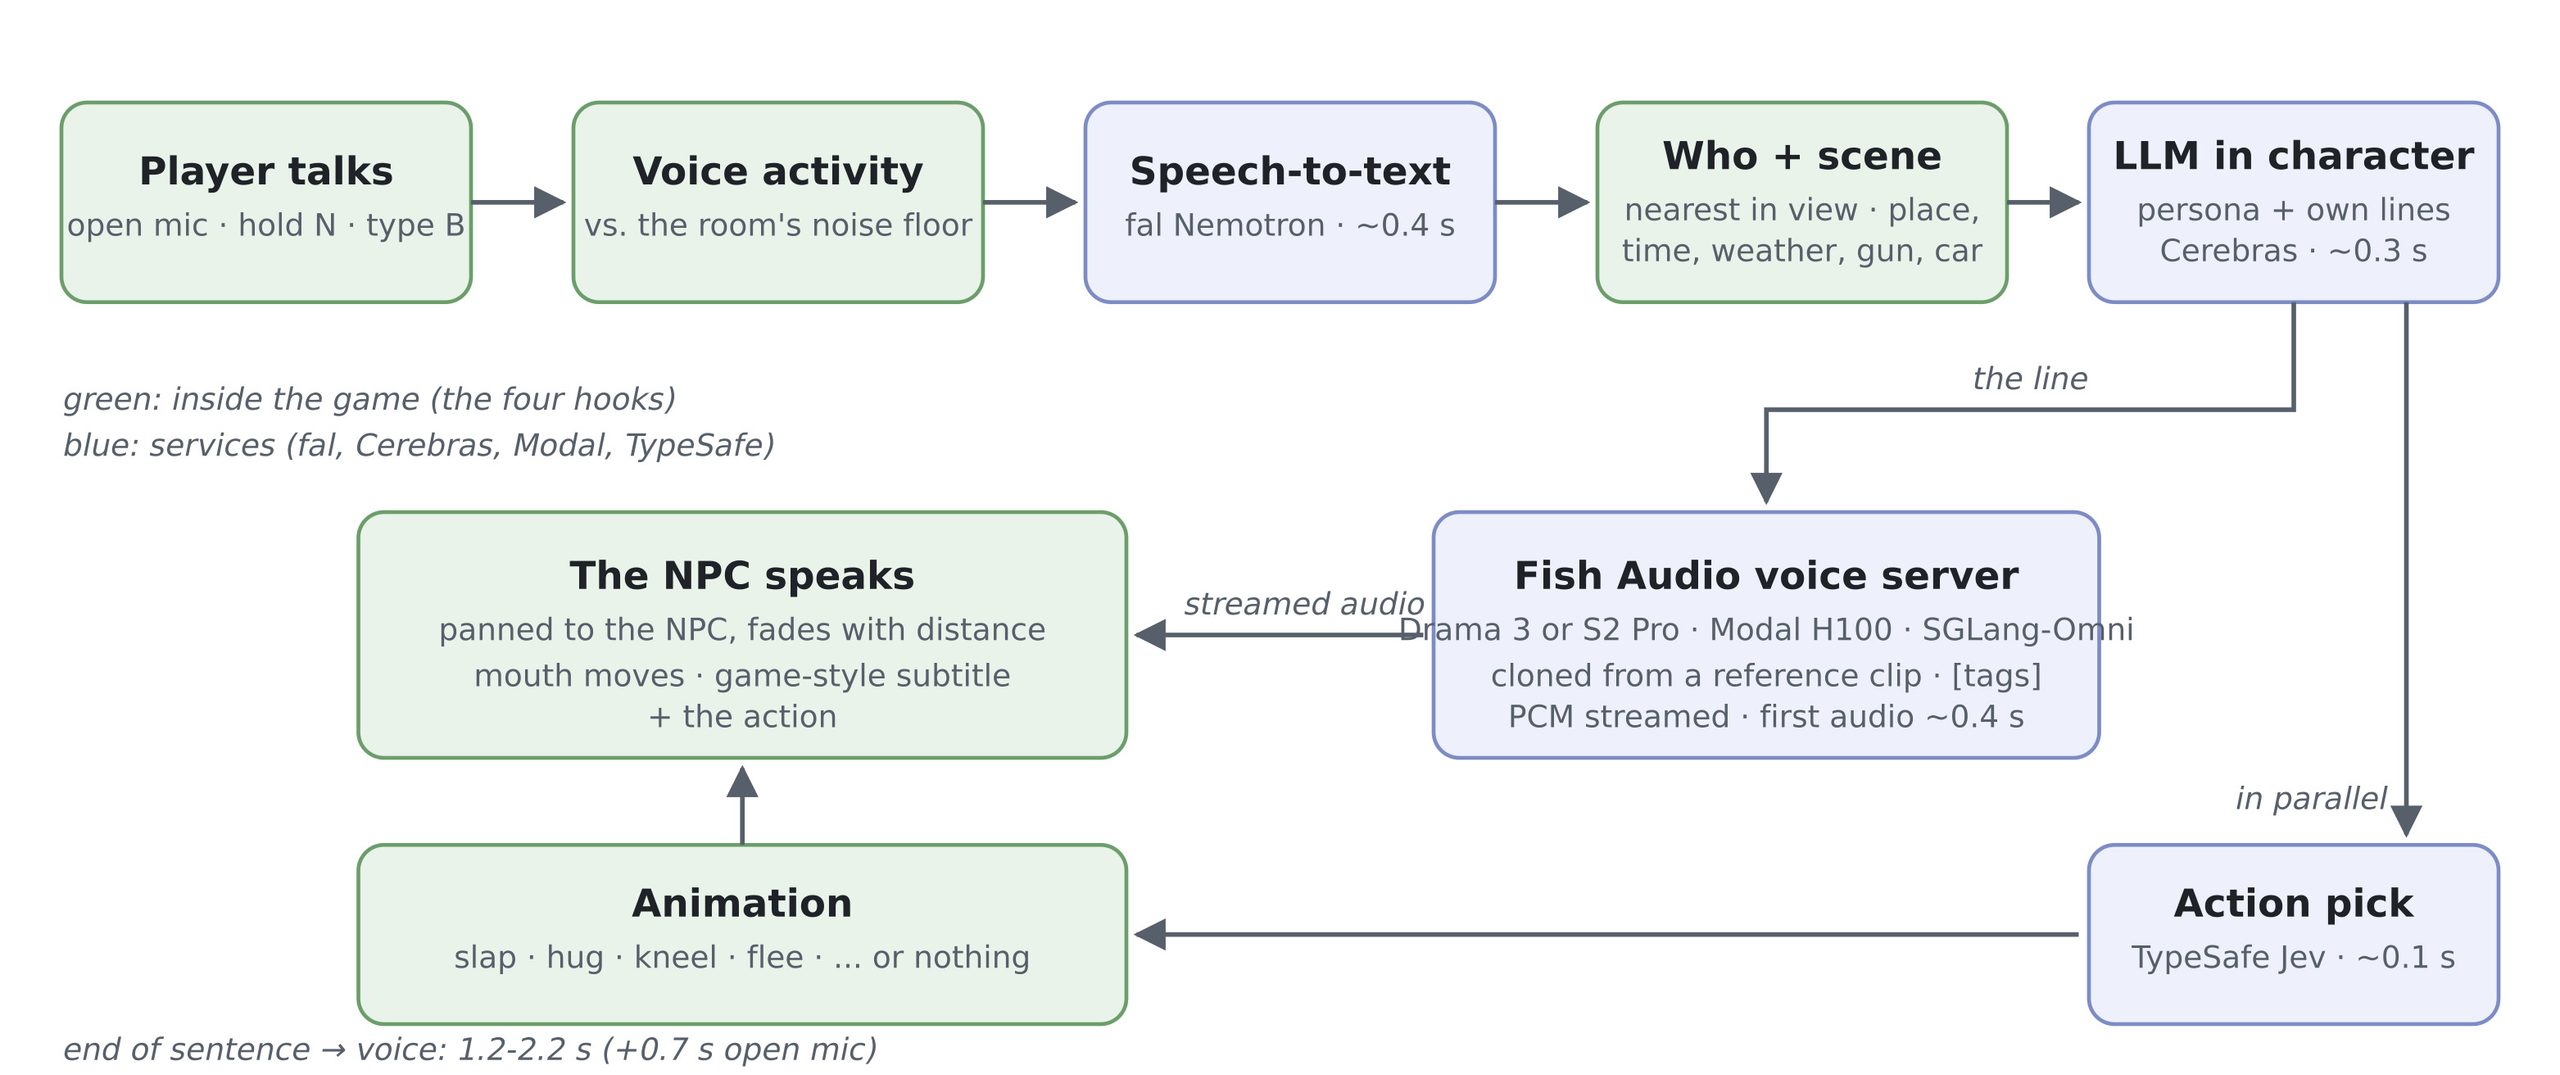
Công nghệ này hoạt động dựa trên sự phối hợp của nhiều AI model và dịch vụ khác nhau. Nemotron ASR của NVIDIA đảm nhận vai trò speech recognition, trong khi Qwen 3.8 27B chạy qua nền tảng Cerebras sẽ tạo ra các đoạn hội thoại theo thời gian thực. Cùng lúc đó, Fish Audio Drama 3 xử lý khâu voice cloning và speech synthesis, cho phép các nhân vật phản hồi bằng chất giọng giống hệt như nguyên bản. Voice model này được vận hành trên nền tảng đám mây sử dụng GPU NVIDIA H100, đi kèm TypeSafe Jev chuyên xử lý các hành động của NPC.
Một khía cạnh đặc biệt ấn tượng là độ trễ phản hồi của hệ thống. Dù nhà phát triển ban đầu quảng cáo thời gian phản hồi dưới một giây, nhưng tài liệu kỹ thuật của dự án ghi nhận khoảng 1.15 đến 2.2 giây kể từ lúc người chơi kết thúc câu nói cho đến khi NPC bắt đầu lên tiếng khi dùng chế độ push-to-talk. Nếu sử dụng tính năng nhận diện micro mở liên tục, độ trễ sẽ bị cộng thêm khoảng 0.7 giây.
TIỀM NĂNG MỞ RỘNG VÀ BÀI TOÁN CHI PHÍ
Thú vị hơn, NPCTalk được phát triển với sự hỗ trợ của Claude Code, và các nhà phát triển đã đóng gói toàn bộ kiến thức tích lũy được thành một bộ sưu tập các AI-agent skills có thể tái sử dụng. Chúng hoàn toàn tương thích với Claude Code, Codex, Cursor, Gemini CLI và các coding assistants khác, mở ra tiềm năng cho các lập trình viên và modder tích hợp công nghệ này vào những tựa game khác.
Tuy nhiên, điều đó không đồng nghĩa NPCTalk là một bản mod vạn năng chỉ cần cài đặt là chạy. Mỗi trò chơi đều đòi hỏi quá trình tích hợp riêng biệt và phiên bản hiện tại mới chỉ được thử nghiệm thành công trong chế độ chơi đơn của GTA V Legacy. Hơn nữa, mặc dù bản thân bộ toolkit là open-source theo giấy phép MIT, việc vận hành các dịch vụ đám mây và cơ sở hạ tầng GPU bắt buộc có thể làm phát sinh chi phí cho người dùng.
A flowchart illustrates the process of a player talking in-game, triggering 'Voice activity' and 'Speech-to-text,' leading to an NPC speaking with game-style subtitles and animation choices like 'slap' or 'hug,' incorporating services such as 'Cerebras' and 'Fish Audio voice server.'
Bộ công cụ NPCTalk hiện đã có mặt trên nền tảng GitHub, trong khi nhà phát triển cũng thông báo rằng một bản mod GTA V miễn phí, sẵn sàng để trải nghiệm sẽ được tung ra vào tuần tới.
Mặc dù công nghệ này vẫn đang trong giai đoạn thử nghiệm, nó đã mang đến một góc nhìn đầy hứa hẹn về một tương lai nơi các NPC không còn bị gò bó trong những cây hội thoại định sẵn, mở ra tiềm năng biến các thế giới ảo trở nên tương tác và sống động hơn bao giờ hết.
Nguồn: wccftech

ASUS mở bán ProArt P16 tích hợp NVIDIA RTX Spark tại Việt Nam

0

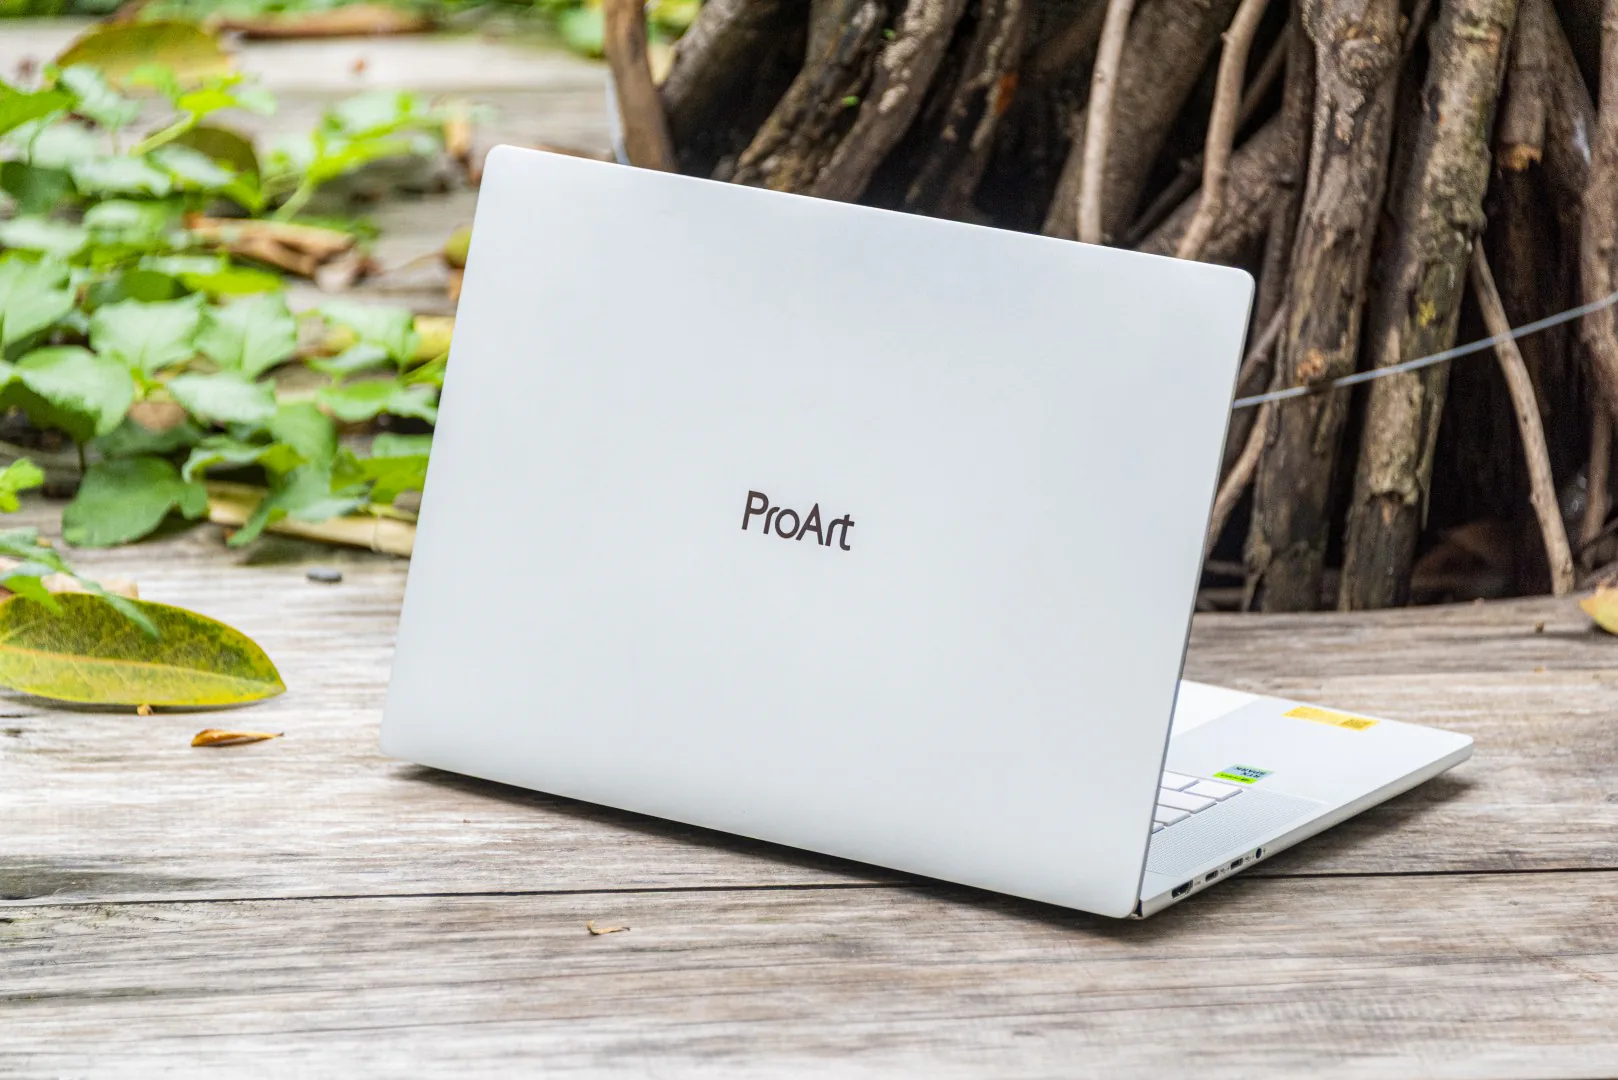
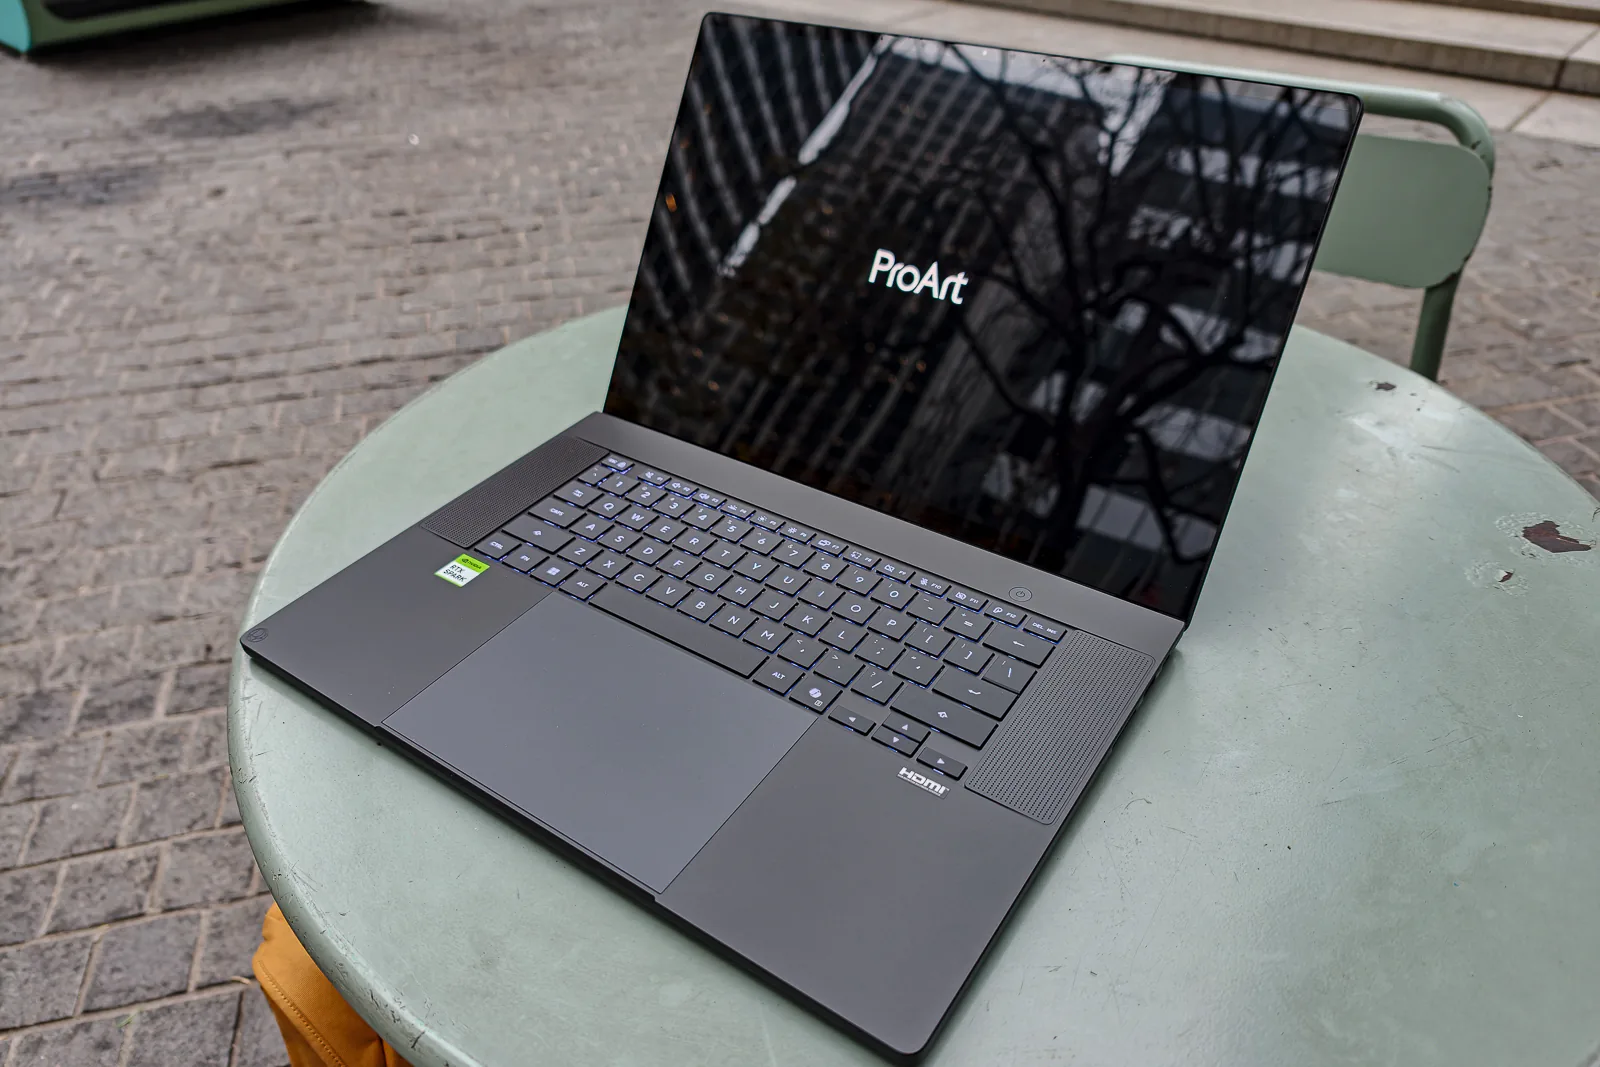
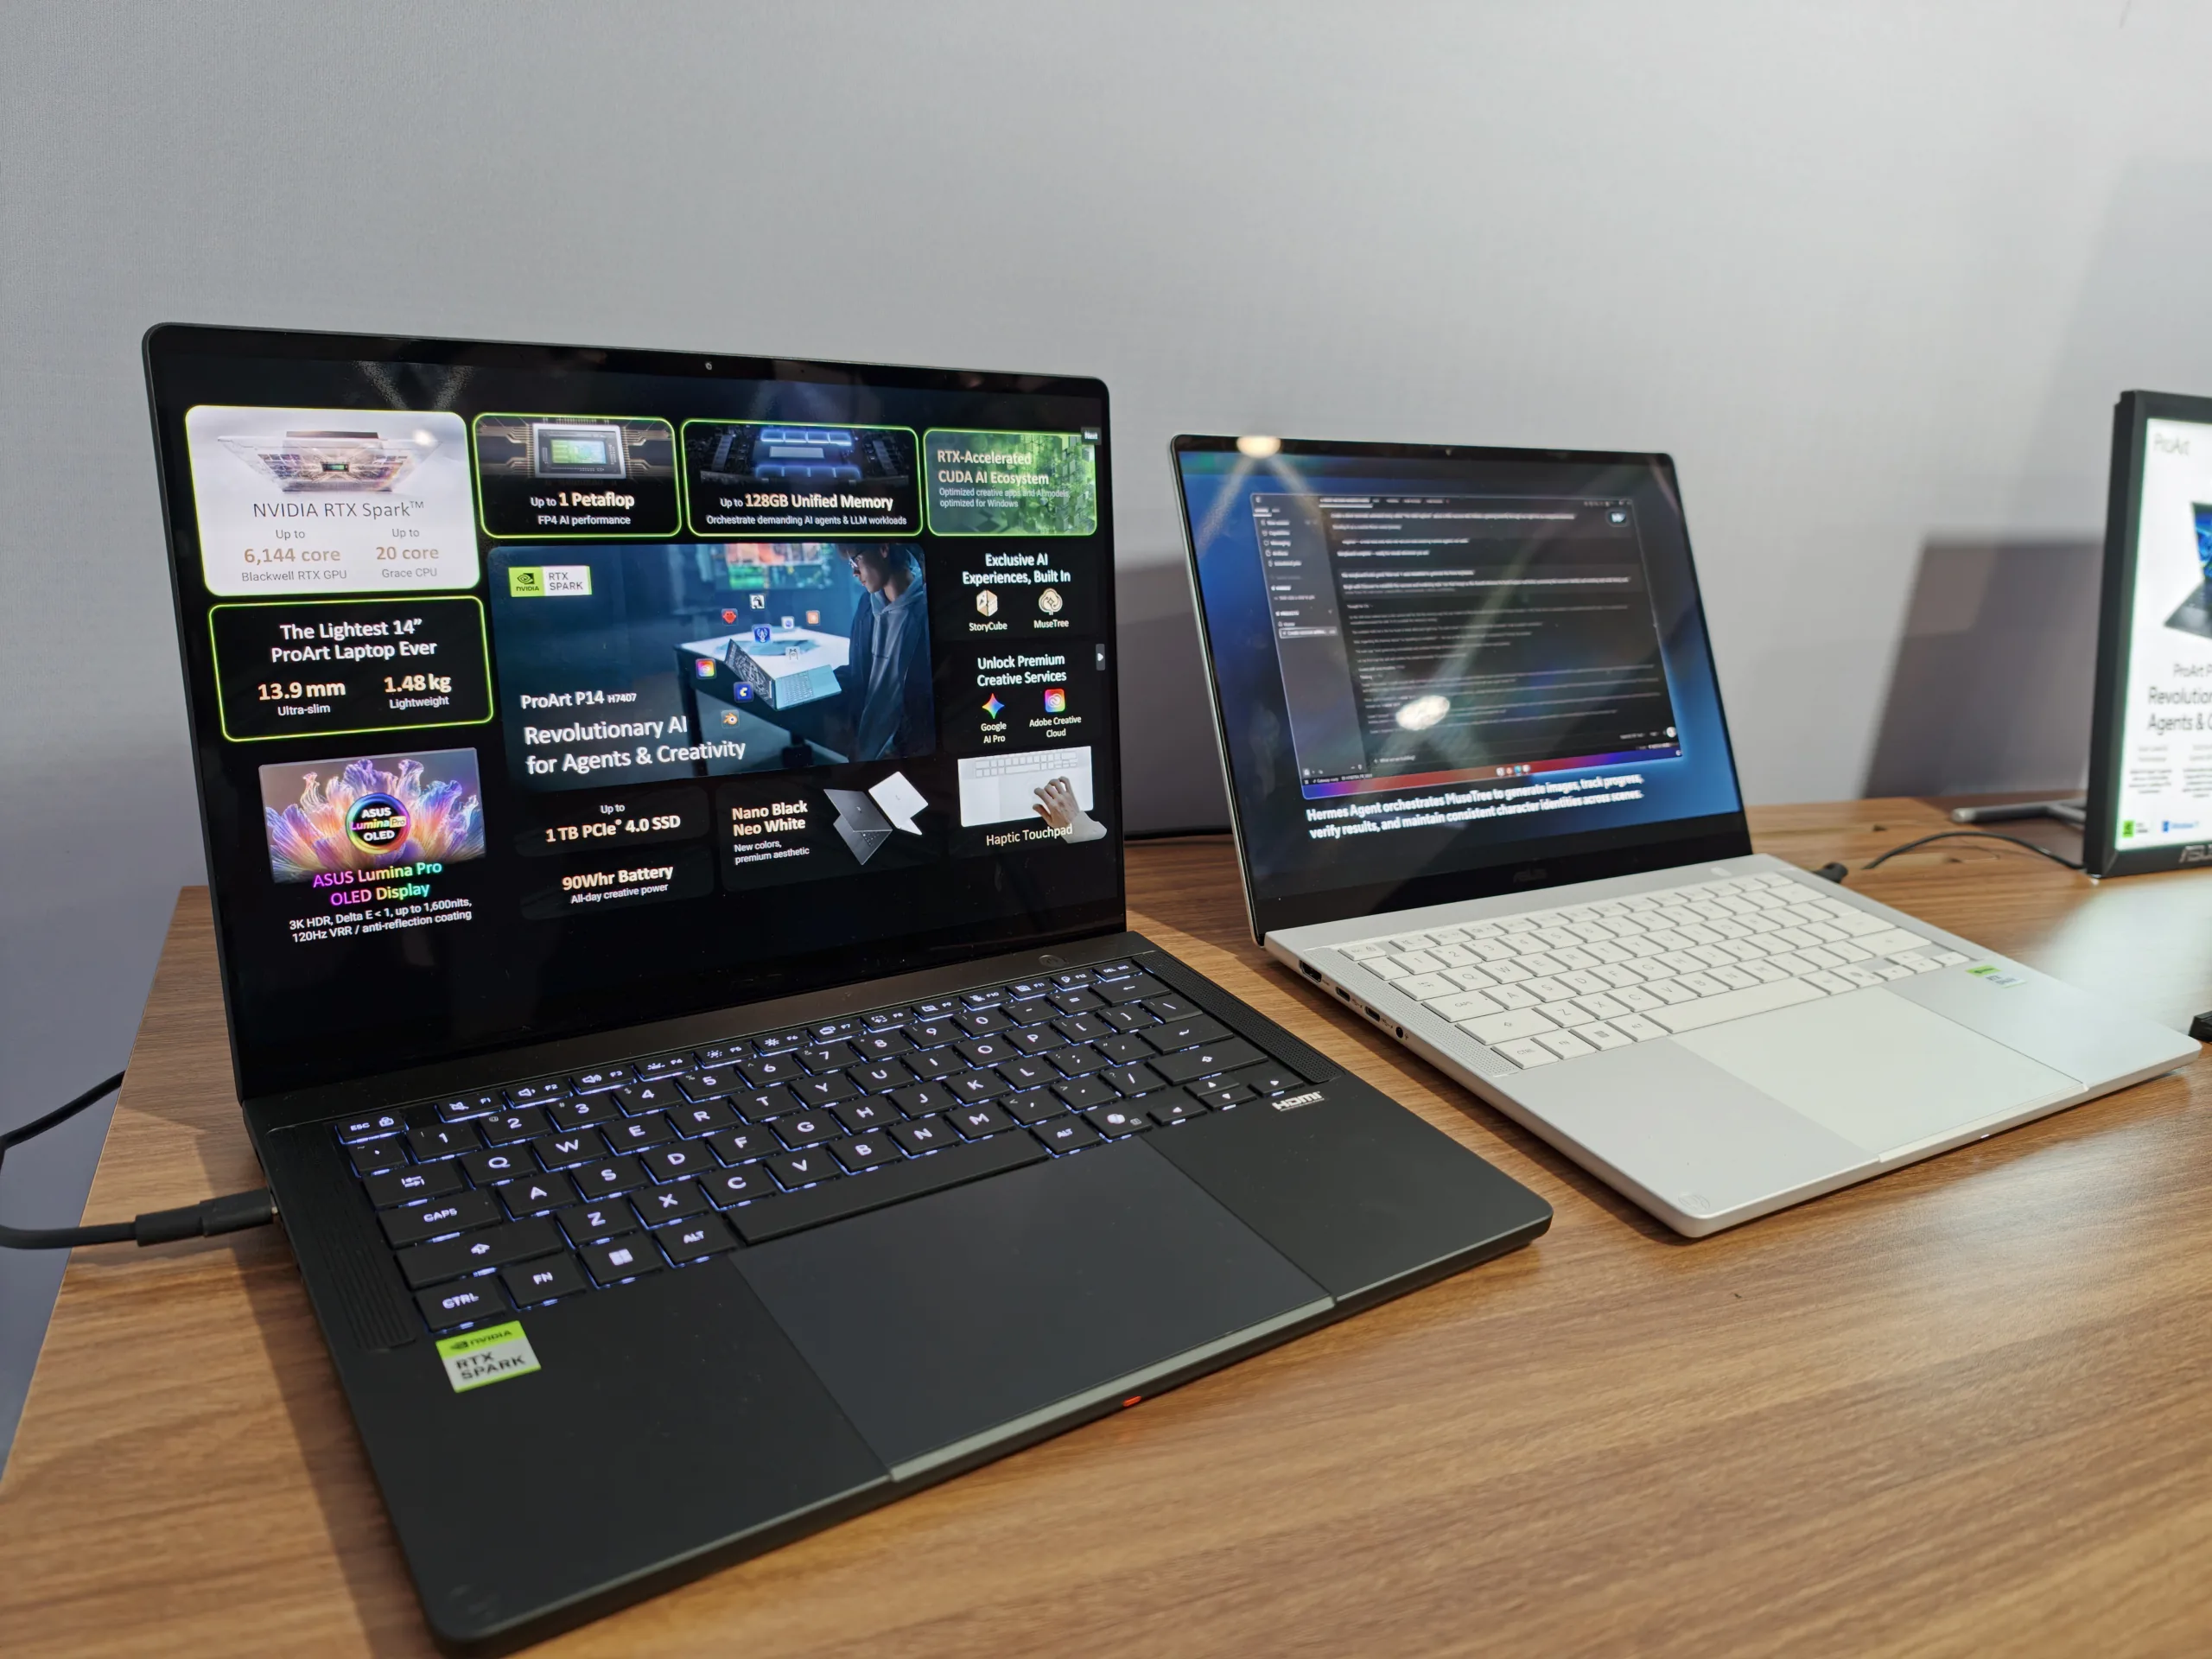
ASUS chính thức mở bán ProArt P16 trang bị NVIDIA RTX Spark và bộ nhớ hợp nhất 128GB tại Việt Nam, hướng đến xử lý Agentic AI ngay trên laptop.

ASUS vừa mở bán mẫu laptop đồ họa ProArt P16 trang bị nền tảng NVIDIA RTX Spark thế hệ mới tại thị trường Việt Nam từ ngày 16/10/2026. Sản phẩm hiện đã có mặt trên ASUS Store Online và tại các đại lý trên toàn quốc. Đây là một trong những thiết bị đầu tiên của ASUS được thiết kế chuyên biệt để xử lý các tác vụ Agentic AI ngay trên máy, không phụ thuộc vào nền tảng đám mây.

ASUS mở bán ProArt P16 tích hợp NVIDIA RTX Spark tại Việt Nam 3

Theo ASUS, dù ProArt P14/16 hướng đến nhóm khách hàng chuyên biệt trong lĩnh vực sáng tạo nội dung, hãng tin rằng nhu cầu vận hành AI trực tiếp trên máy tính cá nhân sẽ tiếp tục tăng khi công nghệ ngày càng tham gia sâu vào công việc thường nhật. Hãng chọn cách chuẩn bị sản phẩm và hệ sinh thái từ sớm, thay vì chờ thị trường định hình nhu cầu hoàn toàn.

Từ AI tạo sinh đến AI Agent trong quy trình sáng tạo

AI tạo sinh hiện cho phép người dùng tạo hình ảnh, video hay phác thảo ý tưởng chỉ với vài dòng mô tả, thay vì mất nhiều giờ làm việc như trước. Tuy nhiên với các nhà sáng tạo chuyên nghiệp, có được một sản phẩm đẹp mắt mới chỉ là bước khởi đầu. Việc kiểm soát chất lượng, xử lý dữ liệu lớn và hoàn thiện sản phẩm theo yêu cầu thực tế vẫn cần đến công cụ chuyên dụng.

ASUS mở bán ProArt P16 tích hợp NVIDIA RTX Spark tại Việt Nam 4

Khác với AI tạo sinh thông thường vốn phản hồi theo từng yêu cầu riêng lẻ, AI Agent có khả năng tự lên kế hoạch, sử dụng nhiều công cụ khác nhau và thực hiện liên tiếp nhiều bước để hoàn thành một mục tiêu được giao. Sự xuất hiện của ProArt P16 phản ánh hướng phát triển mới của máy tính cá nhân, từ công cụ thực hiện thao tác theo lệnh trở thành nền tảng phối hợp cùng AI để xử lý công việc phức tạp hơn, giúp người sáng tạo dành nhiều thời gian hơn cho ý tưởng thay vì các thao tác lặp lại.

Bộ nhớ hợp nhất 128GB giải quyết giới hạn xử lý AI trên PC

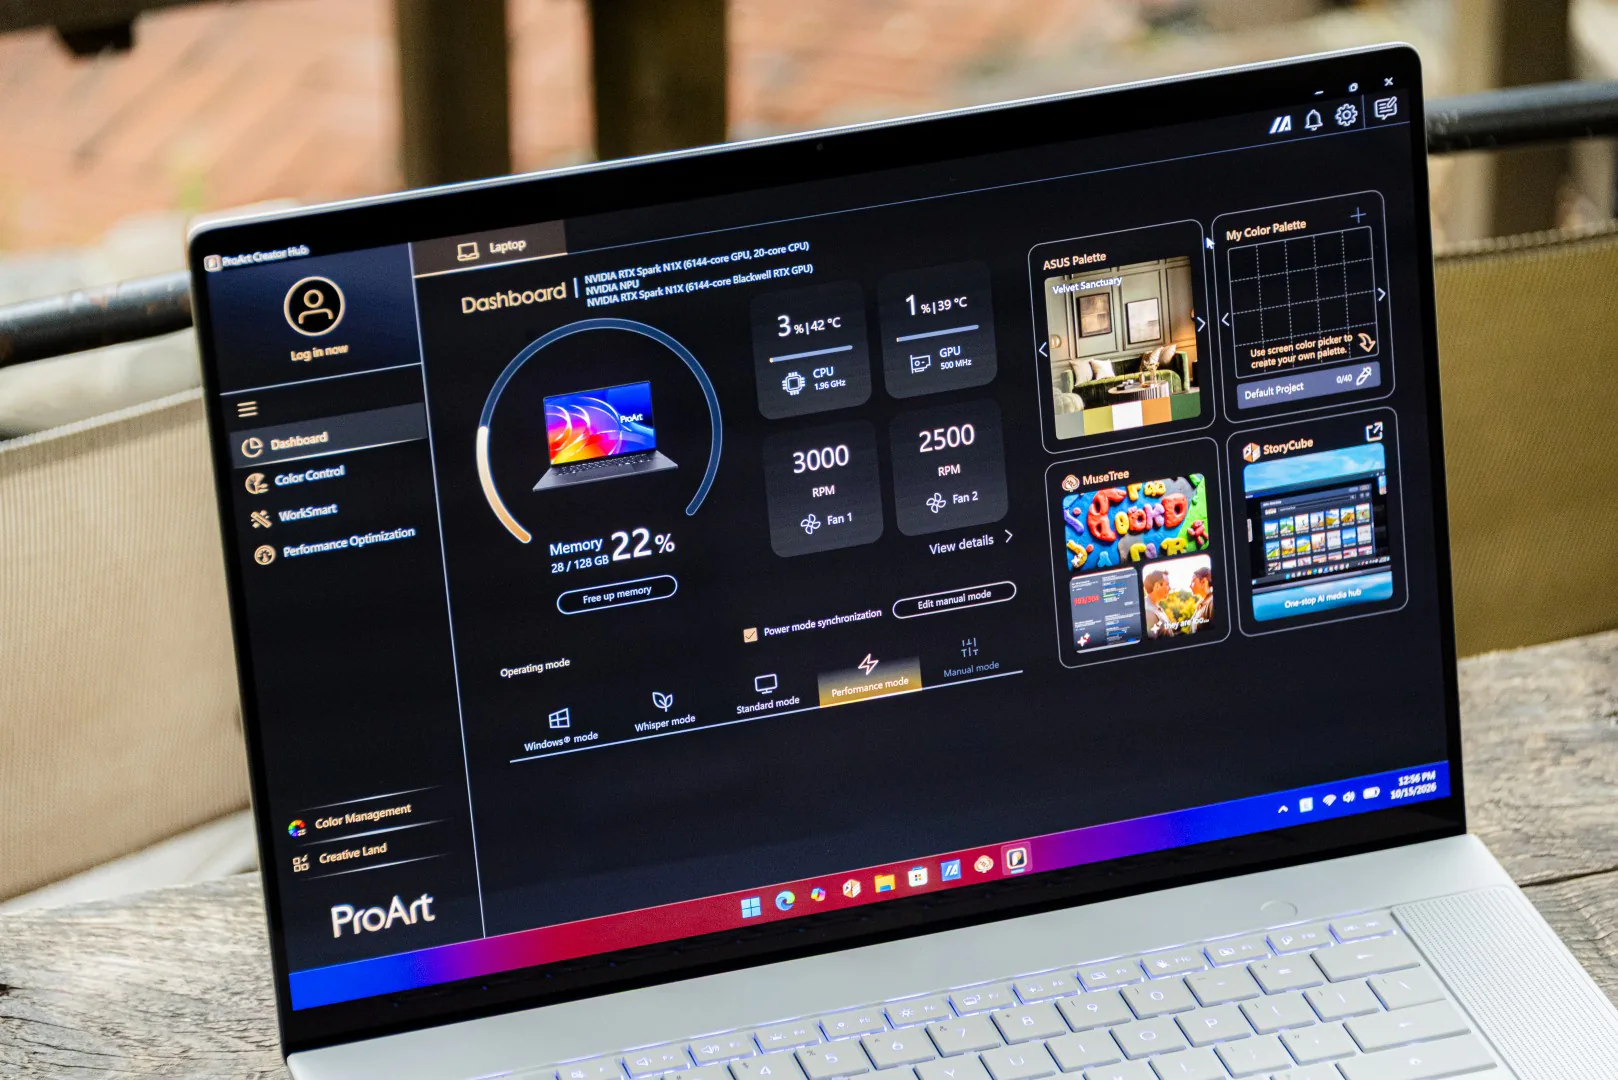
ProArt P16 trang bị NVIDIA RTX Spark cùng bộ nhớ hợp nhất (Unified Memory) lên đến 128GB, được thiết kế để vận hành các hệ thống Agentic AI, mô hình ngôn ngữ lớn (LLM) và các quy trình xử lý đồ họa phức tạp ngay trên thiết bị. ASUS cho biết đây là cách giải quyết rào cản lớn nhất của các dòng PC truyền thống khi xử lý AI: giới hạn về dung lượng bộ nhớ.

ASUS mở bán ProArt P16 tích hợp NVIDIA RTX Spark tại Việt Nam 5

Việc sở hữu năng lực xử lý AI cục bộ (local AI) mang lại ba lợi thế chính cho người dùng. Thứ nhất là không giới hạn token, chuyển chi phí trả theo lượt dùng trên đám mây thành tài nguyên tính toán cố định, cho phép thử nghiệm và lặp lại prompt không giới hạn mà không phát sinh thêm chi phí. Thứ hai là bảo mật dữ liệu, khi toàn bộ dữ liệu dự án, prompt, tệp nguồn và mô hình được lưu trữ và thực thi ngay trên máy, có thể hoạt động ngoại tuyến mà không lo rò rỉ thông tin. Thứ ba là khả năng kiểm soát toàn bộ quy trình, cho phép người dùng chủ động lựa chọn mô hình, tùy biến hành vi hệ thống và xây dựng workflow tự động theo nhu cầu riêng.

Thiết kế mỏng nhẹ với màn hình OLED 4K độ chính xác màu cao

Dù trang bị cấu hình mạnh, ProArt P16 vẫn giữ ngôn ngữ thiết kế mỏng nhẹ quen thuộc của dòng ProArt. Khung máy làm từ hợp kim nhôm CNC, độ dày chỉ 12,9mm và trọng lượng 1,77kg, trở thành mẫu ProArt 16 inch mỏng nhất từ trước đến nay. Máy hoàn thiện với tông màu Neo White, đi kèm pin dung lượng 99Wh phục vụ nhu cầu làm việc di động ngoài studio.

ASUS mở bán ProArt P16 tích hợp NVIDIA RTX Spark tại Việt Nam 6

Màn hình sử dụng tấm nền ASUS Lumina Pro OLED (Tandem OLED) độ phân giải 4K, tần số quét 120Hz hỗ trợ VRR và công nghệ chống xé hình NVIDIA G-SYNC. Màn hình đạt độ chính xác màu Delta E dưới 1, độ sáng tối đa 1.600 nits cùng lớp phủ chống phản xạ ánh sáng, hỗ trợ quan sát chi tiết hình ảnh trong nhiều điều kiện ánh sáng khác nhau. Máy cũng được trang bị bàn di chuột xúc giác (haptic touchpad) cho khả năng điều khiển chính xác.

Giá bán và thời gian mở bán các phiên bản

ASUS ProArt P16 hiện có bốn phiên bản cấu hình khác nhau. Bản H7407BA-SU304W màn hình 14 inch OLED 4K cảm ứng, chip Extreme Pro, RAM 48GB, ổ cứng 1TB có giá 114.990.000 đồng, dự kiến mở bán trong tháng 11. Bản H7607BA-SE298W màn hình 16 inch cấu hình tương tự với RAM 48GB có giá 119.900.000 đồng, dự kiến mở bán cuối tháng 10.

ASUS mở bán ProArt P16 tích hợp NVIDIA RTX Spark tại Việt Nam 7

Bản H7607BA-SE016W cùng kích thước màn hình 16 inch nhưng nâng RAM lên 64GB có giá 129.900.000 đồng, cũng dự kiến mở bán cuối tháng 10. Phiên bản cao cấp nhất H7607BA-SE343W trang bị RAM 128GB, ổ cứng 1TB có giá 194.990.000 đồng và đã chính thức mở bán ngay từ hôm nay.

CFS 2026 Path Vietnam chính thức khởi tranh với 5 nhà tài trợ uy tín đồng hành

0

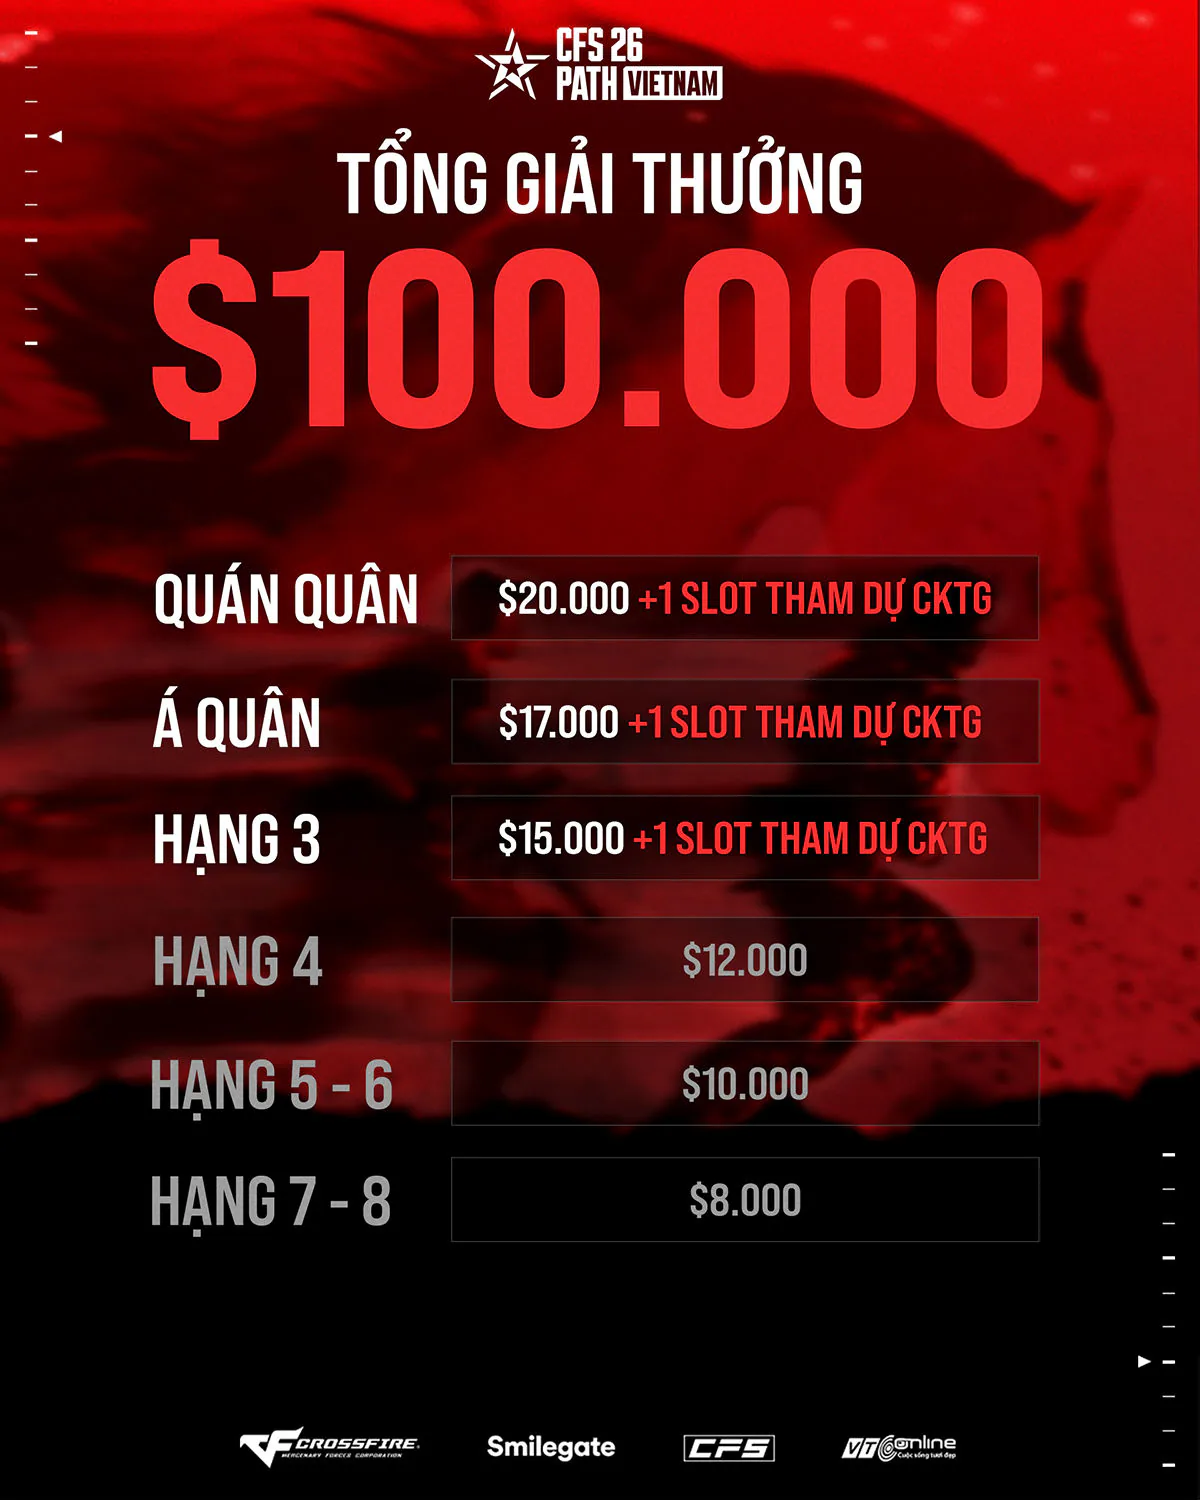
CFS 2026 Path Việt Nam sẽ chính thức khởi tranh từ ngày 16/10 đến 01/11/2026, quy tụ 12 đội tuyển Đột Kích hàng đầu Việt Nam. Với tổng giải thưởng 100.000 USD cùng ba suất tham dự CFS 2026 Grand Finals tại Vũ Hán, Trung Quốc, giải đấu sẽ mở ra cuộc cạnh tranh quyết liệt để tìm kiếm những đại diện xứng đáng bước ra đấu trường thế giới.

CFS 2026 Path Vietnam chính thức khởi tranh với 5 nhà tài trợ uy tín đồng hành 8

Mang thông điệp “Ride Together, Rise Together – Cùng tiến bước, cùng vươn tới đỉnh cao”, CFS 2026 Path Việt Nam là nơi các đội tuyển khẳng định bản lĩnh và hiện thực hóa khát vọng thi đấu quốc tế. Mỗi chiến thắng sẽ đưa họ tiến gần hơn đến Chung kết Thế giới, trong khi mỗi thất bại đều có thể khiến hành trình chinh phục đứng trước thử thách lớn.

CFS 2026 Path Vietnam chính thức khởi tranh với 5 nhà tài trợ uy tín đồng hành 9 CFS 2026 Path Vietnam chính thức khởi tranh với 5 nhà tài trợ uy tín đồng hành 10

Đây cũng là cơ hội để những “Hắc Mã” phá vỡ dự đoán, vượt qua giới hạn và viết nên câu chuyện của riêng mình. Khi mục tiêu là một trong ba tấm vé đại diện Việt Nam, mọi đội tuyển đều phải chứng minh sức mạnh bằng màn trình diễn trên máy chủ thi đấu.

Ấn tượng hơn nữa, giải đấu lần này cũng nhận được sự chăm sóc chu đáo từ 5 thương hiệu công nghệ có uy tín hàng đầu bao gồm: Thiết bị âm thanh chuyên dụng JBL Quantum, thương hiệu card màn hình Colorful iGame, thương hiệu màn hình gaming AOC, chàng khổng lồ Microsoft và hãng xe công nghệ Xanh SM.

Hai giai đoạn quyết định hành trình đến Vũ Hán

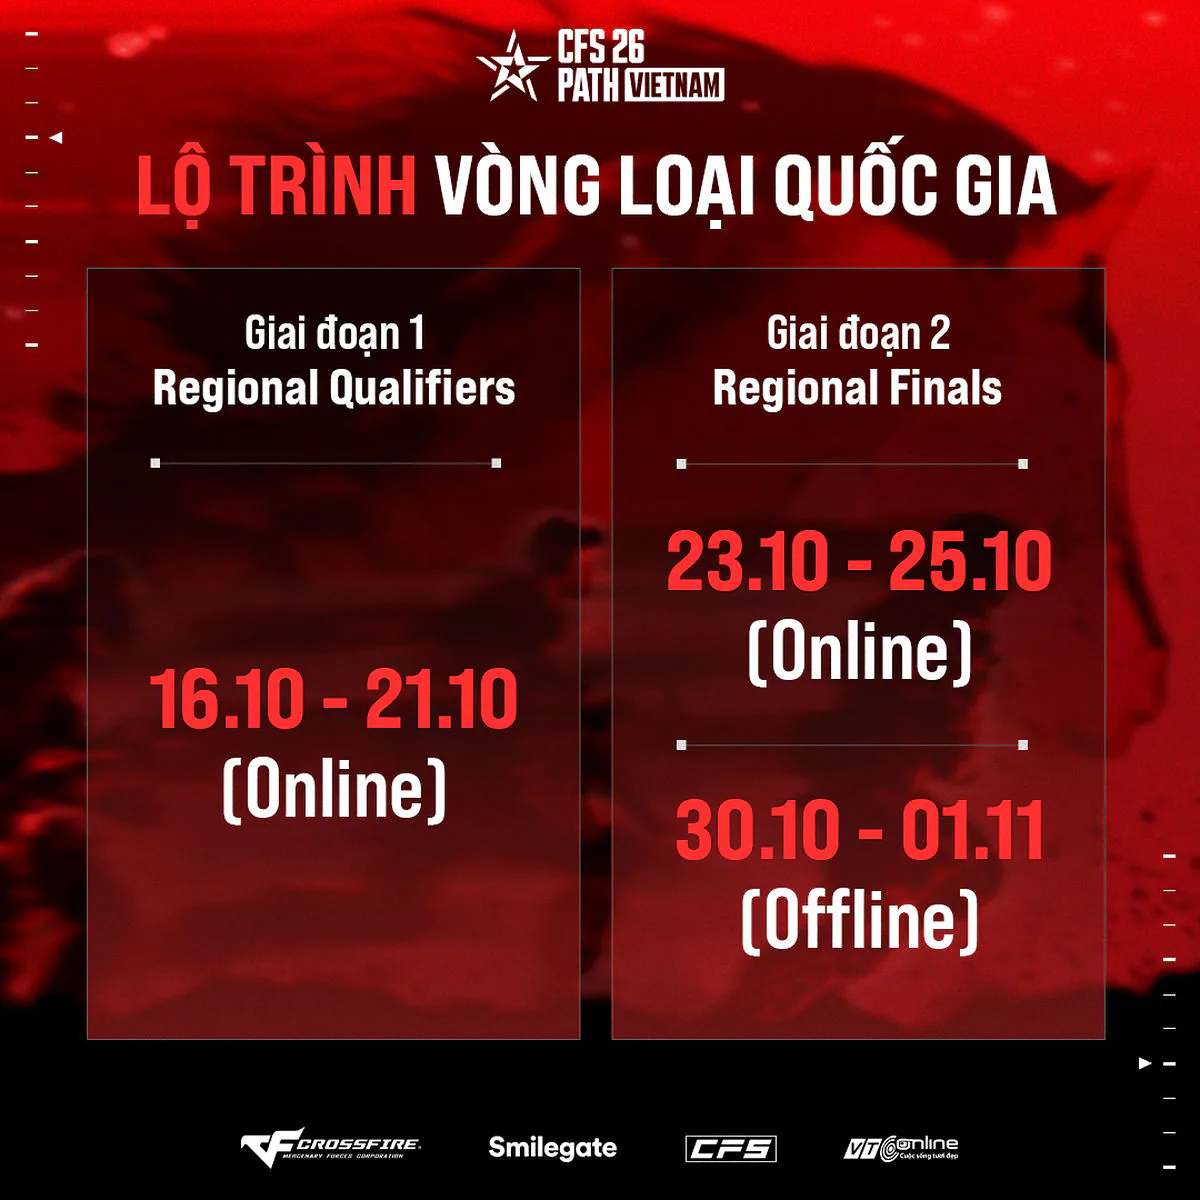
CFS 2026 Path Việt Nam được chia thành hai giai đoạn, với lộ trình tham dự dựa trên thứ hạng Point System của các đội tuyển.

CFS 2026 Path Vietnam chính thức khởi tranh với 5 nhà tài trợ uy tín đồng hành 11

Giai đoạn 1 – Vòng loại Khu vực diễn ra từ ngày 16/10 đến 21/10/2026. Tám đội tuyển có thứ hạng Point System từ 5 đến 12 sẽ cạnh tranh để giành bốn suất bước tiếp vào Chung kết Quốc gia. Với số vé đi tiếp chỉ bằng một nửa số đội tham dự, giai đoạn mở màn hứa hẹn tạo ra áp lực lớn ngay từ những trận đấu đầu tiên.

Giai đoạn 2 – Chung kết Quốc gia diễn ra từ ngày 23/10 đến 01/11/2026, quy tụ tám đội tuyển. Bốn đội vượt qua vòng loại sẽ hội quân cùng bốn đội đứng đầu Point System, tạo nên cuộc đua trực tiếp tìm kiếm ba đại diện Việt Nam tham dự CFS 2026 Grand Finals.

Ưu thế về thứ hạng mang đến điểm xuất phát thuận lợi, nhưng tấm vé đến Vũ Hán vẫn đòi hỏi các đội tuyển phải thể hiện phong độ, sự chuẩn bị và bản lĩnh ở thời điểm quyết định.

Thể thức thi đấu thử thách chiều sâu chiến thuật

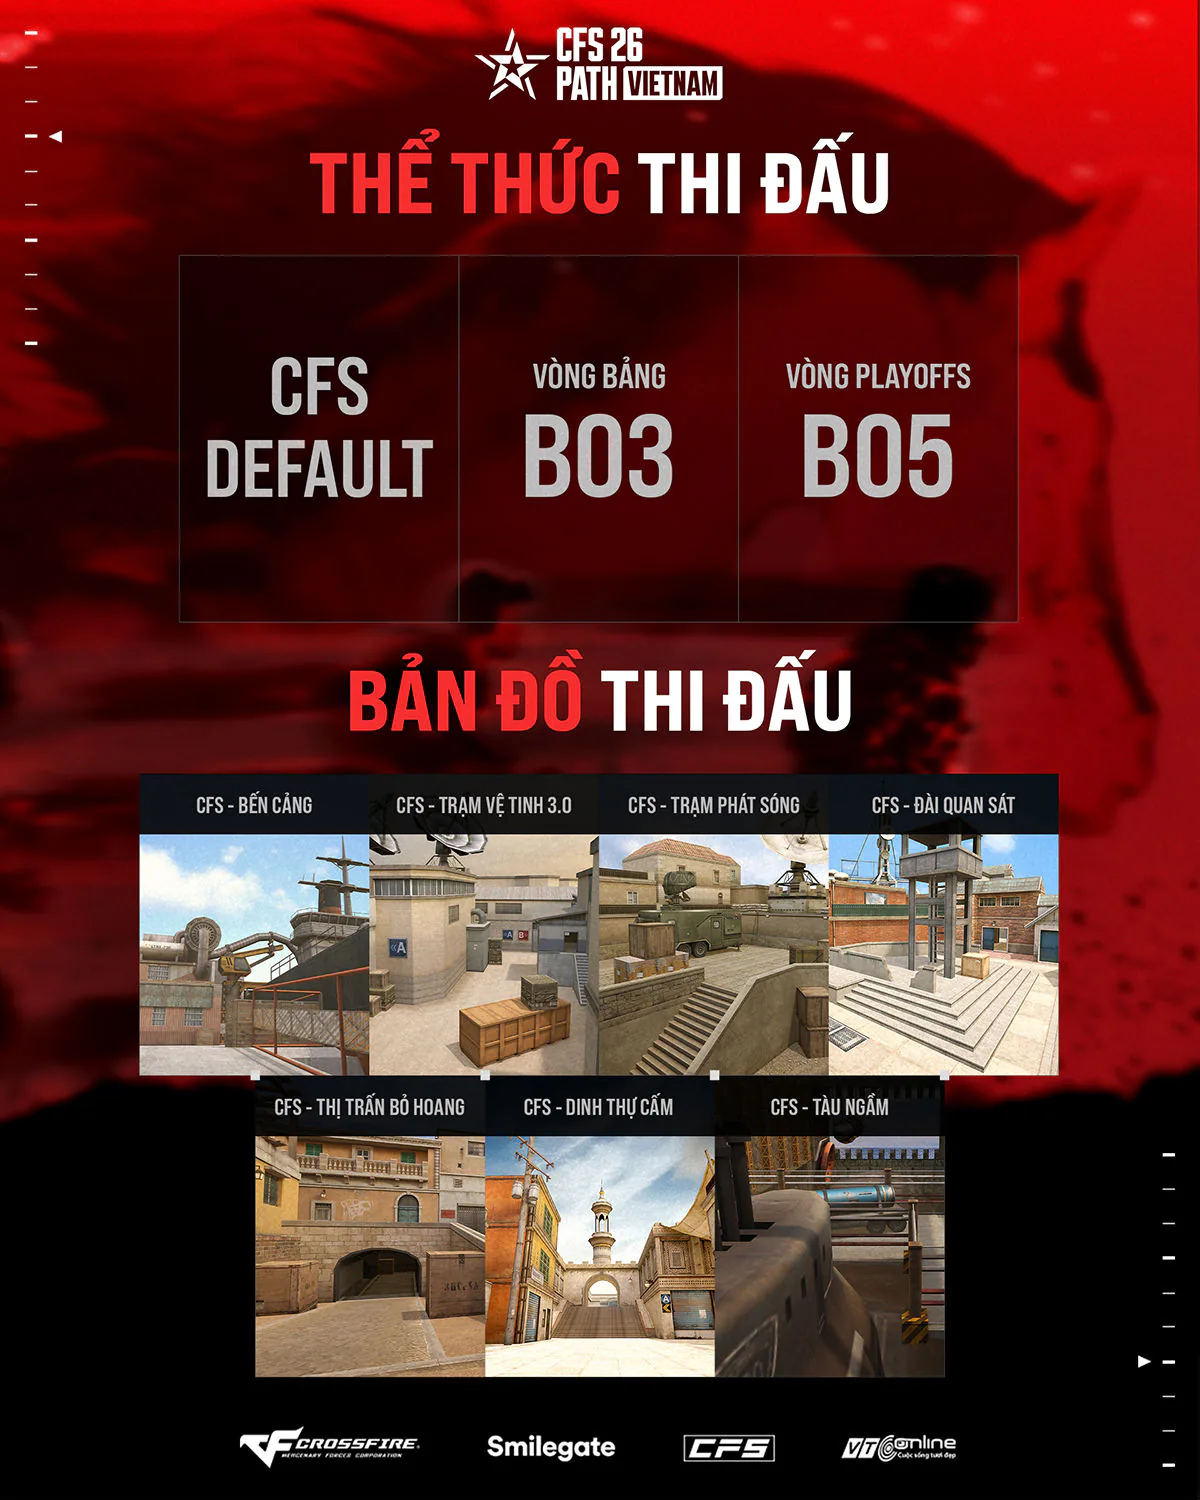
Giải đấu áp dụng luật CFS Default, với các trận đấu BO3 tại vòng bảng và BO5 tại vòng Playoffs. Thể thức này đặt ra yêu cầu cao về khả năng thích nghi, sự ổn định và chiều sâu chiến thuật của từng đội.

CFS 2026 Path Vietnam chính thức khởi tranh với 5 nhà tài trợ uy tín đồng hành 12

Ở các loạt BO3, một khởi đầu thiếu tập trung có thể nhanh chóng đẩy đội tuyển vào thế khó. Khi bước vào BO5, thử thách tiếp tục gia tăng bởi các tuyển thủ phải duy trì khả năng phối hợp, sức bền tâm lý và chất lượng xử lý trong những cuộc đối đầu kéo dài.

Đáng chú ý, Trạm Vệ Tinh 3.0 sẽ là bản đồ mới xuất hiện tại CFS 2026 Path Việt Nam. Sự bổ sung này mở ra những bài toán chiến thuật mới, đồng thời tạo cơ hội cho các đội tuyển khai thác yếu tố bất ngờ để giành lợi thế.

Danh sách thi đấu còn có sáu bản đồ quen thuộc gồm Bến Cảng, Trạm Phát Sóng, Đài Quan Sát, Thị Trấn Bỏ Hoang, Dinh Thự Cấm và Tàu Ngầm. Khả năng chuẩn bị trên toàn bộ hệ thống bản đồ sẽ là yếu tố quan trọng trong hành trình tiến sâu.

100.000 USD tiền thưởng và cơ hội khẳng định vị thế

CFS 2026 Path Việt Nam sở hữu tổng giải thưởng 100.000 USD. Trong đó, nhà vô địch nhận 20.000 USD, đội Á quân nhận 17.000 USD và đội hạng Ba nhận 15.000 USD. Cả ba đội đứng đầu đồng thời giành quyền tham dự CFS 2026 Grand Finals tại Vũ Hán, Trung Quốc.

CFS 2026 Path Vietnam chính thức khởi tranh với 5 nhà tài trợ uy tín đồng hành 13

Bên cạnh giá trị tiền thưởng, cơ hội góp mặt tại Chung kết Thế giới là động lực lớn đối với mỗi tuyển thủ. Đó là nơi họ được đối đầu những đội tuyển hàng đầu, kiểm chứng năng lực và tiếp tục xây dựng dấu ấn trong sự nghiệp.

Bởi vậy, cuộc đua tại CFS 2026 Path Việt Nam mang ý nghĩa vượt ra ngoài từng trận thắng. Mỗi vòng đấu đều có thể trở thành bước ngoặt, đưa một tập thể đến gần hơn với mục tiêu quốc tế.

CFS 2026 Path Vietnam chính thức khởi tranh với 5 nhà tài trợ uy tín đồng hành 14

Cùng người hâm mộ tiếp sức cho hành trình chinh phục

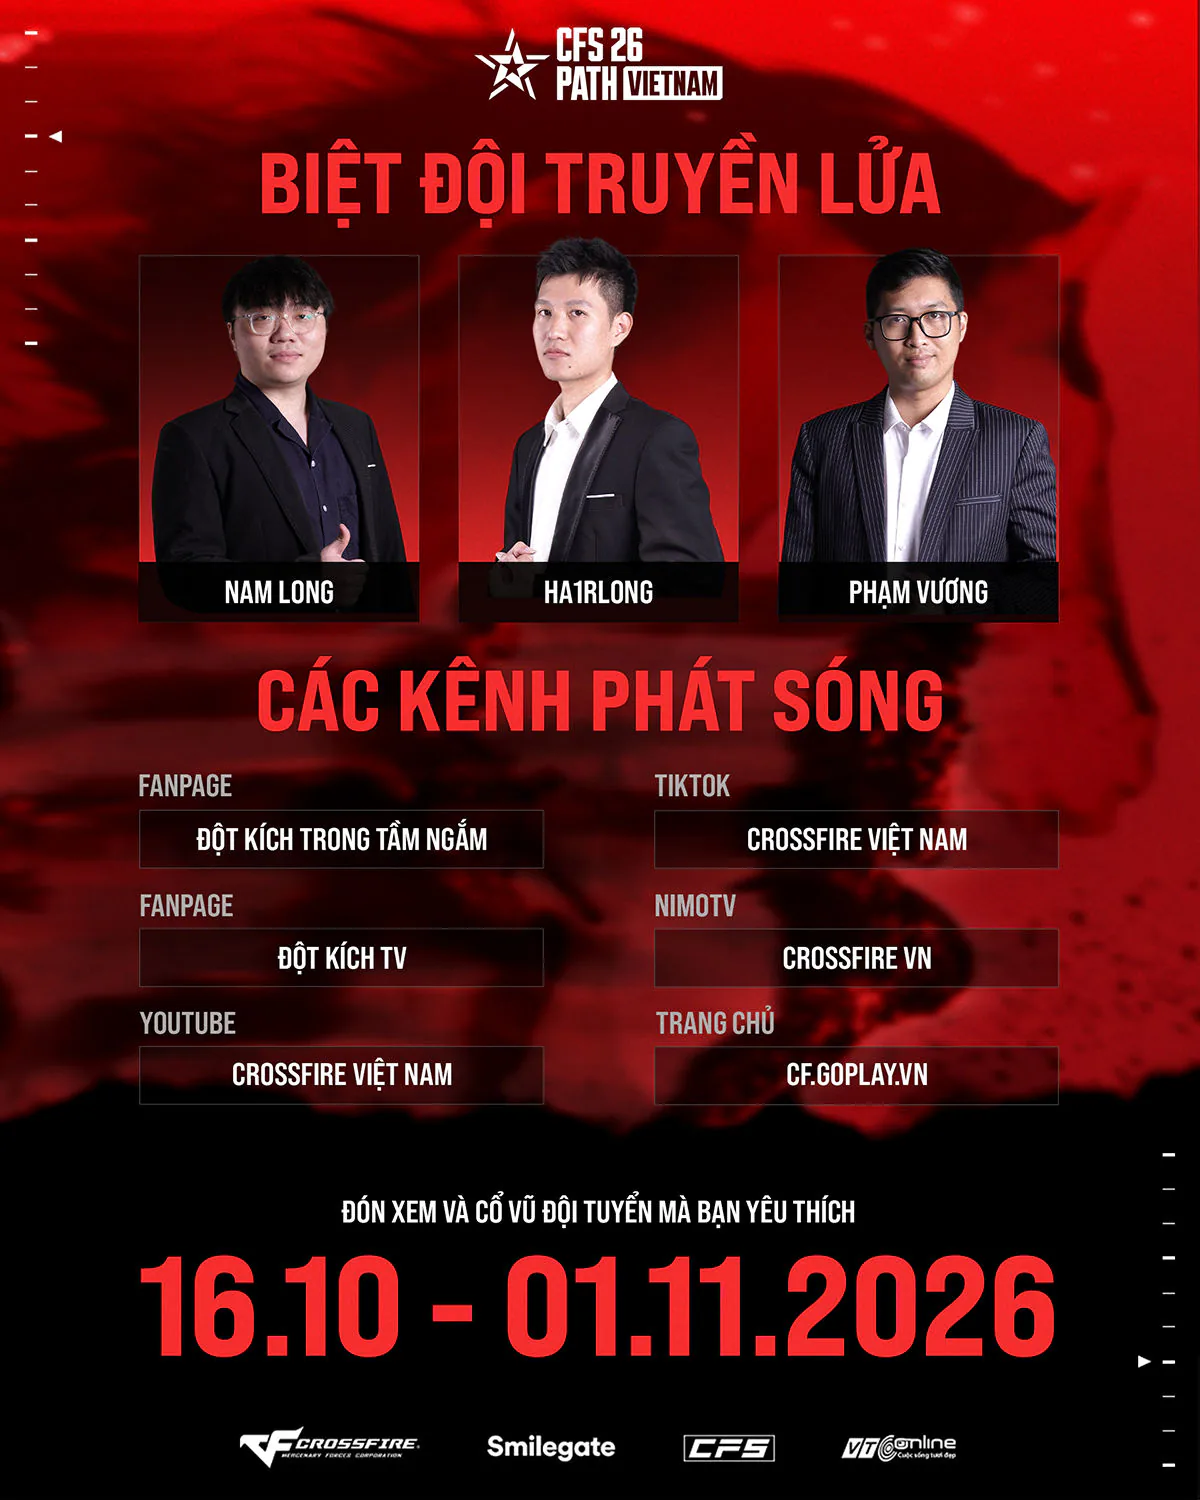
Đồng hành cùng giải đấu là bộ ba bình luận viên Nam Long, HA1RLONG và Phạm Vương. Những góc nhìn chiến thuật, phần bình luận sôi nổi và cảm xúc từ bàn caster sẽ giúp khán giả theo sát diễn biến, từ các pha clutch nghẹt thở đến khoảnh khắc định đoạt trận đấu.

Người hâm mộ có thể theo dõi CFS 2026 Path Việt Nam trên Fanpage Đột Kích Trong Tầm Ngắm, Đột Kích TV; YouTube và TikTok CrossFire Việt Nam; NimoTV CrossFire VN. Thông tin giải đấu được cập nhật tại cf.goplay.vn.

Trên hành trình ấy, mỗi tiếng cổ vũ và lời động viên đều tiếp thêm sức mạnh cho các tuyển thủ. Bởi không có con đường nào tự dẫn đến vinh quang, không có chiến thắng nào được trao sẵn và không ai có thể chinh phục một mình.

Từ ngày 16/10, hãy cùng đội tuyển bạn yêu bước vào cuộc đua đến Vũ Hán. Ride Together, Rise Together – Cùng tiến bước, cùng vươn tới đỉnh cao!

Thông tin thêm về Crossfire Việt Nam có thể theo dõi tại đây:

Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark

0

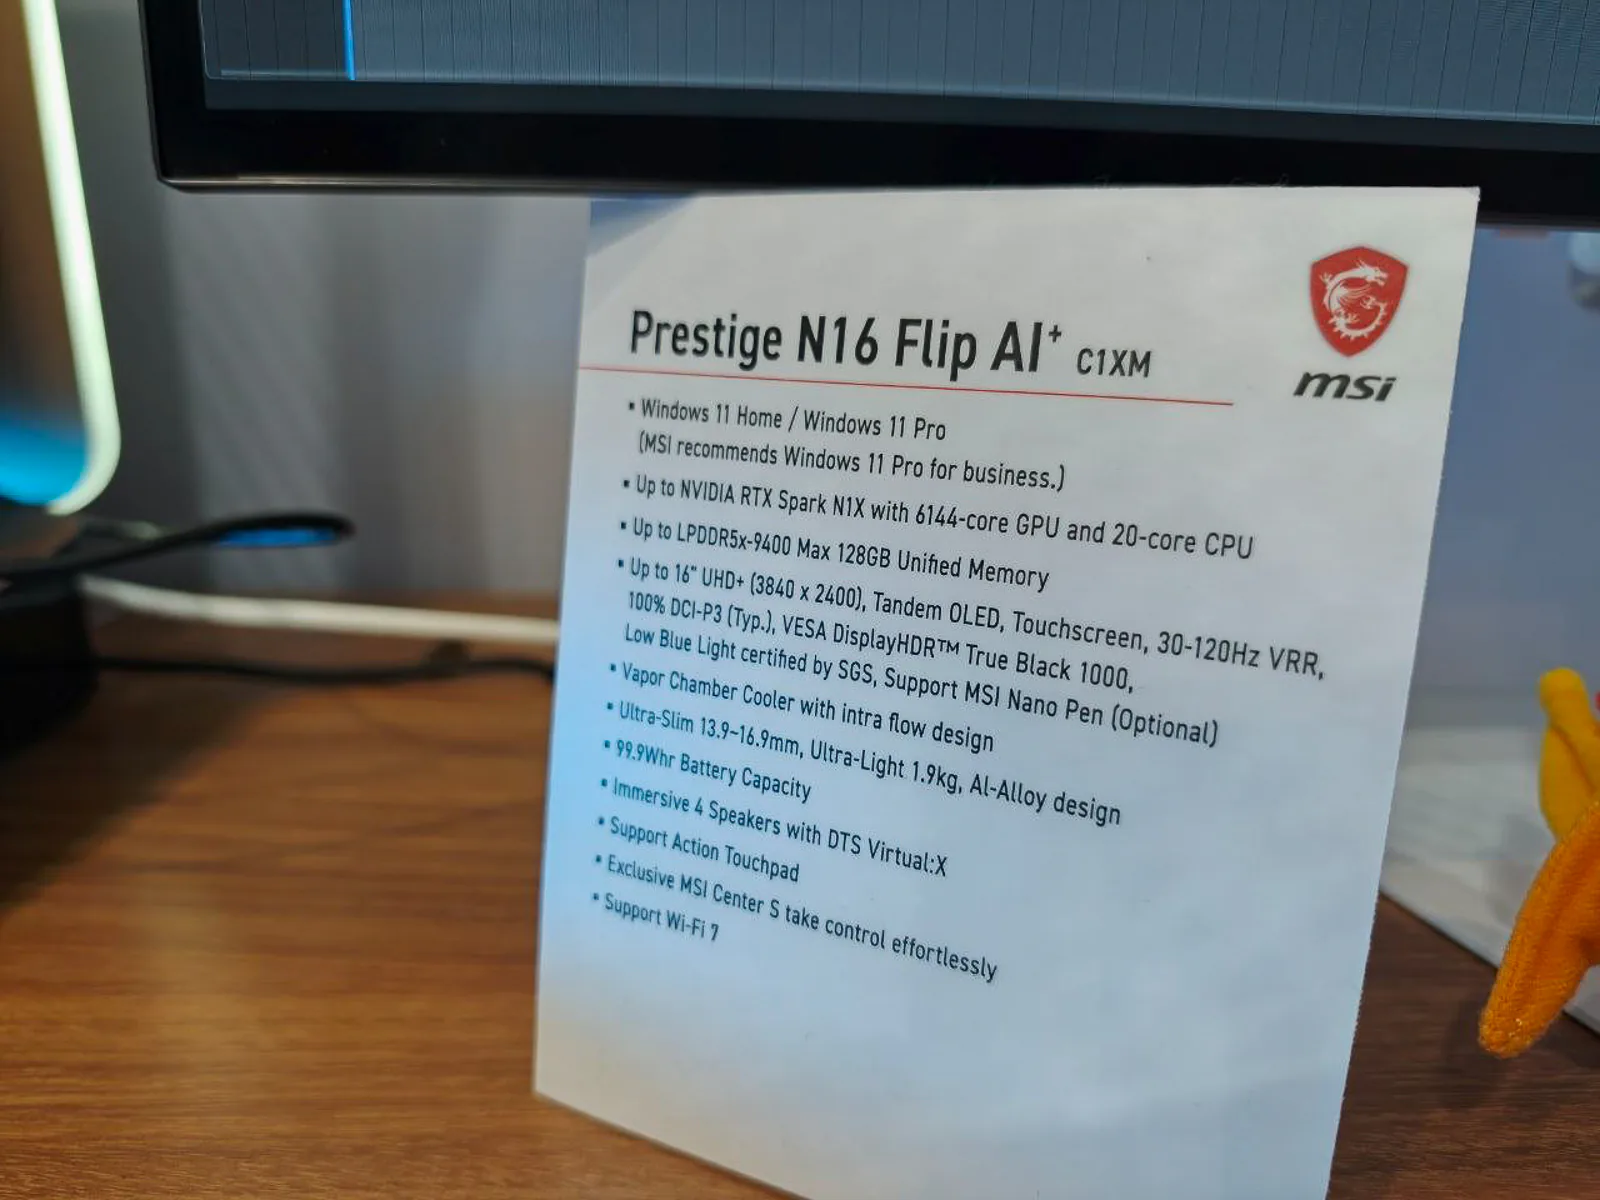
Không chỉ gây chú ý nhờ thiết kế xoay gập 360 độ và màn hình OLED 4K, MSI Prestige N16 Flip AI+ còn sở hữu nền tảng NVIDIA RTX Spark với GPU Blackwell 6.144 nhân CUDA, hướng đến những người dùng cần một thiết bị linh hoạt cho công việc sáng tạo và AI.

MSI Prestige N16 Flip AI+: Khi laptop 2-trong-1 bước vào cuộc chơi AI

Xuất hiện với kiểu dáng của một chiếc laptop cao cấp dành cho công việc, MSI Prestige N16 Flip AI+ (C1XM) mang đến một cách tiếp cận khá thú vị đối với dòng máy tính AI thế hệ mới. Thay vì tập trung vào thiết kế gaming hầm hố hoặc kiểu dáng workstation truyền thống, MSI lựa chọn bộ khung mỏng, màn hình cảm ứng xoay gập và cấu hình dựa trên nền tảng NVIDIA RTX Spark.

Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 15

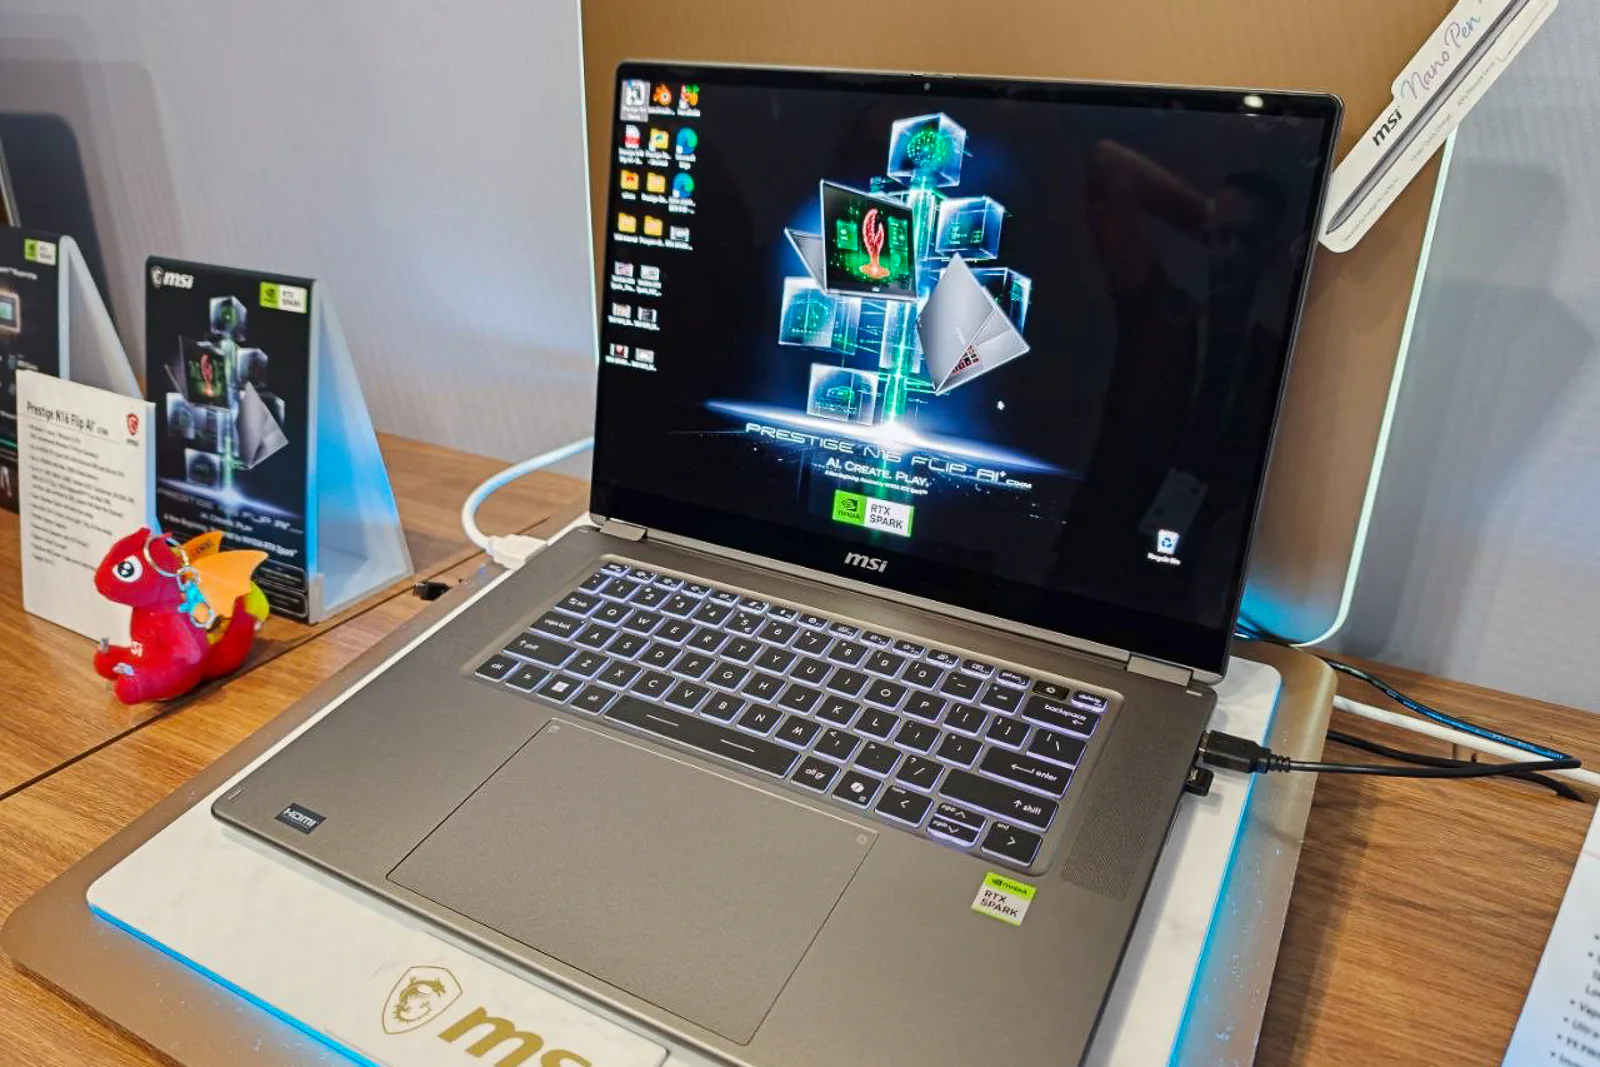
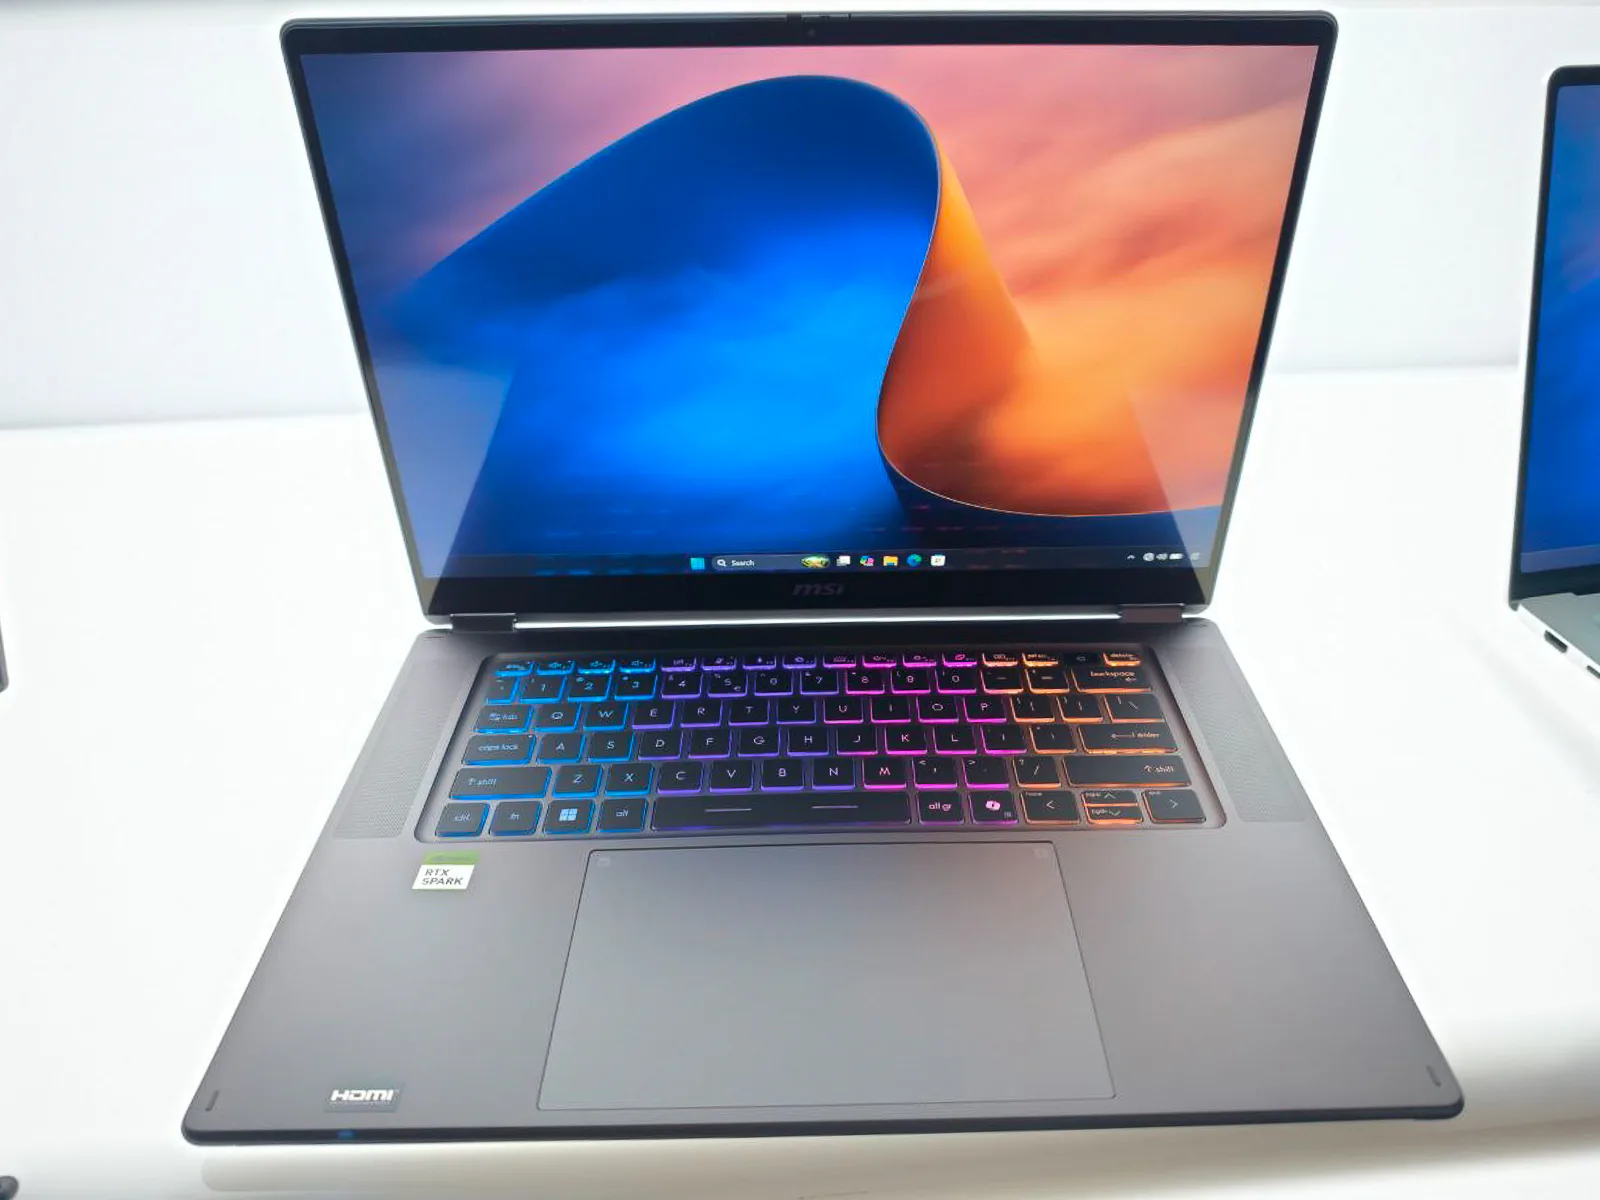
Điều này khiến Prestige N16 Flip AI+ trở thành một sản phẩm đáng chú ý khi kết hợp khả năng làm việc của laptop thông thường, tính linh hoạt của thiết bị 2-trong-1 và năng lực xử lý AI từ kiến trúc Blackwell. Qua những hình ảnh thực tế, máy sở hữu ngoại hình khá tối giản với tông màu xám kim loại, phần nắp màn hình phẳng và các đường bo cong nhẹ ở cạnh. Logo MSI được đặt tinh tế ở viền dưới màn hình, trong khi tổng thể thiết kế không có quá nhiều chi tiết trang trí.

Thiết kế xoay gập 360 độ, linh hoạt hơn laptop truyền thống

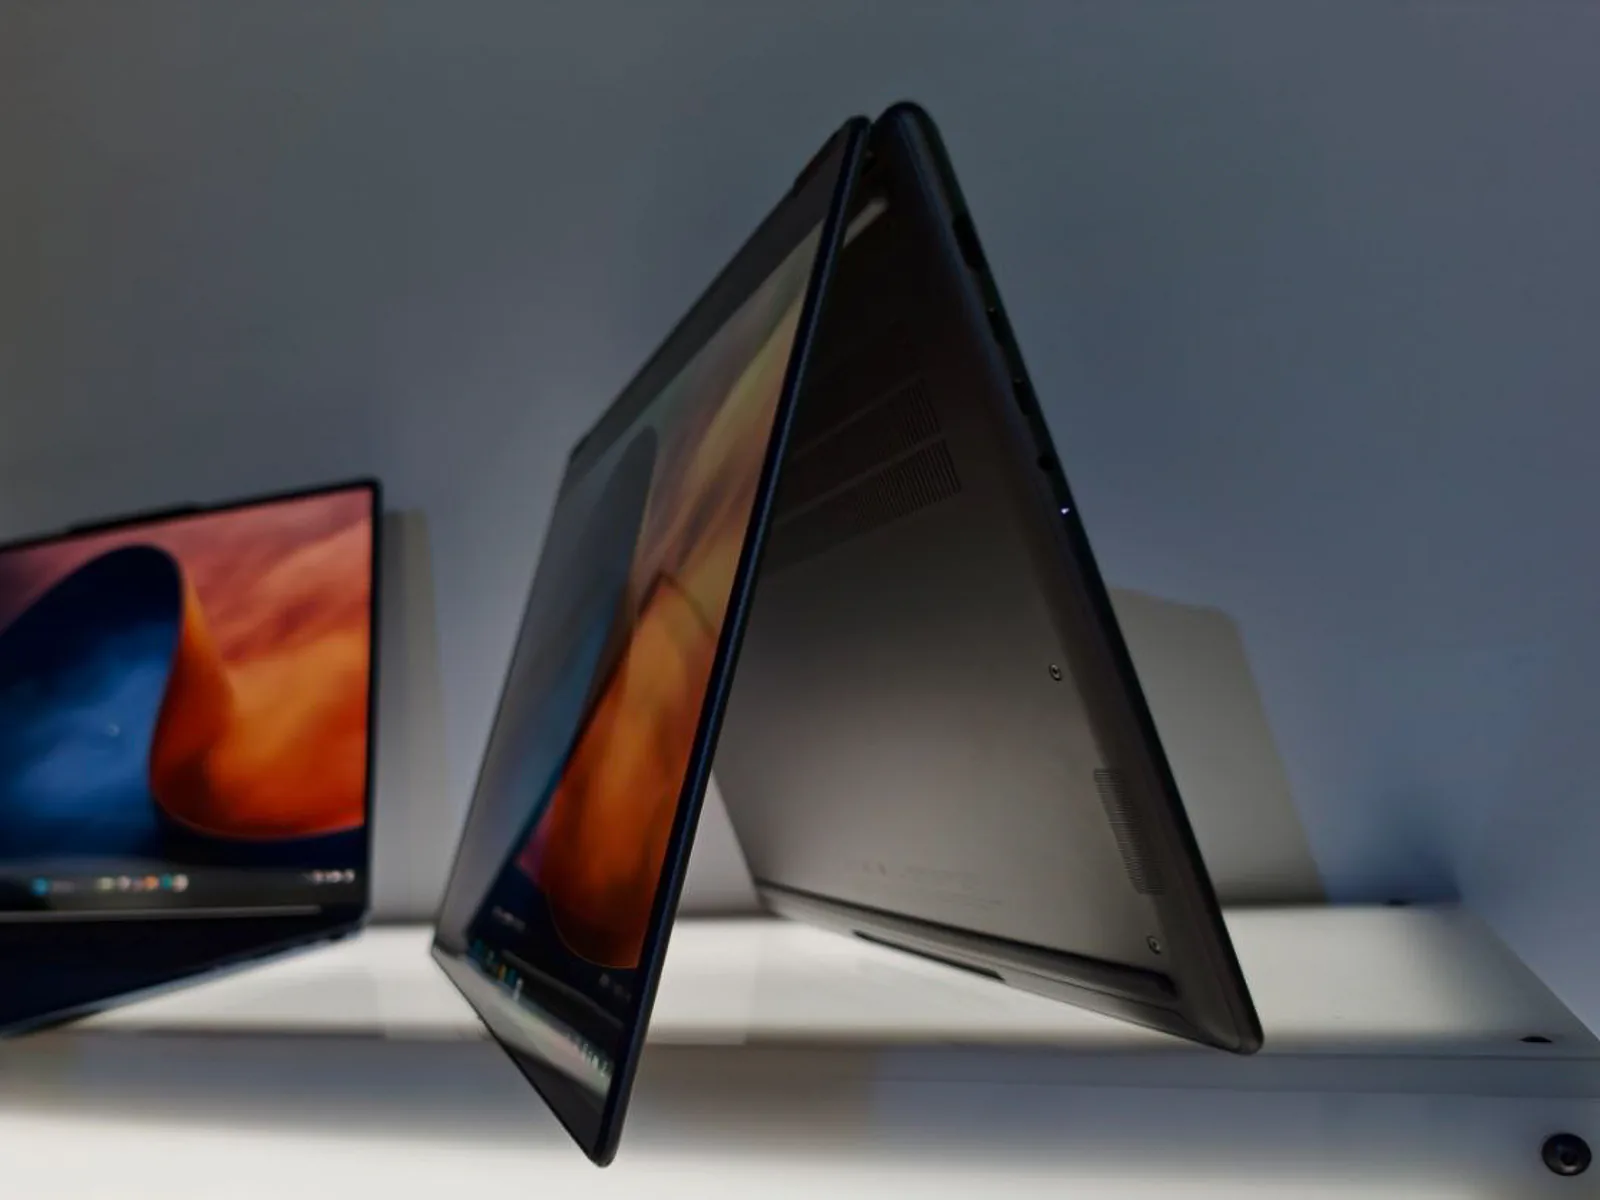
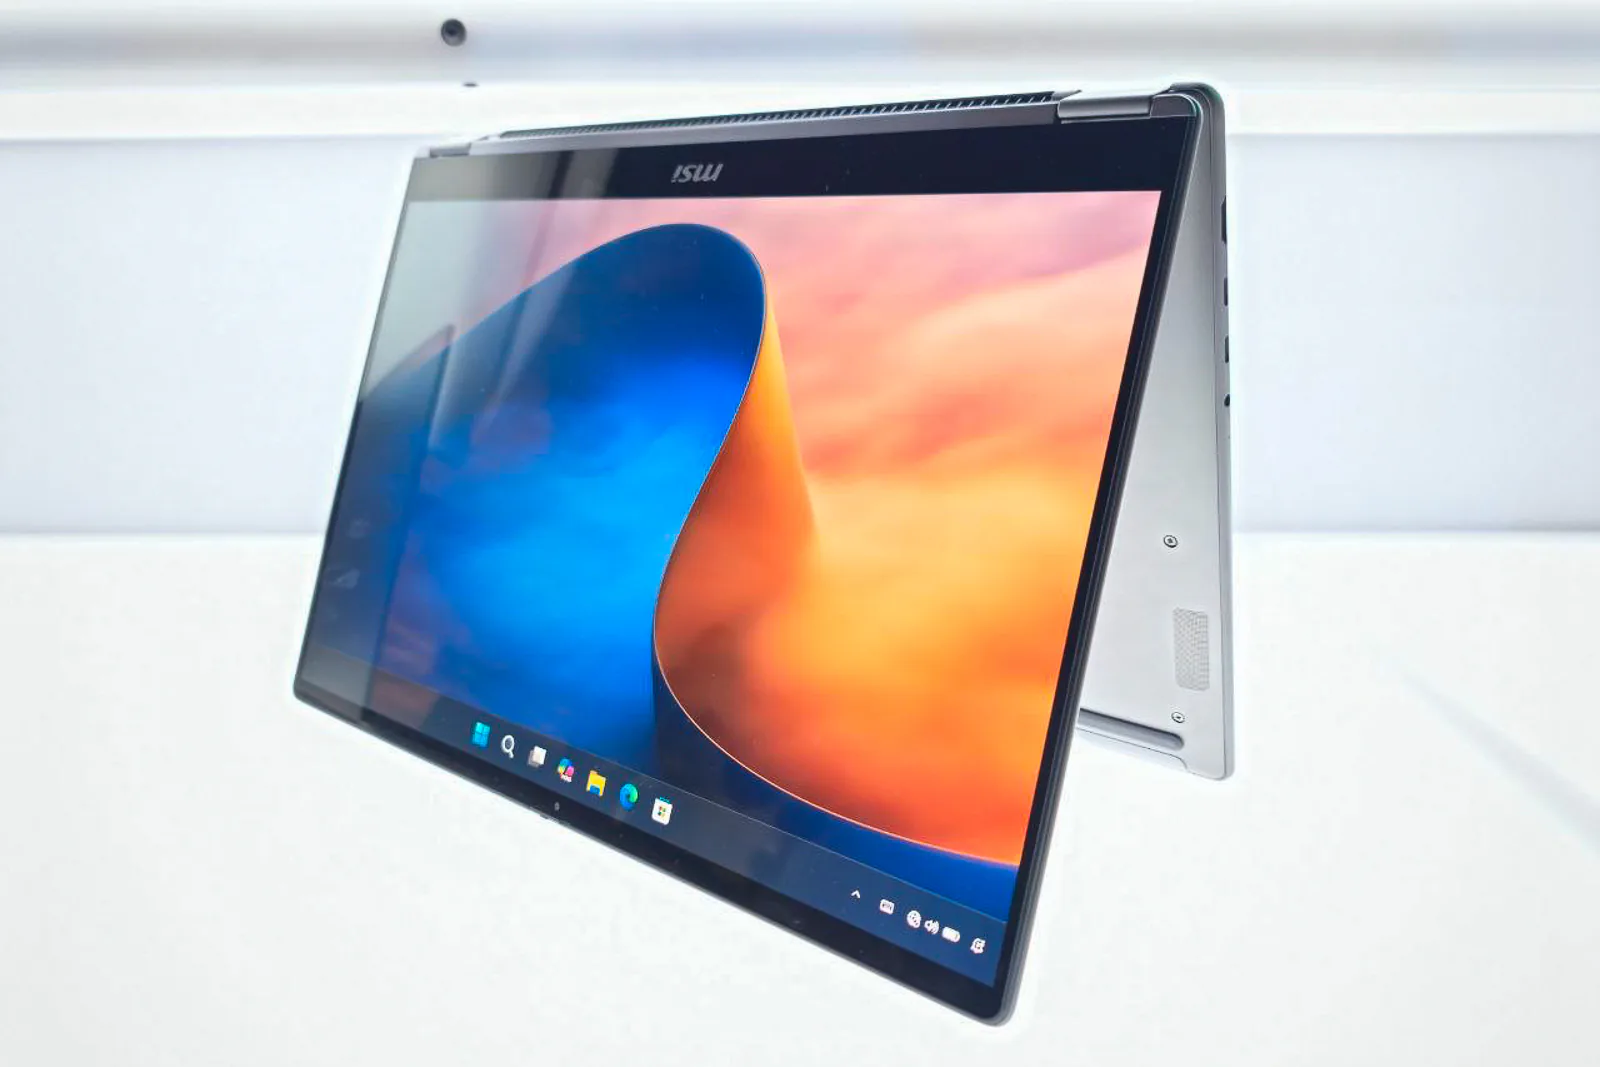
Điểm khác biệt dễ nhận thấy nhất của Prestige N16 Flip AI+ chính là hệ thống bản lề cho phép màn hình xoay gập 360 độ.

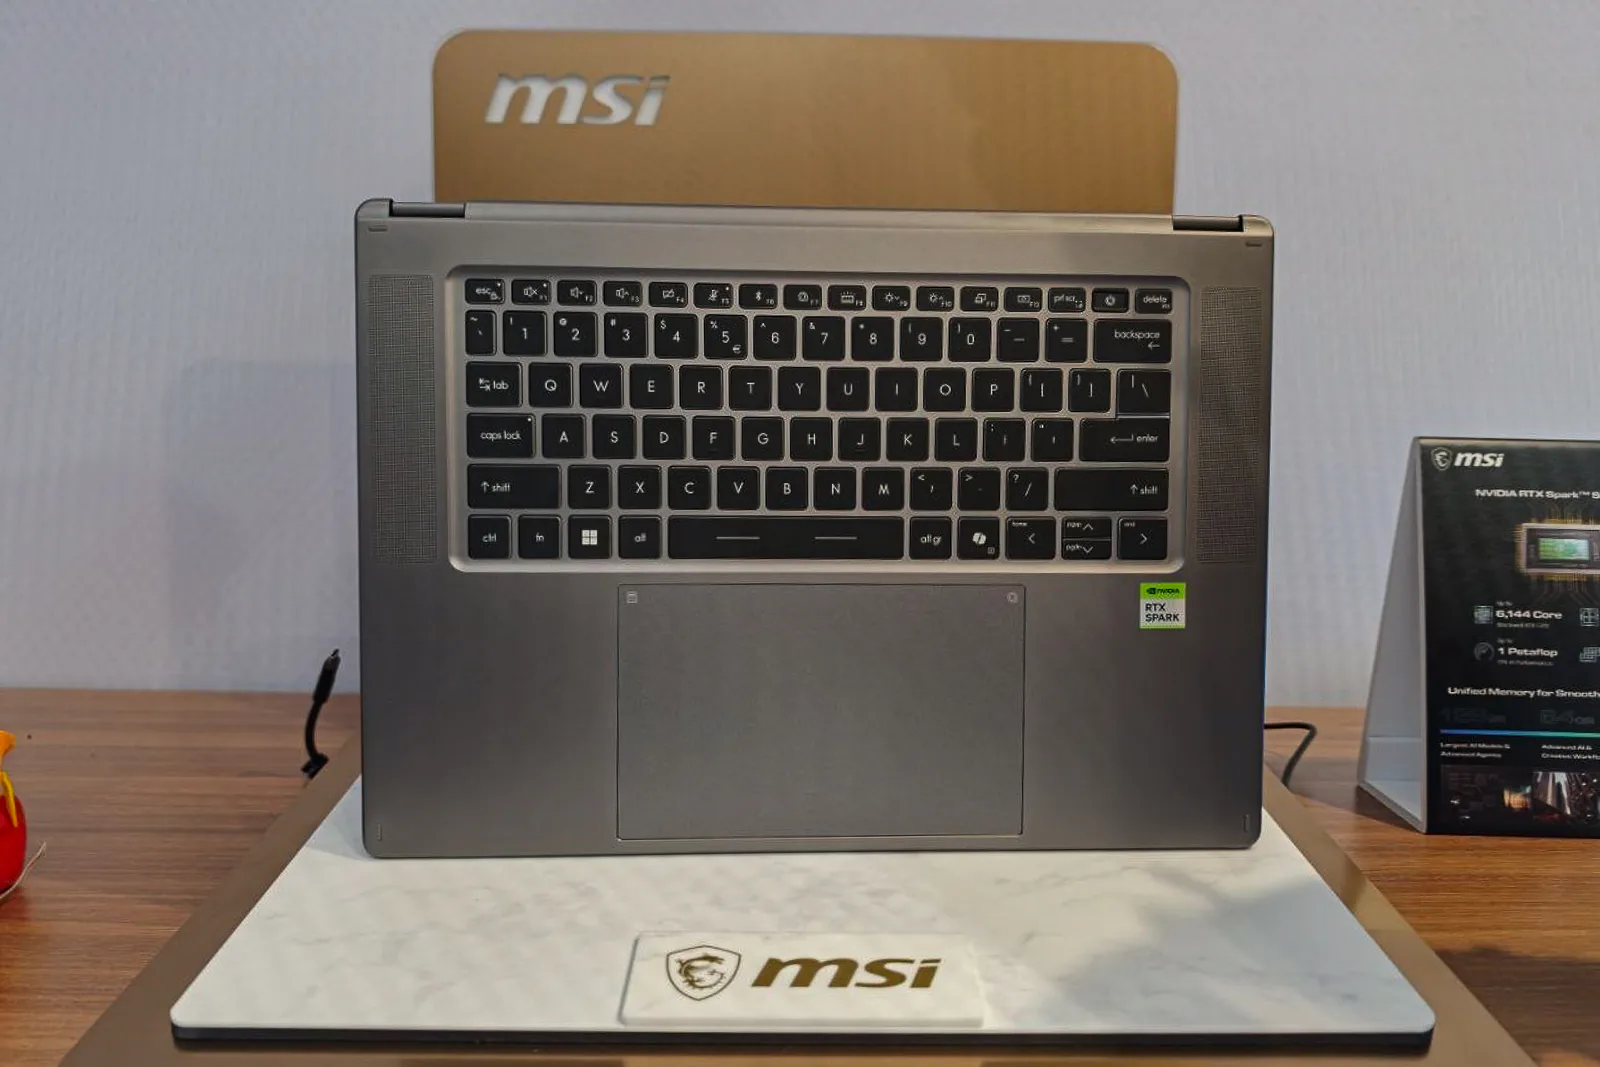
Ở trạng thái thông thường, máy hoạt động như một chiếc laptop 16 inch với bàn phím và touchpad kích thước lớn. Khi cần trình chiếu hoặc tương tác trực tiếp với nội dung, người dùng có thể gập màn hình ra phía sau để chuyển sang chế độ dựng lều hoặc sử dụng như một chiếc máy tính bảng.

Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 16 Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 17

Thiết kế này đặc biệt hữu ích đối với những người làm sáng tạo nội dung, thiết kế hoặc thường xuyên thuyết trình. Việc có thể thay đổi tư thế sử dụng giúp Prestige N16 Flip AI+ linh hoạt hơn đáng kể so với những mẫu laptop truyền thống.

Thân máy sử dụng hợp kim nhôm, có độ mỏng từ 13,9 đến 16,9 mm và khối lượng khoảng 1,9 kg. Đây là những con số khá đáng chú ý đối với một thiết bị sở hữu màn hình 16 inch, đặc biệt khi bên trong còn tích hợp nền tảng xử lý AI hiệu năng cao.

Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 18

Tất nhiên, khối lượng gần 2 kg đồng nghĩa thiết bị phù hợp hơn với việc đặt trên bàn hoặc sử dụng ở chế độ dựng lều, thay vì cầm liên tục bằng một tay như tablet thông thường.

Màn hình Tandem OLED 4K, điểm nhấn cho trải nghiệm sáng tạo

Một trong những trang bị nổi bật nhất của MSI Prestige N16 Flip AI+ là màn hình cảm ứng Tandem OLED kích thước 16 inch, độ phân giải UHD+ 3840 x 2400 pixel. Tỷ lệ 16:10 mang lại không gian hiển thị theo chiều dọc rộng rãi, phù hợp cho các công việc chỉnh sửa hình ảnh, dựng nội dung, lập trình và xử lý tài liệu.

Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 19

Màn hình hỗ trợ tần số quét biến thiên trong khoảng 30–120 Hz, độ phủ màu 100% DCI-P3 (điển hình), cùng chứng nhận VESA DisplayHDR True Black 1000. Công nghệ Tandem OLED cũng là một điểm đáng quan tâm. Khác với OLED truyền thống, cách tiếp cận này sử dụng cấu trúc nhiều lớp phát sáng nhằm cải thiện khả năng hiển thị, đặc biệt về độ sáng và hiệu quả hoạt động.

Với người dùng sáng tạo nội dung, sự kết hợp giữa độ phân giải cao, khả năng tái tạo màu sắc rộng và công nghệ OLED sẽ là lợi thế đáng kể khi xử lý hình ảnh hoặc video HDR. Tuy nhiên, độ chính xác màu thực tế vẫn cần được kiểm tra bằng thiết bị chuyên dụng. Màn hình cũng hỗ trợ MSI Nano Pen dưới dạng phụ kiện tùy chọn, giúp mở rộng khả năng ghi chú, phác thảo và tương tác trực tiếp trên bề mặt cảm ứng.

Bàn phím gọn gàng, touchpad lớn và kết nối đầy đủ

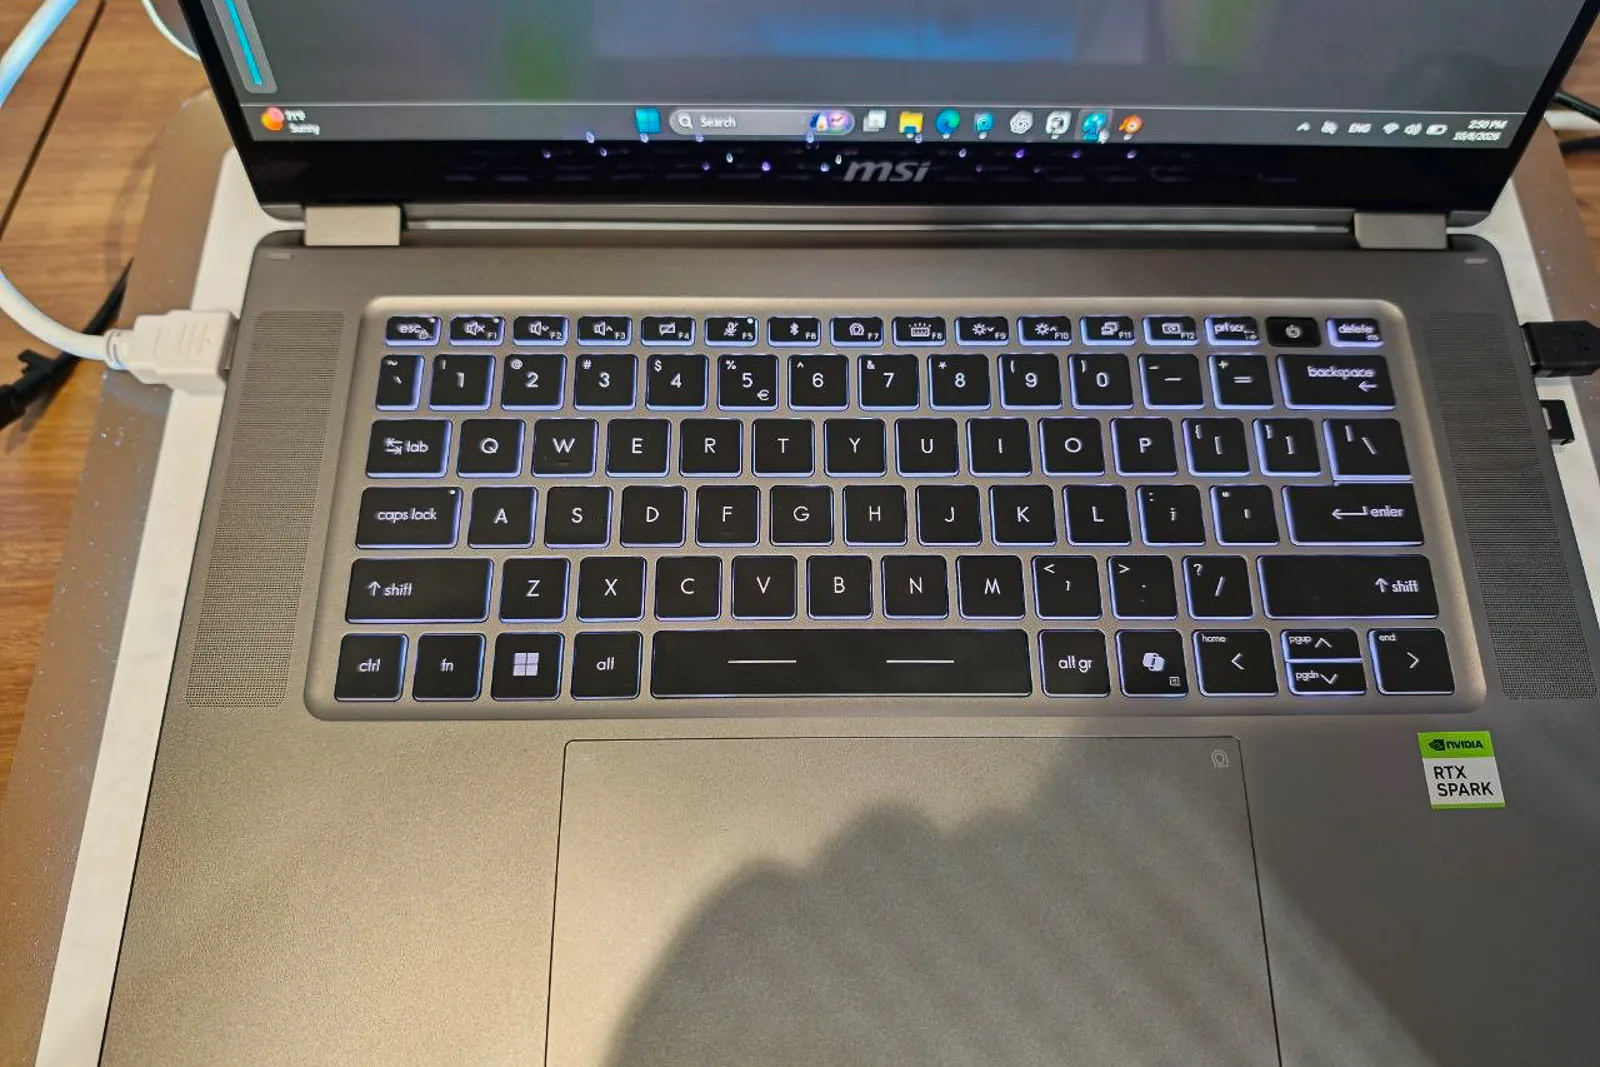
Quan sát khu vực bàn phím, Prestige N16 Flip AI+ sử dụng bố cục không có cụm phím số riêng. Thay vào đó, MSI bố trí hai dải loa lớn ở hai bên, tạo nên thiết kế cân đối. Bàn phím có đèn nền, các phím được sắp xếp tương đối rộng rãi. Điểm thú vị là khu vực phím chức năng tích hợp nhiều phím tắt phục vụ nhu cầu sử dụng hằng ngày.

Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 20

Phía dưới là touchpad kích thước lớn, chiếm phần đáng kể của khu vực kê tay. MSI cũng trang bị tính năng Action Touchpad, hướng đến việc thao tác nhanh với các chức năng và tiện ích của hệ thống.

Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 21

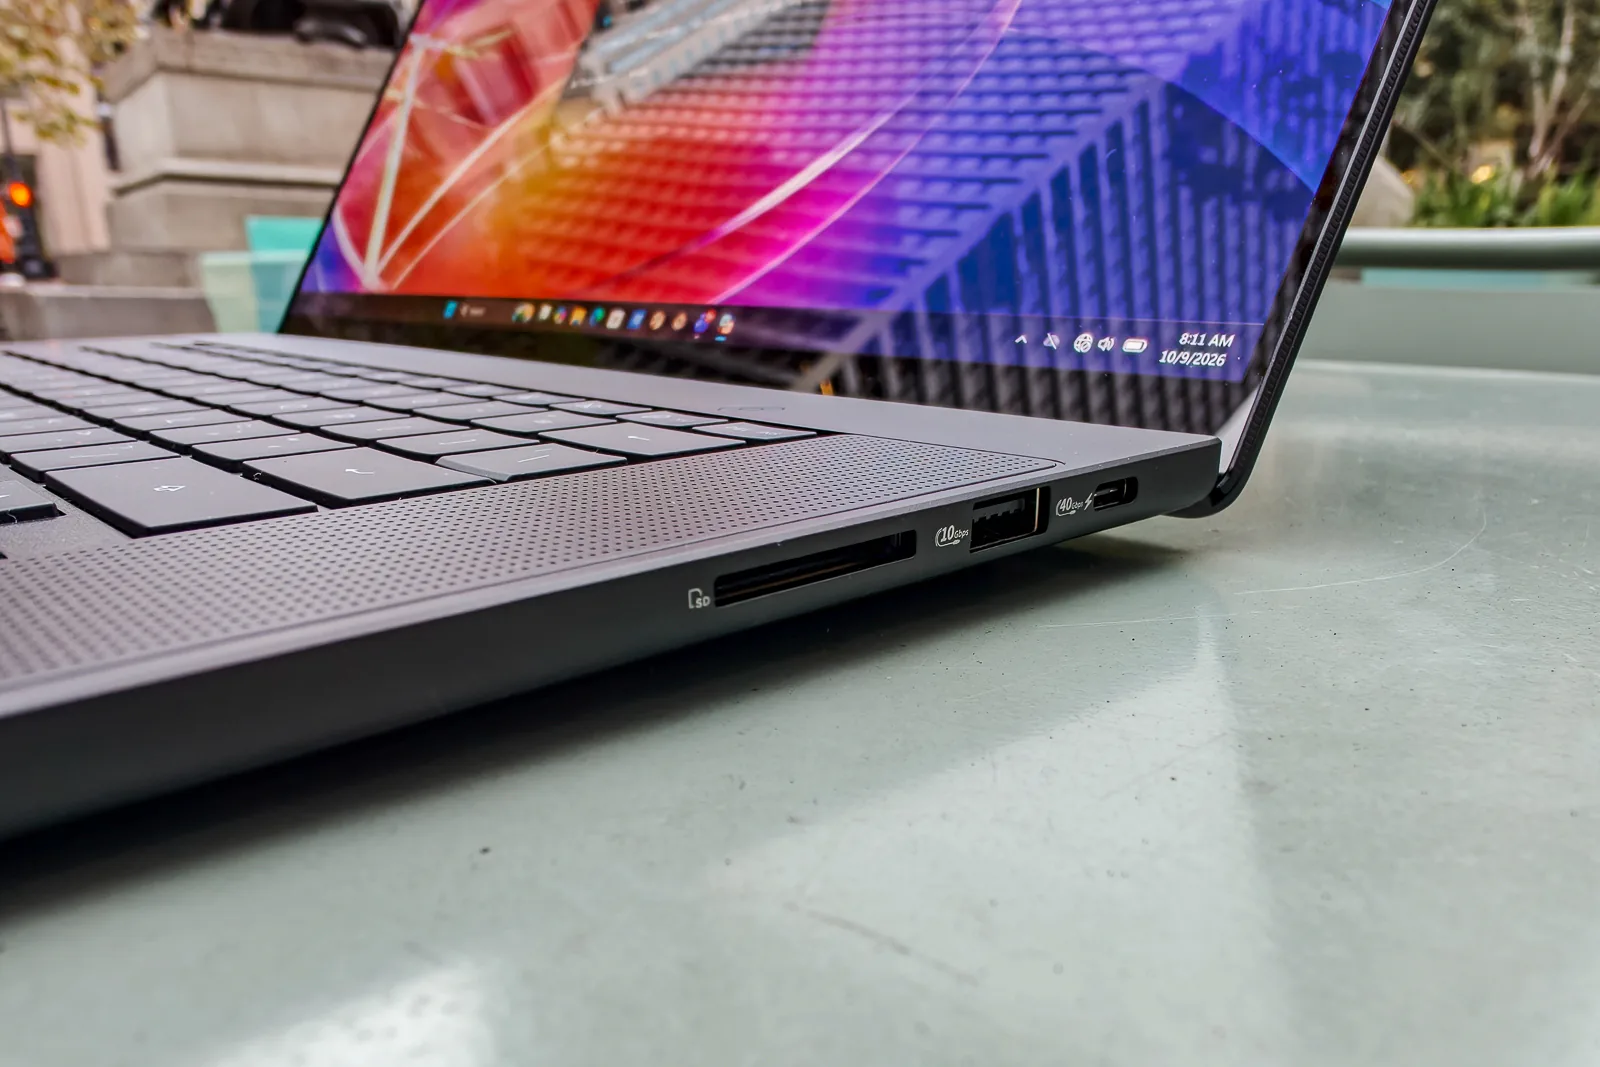
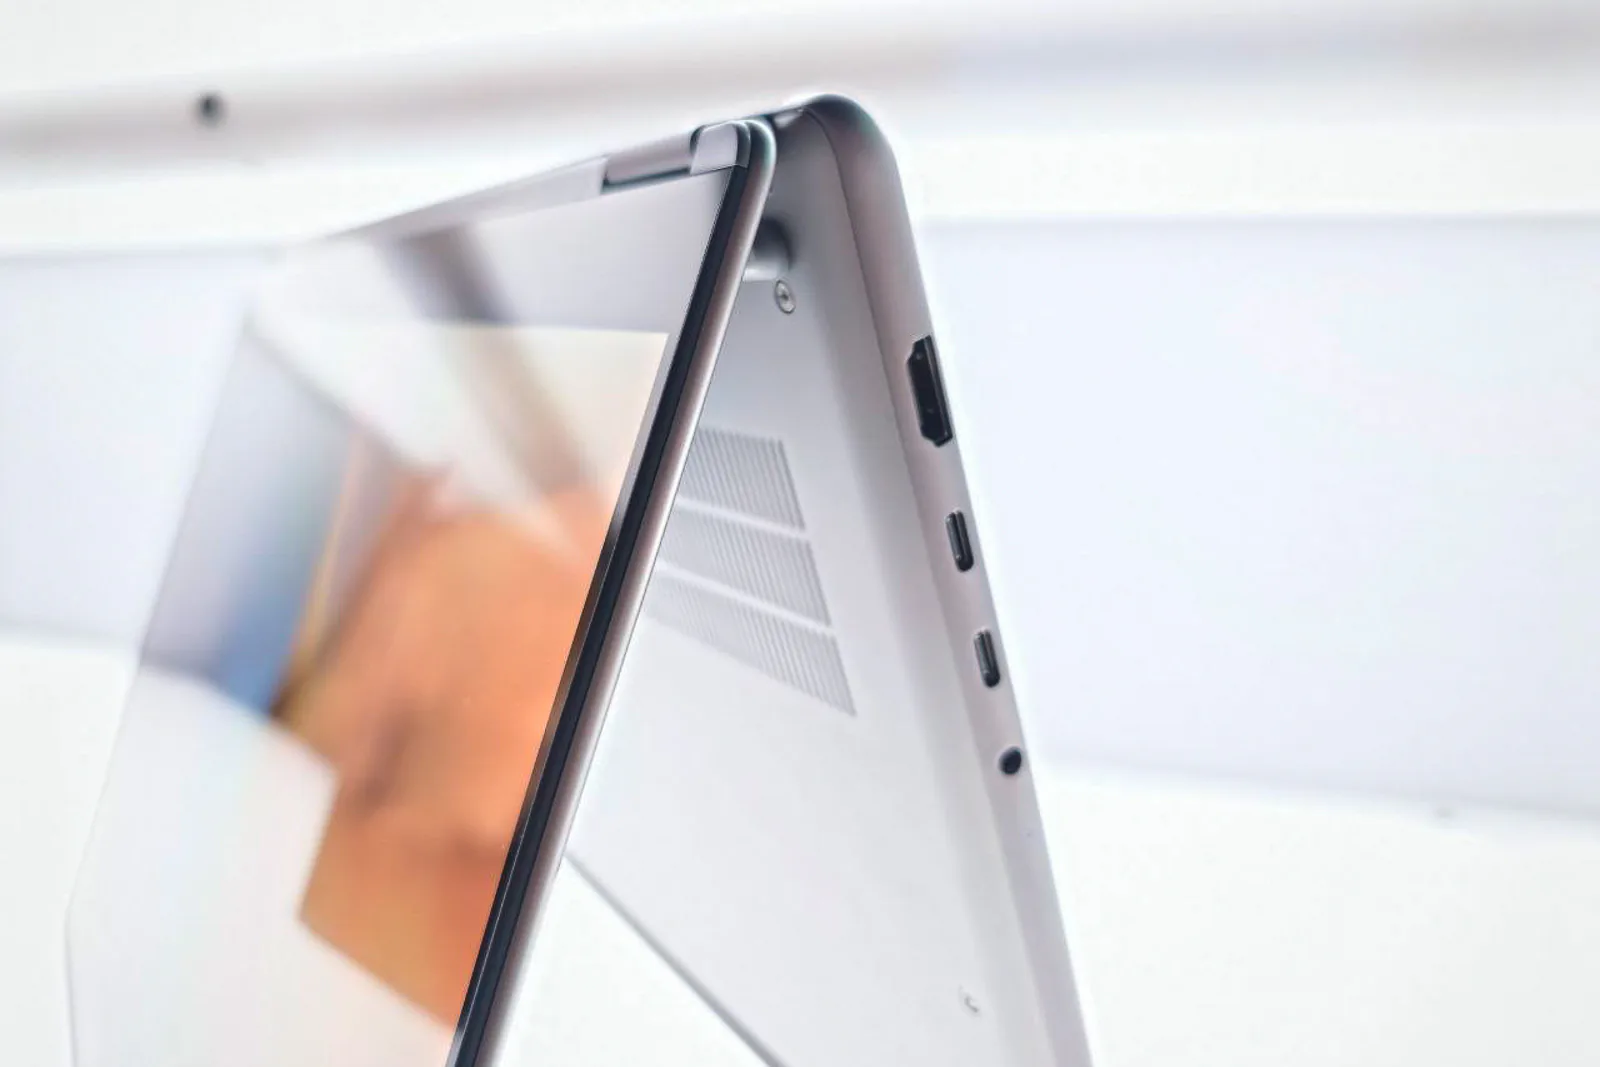
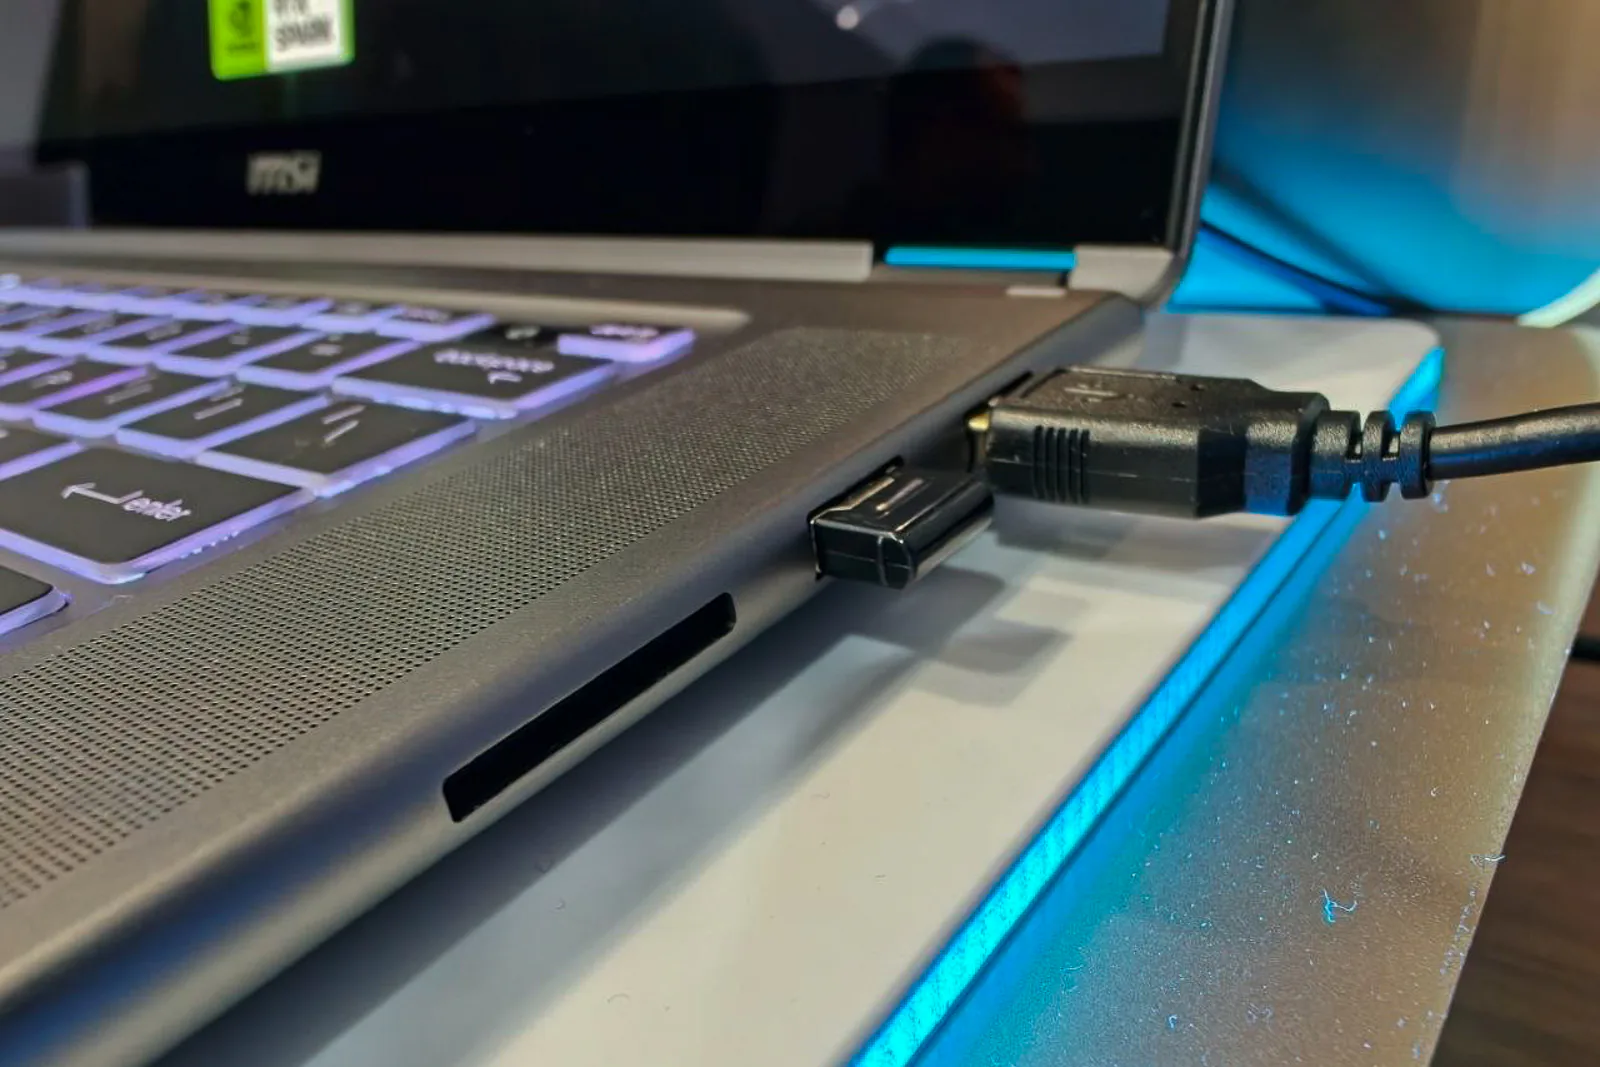
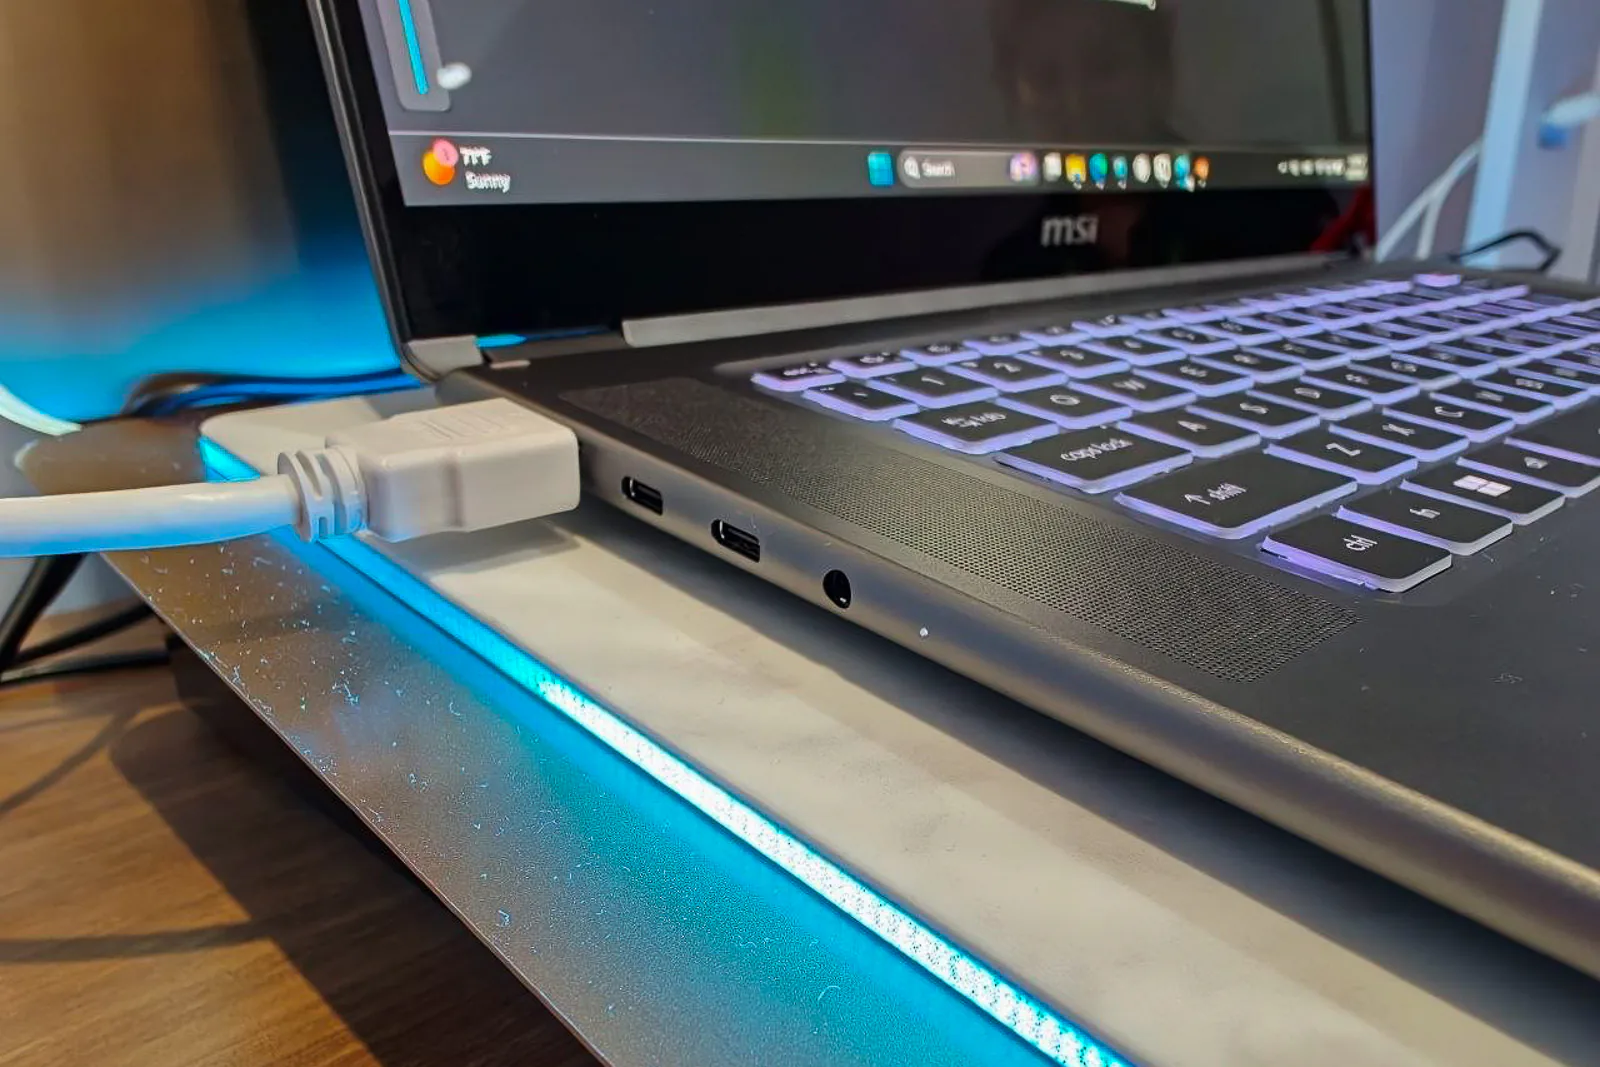
Về kết nối, máy được trang bị cổng HDMI, hai cổng USB-C, jack âm thanh 3,5 mm, USB-A và khe đọc thẻ nhớ. Việc duy trì các kết nối vật lý phổ biến là một điểm cộng đối với người làm nội dung, đặc biệt khi cần kết nối màn hình ngoài, thiết bị lưu trữ hoặc các phụ kiện phục vụ công việc.

NVIDIA RTX Spark: Sức mạnh Blackwell bên trong laptop xoay gập

Nếu thiết kế xoay gập và màn hình Tandem OLED là những yếu tố gây ấn tượng về ngoại hình, nền tảng NVIDIA RTX Spark mới chính là phần cứng tạo nên sự khác biệt cho Prestige N16 Flip AI+. Theo thông tin được MSI công bố, thiết bị có tùy chọn NVIDIA RTX Spark N1X, tích hợp CPU 20 nhân cùng GPU kiến trúc Blackwell sở hữu 6.144 nhân CUDA.

Đây là hướng tiếp cận đáng chú ý khi CPU và GPU được tích hợp trong một nền tảng xử lý, kết hợp với kiến trúc bộ nhớ hợp nhất thay vì dựa hoàn toàn vào mô hình CPU và GPU rời thông thường. MSI cho biết hệ thống hỗ trợ bộ nhớ hợp nhất LPDDR5x-9400 với dung lượng tối đa 128 GB. Dung lượng bộ nhớ lớn có ý nghĩa quan trọng đối với những ứng dụng AI, đặc biệt là các tác vụ cần xử lý mô hình ngôn ngữ lớn hoặc khối lượng dữ liệu vượt quá giới hạn bộ nhớ đồ họa trên những dòng GPU phổ thông.

Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 22

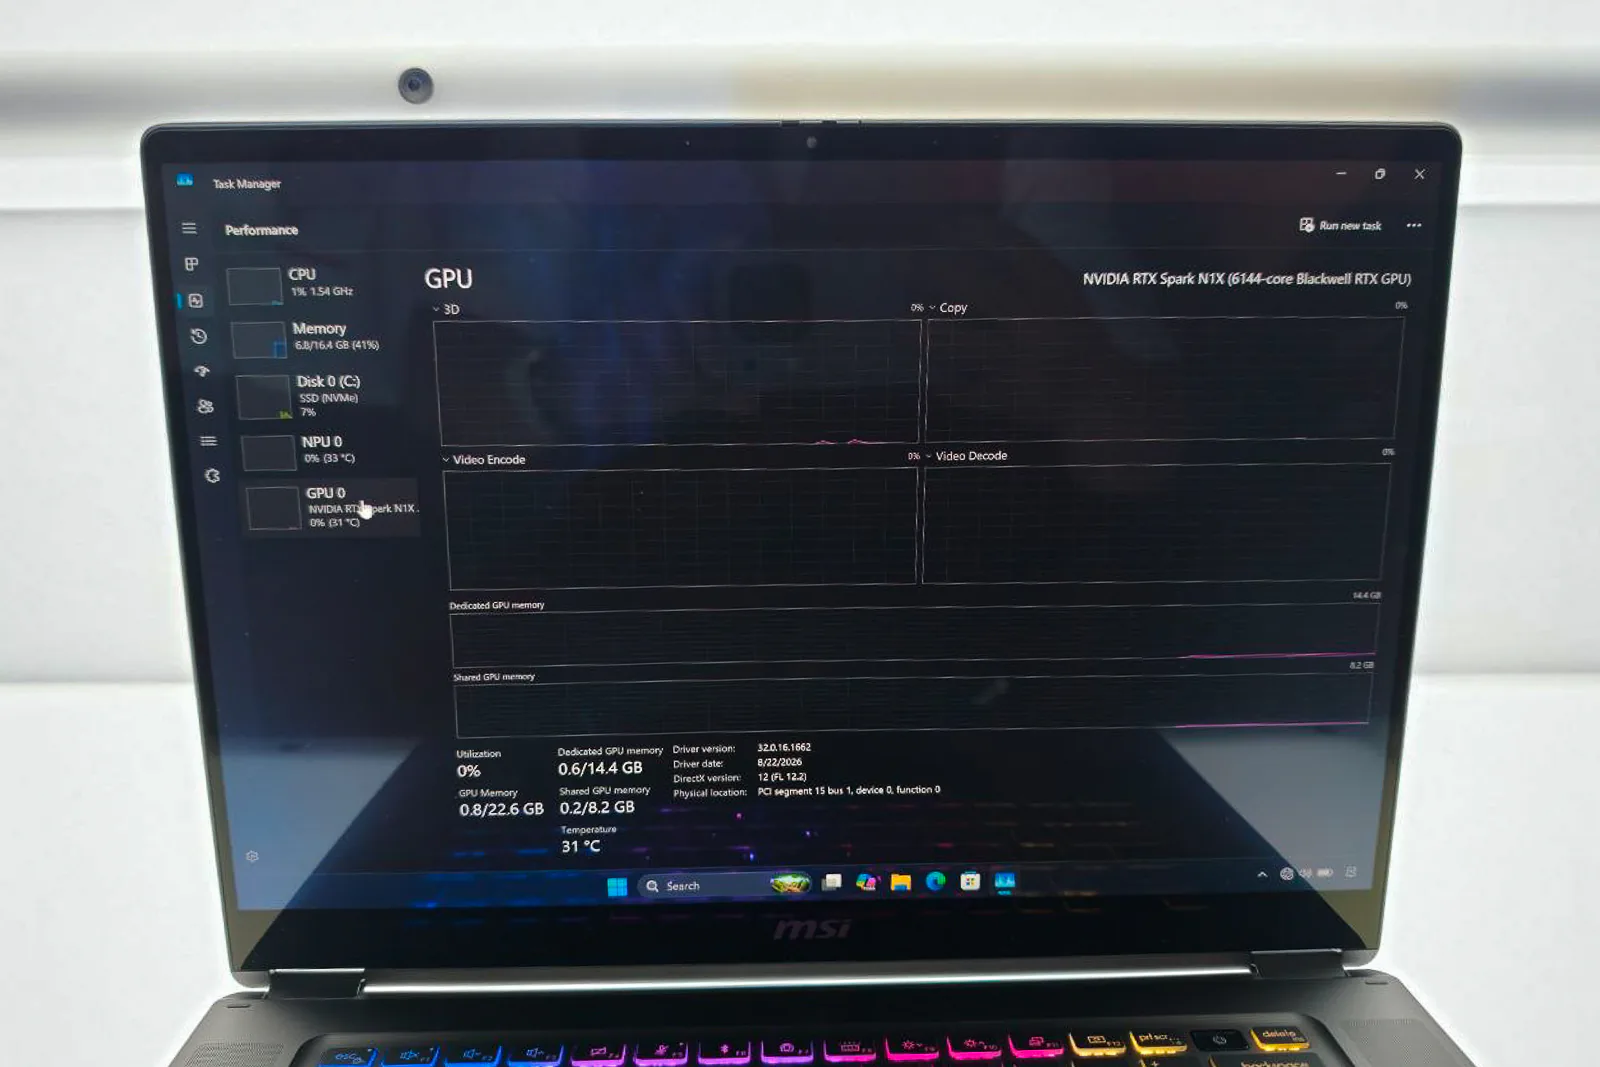
Một chi tiết thú vị là Task Manager hiển thị bộ nhớ GPU chuyên dụng khoảng 14,4 GB và bộ nhớ chia sẻ khoảng 8,2 GB trên hệ thống trưng bày. Đây là các giá trị Windows báo cáo ở cấu hình đang sử dụng, không nên nhầm với giới hạn bộ nhớ hợp nhất tối đa 128 GB của nền tảng.

Khả năng tận dụng bộ nhớ hợp nhất cho các tác vụ AI thực tế vẫn sẽ cần thêm những thử nghiệm cụ thể để đánh giá hiệu quả.

Với nền tảng Blackwell, Prestige N16 Flip AI+ có tiềm năng phục vụ nhiều nhóm công việc khác nhau, từ tăng tốc phần mềm sáng tạo, xử lý đồ họa đến những ứng dụng AI chạy cục bộ. Dẫu vậy, khả năng tương thích phần mềm và hiệu năng thực tế sẽ là những yếu tố cần kiểm chứng, thay vì chỉ dựa vào số lượng nhân CUDA.

Tản nhiệt buồng hơi và viên pin gần 100 Wh

Việc đưa một nền tảng xử lý hiệu năng cao vào thân máy xoay gập mỏng đặt ra không ít thách thức về khả năng tản nhiệt. MSI trang bị cho Prestige N16 Flip AI+ hệ thống Vapor Chamber Cooler với thiết kế luồng khí bên trong, hướng đến việc phân phối và giải phóng nhiệt hiệu quả hơn trong không gian giới hạn.

Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 23 Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 24

Một điểm đáng chú ý khác là dung lượng pin 99,9 Wh, gần sát ngưỡng 100 Wh thường được áp dụng cho pin lithium-ion mang lên máy bay theo quy định phổ biến của ngành hàng không. Đây là mức dung lượng lớn đối với laptop, nhưng thời lượng hoạt động thực tế sẽ còn phụ thuộc vào độ sáng màn hình OLED, chế độ hiệu năng và mức tải CPU/GPU. Ngoài ra, máy được trang bị hệ thống bốn loa hỗ trợ DTS Virtual, phục vụ nhu cầu giải trí và làm việc đa phương tiện.

Một hướng đi mới cho laptop AI cao cấp

Prestige N16 Flip AI+ cho thấy MSI đang thử nghiệm một cách kết hợp khá thú vị giữa thiết bị làm việc cao cấp và nền tảng AI thế hệ mới.

Thay vì đánh đổi tính di động để theo đuổi cấu hình workstation cồng kềnh, sản phẩm lựa chọn thiết kế 2-trong-1, màn hình Tandem OLED 4K và khả năng mở rộng trải nghiệm với bút cảm ứng. Đáng chú ý hơn cả là sự hiện diện của NVIDIA RTX Spark N1X cùng kiến trúc Blackwell và bộ nhớ hợp nhất dung lượng lớn. Những trang bị này mở ra tiềm năng cho các tác vụ sáng tạo nội dung và AI ngay trên laptop, dù hiệu quả cuối cùng vẫn cần được chứng minh qua những bài kiểm tra độc lập.

Với những gì thể hiện qua loạt hình ảnh trên tay, MSI Prestige N16 Flip AI+ là một trong những thiết bị đáng quan tâm đối với người dùng muốn tìm kiếm chiếc laptop cao cấp có thiết kế linh hoạt, màn hình chất lượng cao và định hướng rõ rệt vào công việc AI. Thông tin về giá bán, thời điểm lên kệ cũng như các tùy chọn cấu hình thương mại vẫn cần được xác nhận thêm từ MSI.

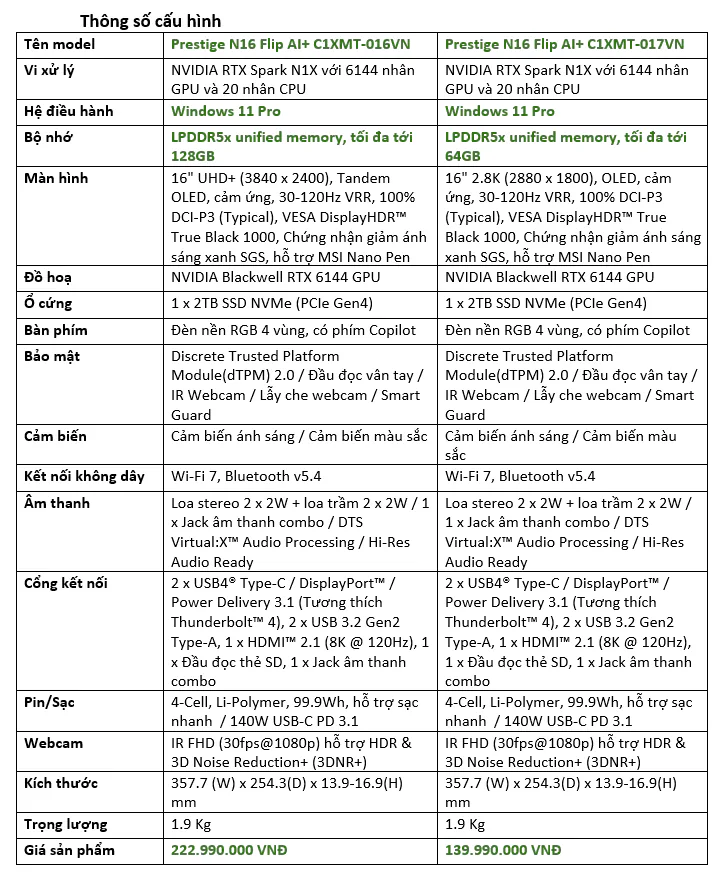
MSI Prestige N16 Flip AI+ chính thức mở cổng đặt hàng trước từ ngày 08/10/2026 tại hệ thống đại lý ủy quyền của MSI trên toàn quốc, với giá bán lẻ đề xuất:

  • Phiên bản 64GB RAM: 139.990.000 VNĐ
  • Phiên bản 128GB RAM: 222.990.000 VNĐ

Trên tay MSI Prestige N16 Flip AI+: Laptop xoay gập mang sức mạnh RTX Spark 25

Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm

0

NVIDIA RTX Spark N1X mang đến khả năng chạy mô hình AI hàng chục tỉ tham số ngay trên laptop. Những thử nghiệm thực tế cho thấy tiềm năng của nền tảng này trong xử lý AI, lập trình và đồ họa, đồng thời đặt ra những yêu cầu mới về khả năng tản nhiệt.

Trong vài năm trở lại đây, trí tuệ nhân tạo (AI) gần như trở thành một tính năng không thể thiếu trong các buổi giới thiệu laptop. Từ xử lý hình ảnh, cải thiện âm thanh cho đến trợ lý thông minh, các nhà sản xuất đều tìm cách đưa AI đến gần hơn với người dùng.

Tuy nhiên, phần lớn những dịch vụ AI quen thuộc vẫn hoạt động dựa trên điện toán đám mây. Người dùng gửi yêu cầu đến máy chủ, chờ hệ thống xử lý rồi nhận kết quả. Cách làm này đơn giản và thuận tiện, nhưng cũng đồng nghĩa với việc người dùng phụ thuộc vào kết nối internet, chính sách dịch vụ và hạ tầng của nhà cung cấp.
Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 26

AI cục bộ (local AI) lại đi theo hướng khác. Thay vì gửi dữ liệu đến máy chủ bên ngoài, toàn bộ quá trình xử lý có thể được thực hiện trực tiếp trên thiết bị. Người dùng chủ động lựa chọn mô hình, cấu hình phần mềm và xây dựng những quy trình làm việc phù hợp với nhu cầu riêng.

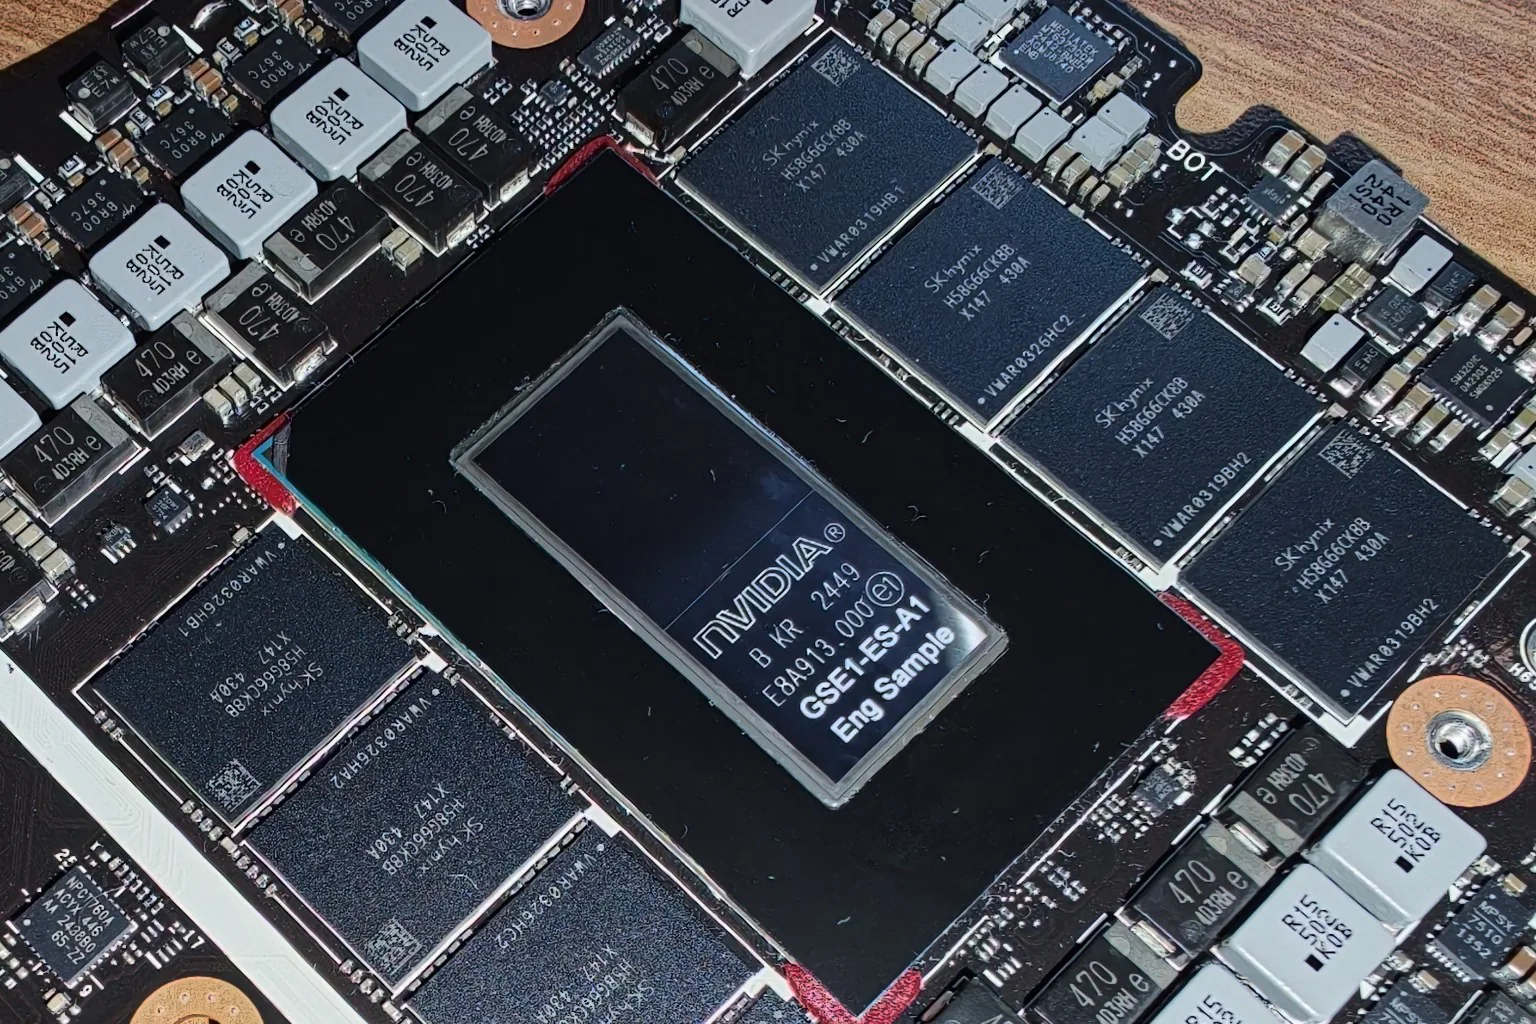
Đổi lại, yêu cầu phần cứng cũng cao hơn đáng kể. Những mô hình ngôn ngữ có hàng chục tỉ tham số thường cần dung lượng bộ nhớ lớn, trong khi GPU trên laptop lại bị giới hạn bởi lượng VRAM được trang bị. Đây chính là lý do tôi đặc biệt quan tâm đến NVIDIA RTX Spark N1X, nền tảng kết hợp CPU, GPU Blackwell và bộ nhớ hợp nhất nhằm phục vụ những tác vụ AI ngay trên laptop.

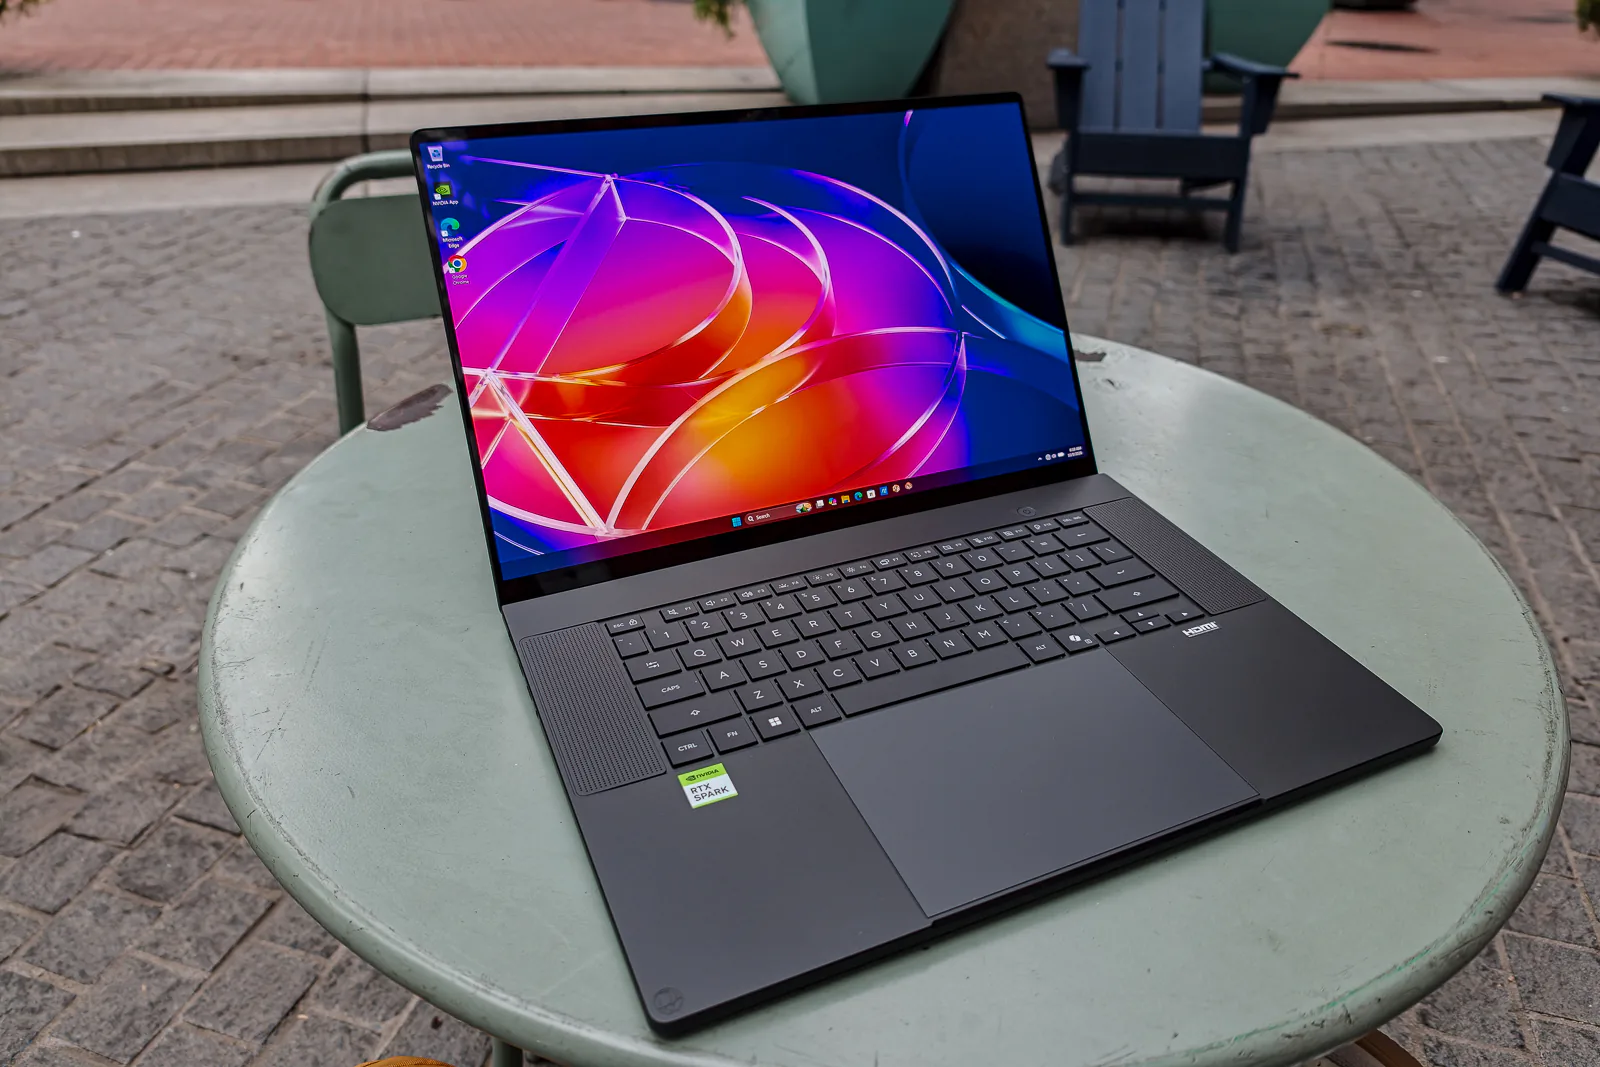
Trong lần trải nghiệm này, tôi sử dụng một chiếc ASUS ProArt 16 trang bị RTX Spark N1X để thử nghiệm khả năng chạy mô hình ngôn ngữ lớn, tạo hình ảnh bằng AI và đặc biệt là để AI tự xây dựng một phần mềm Windows. Sau đó, tôi tiếp tục kiểm tra hiệu năng đồ họa bằng 3DMark và Cyberpunk 2077.

Thành phần Thông số
Thiết bị thử nghiệm ASUS ProArt P16
Nền tảng NVIDIA RTX Spark N1X
CPU 20 nhân ARM, gồm 10 nhân Cortex-X925 và 10 nhân Cortex-A725
GPU NVIDIA Blackwell
Nhân CUDA 6.144
RAM 64 GB LPDDR5X
Kiến trúc bộ nhớ Bộ nhớ hợp nhất, dùng chung cho CPU và GPU
Băng thông bộ nhớ Tối đa 300 GB/giây
Dung lượng RAM nền tảng hỗ trợ Tối đa 128 GB
Bộ nhớ phân bổ cho GPU 48 GB, cấu hình qua NVIDIA App
Hệ điều hành Windows 11 ARM64
Trình điều khiển GPU NVIDIA 617.42

RTX Spark N1X và lợi thế từ bộ nhớ hợp nhất

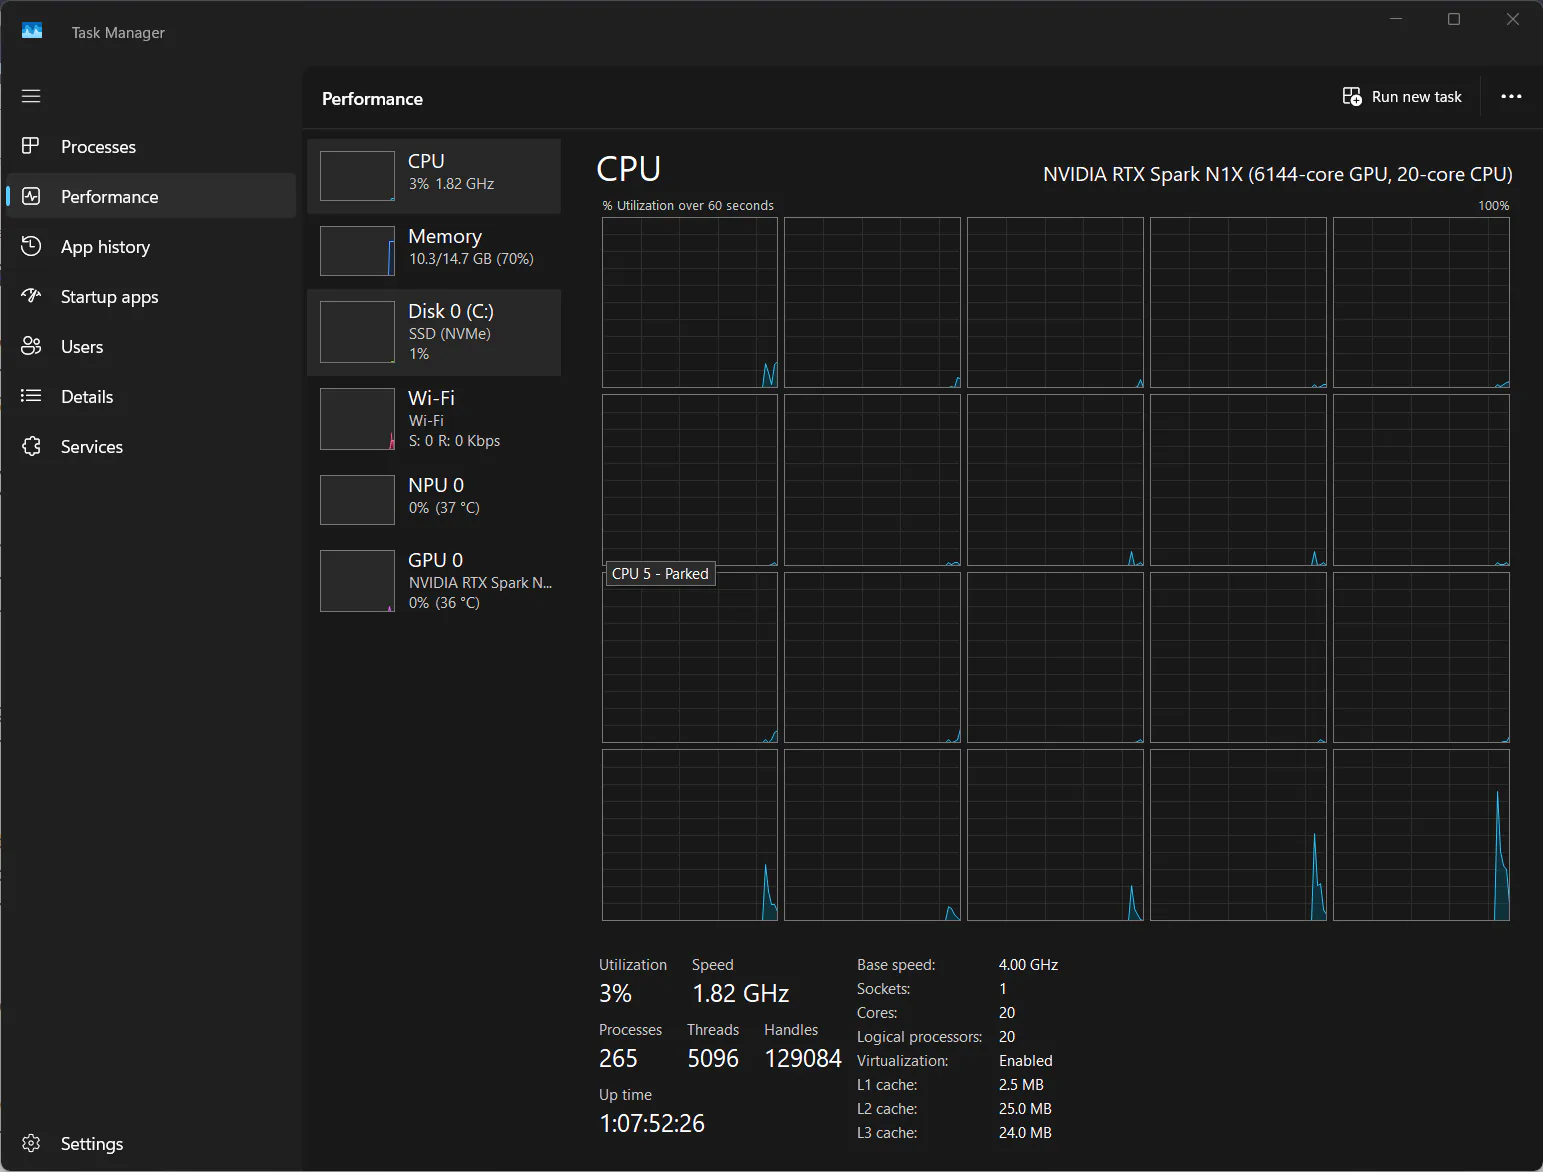
NVIDIA RTX Spark N1X sử dụng bộ xử lý 20 nhân, gồm 10 nhân Cortex-X925 và 10 nhân Cortex-A725. Đi kèm là GPU dựa trên kiến trúc NVIDIA Blackwell với 6.144 nhân CUDA. Nếu chỉ nhìn vào số nhân xử lý, đây đã là một cấu hình đáng chú ý. Tuy nhiên, điều khiến RTX Spark khác biệt so với nhiều laptop thông thường lại nằm ở cách tổ chức bộ nhớ.

Trên những hệ thống sử dụng card đồ họa rời, CPU và GPU thường có hai vùng bộ nhớ riêng biệt. CPU sử dụng RAM hệ thống, còn GPU có VRAM với dung lượng cố định. Cách tổ chức này phù hợp với nhiều tác vụ đồ họa truyền thống, nhưng có thể trở thành trở ngại khi chạy những mô hình AI lớn.
Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 27

Chẳng hạn, một mô hình ngôn ngữ có thể cần hàng chục GB bộ nhớ để lưu trữ dữ liệu trong quá trình suy luận. Nếu VRAM không đủ, người dùng phải giảm kích thước mô hình, sử dụng phương pháp lượng tử hóa hoặc chuyển một phần dữ liệu sang RAM hệ thống, vốn có thể làm giảm tốc độ xử lý.

RTX Spark sử dụng bộ nhớ LPDDR5X dùng chung cho CPU và GPU, với băng thông tối đa 300 GB/giây. Nền tảng hỗ trợ dung lượng lên đến 128 GB, trong khi chiếc ASUS ProArt tôi thử nghiệm được trang bị 64 GB RAM. Nhờ sử dụng chung bộ nhớ, hệ thống có thể phân bổ một lượng lớn dung lượng cho những tác vụ cần GPU. Trong NVIDIA App, thiết bị thử nghiệm cho phép thiết lập mức phân bổ khoảng 48 GB dành cho GPU.
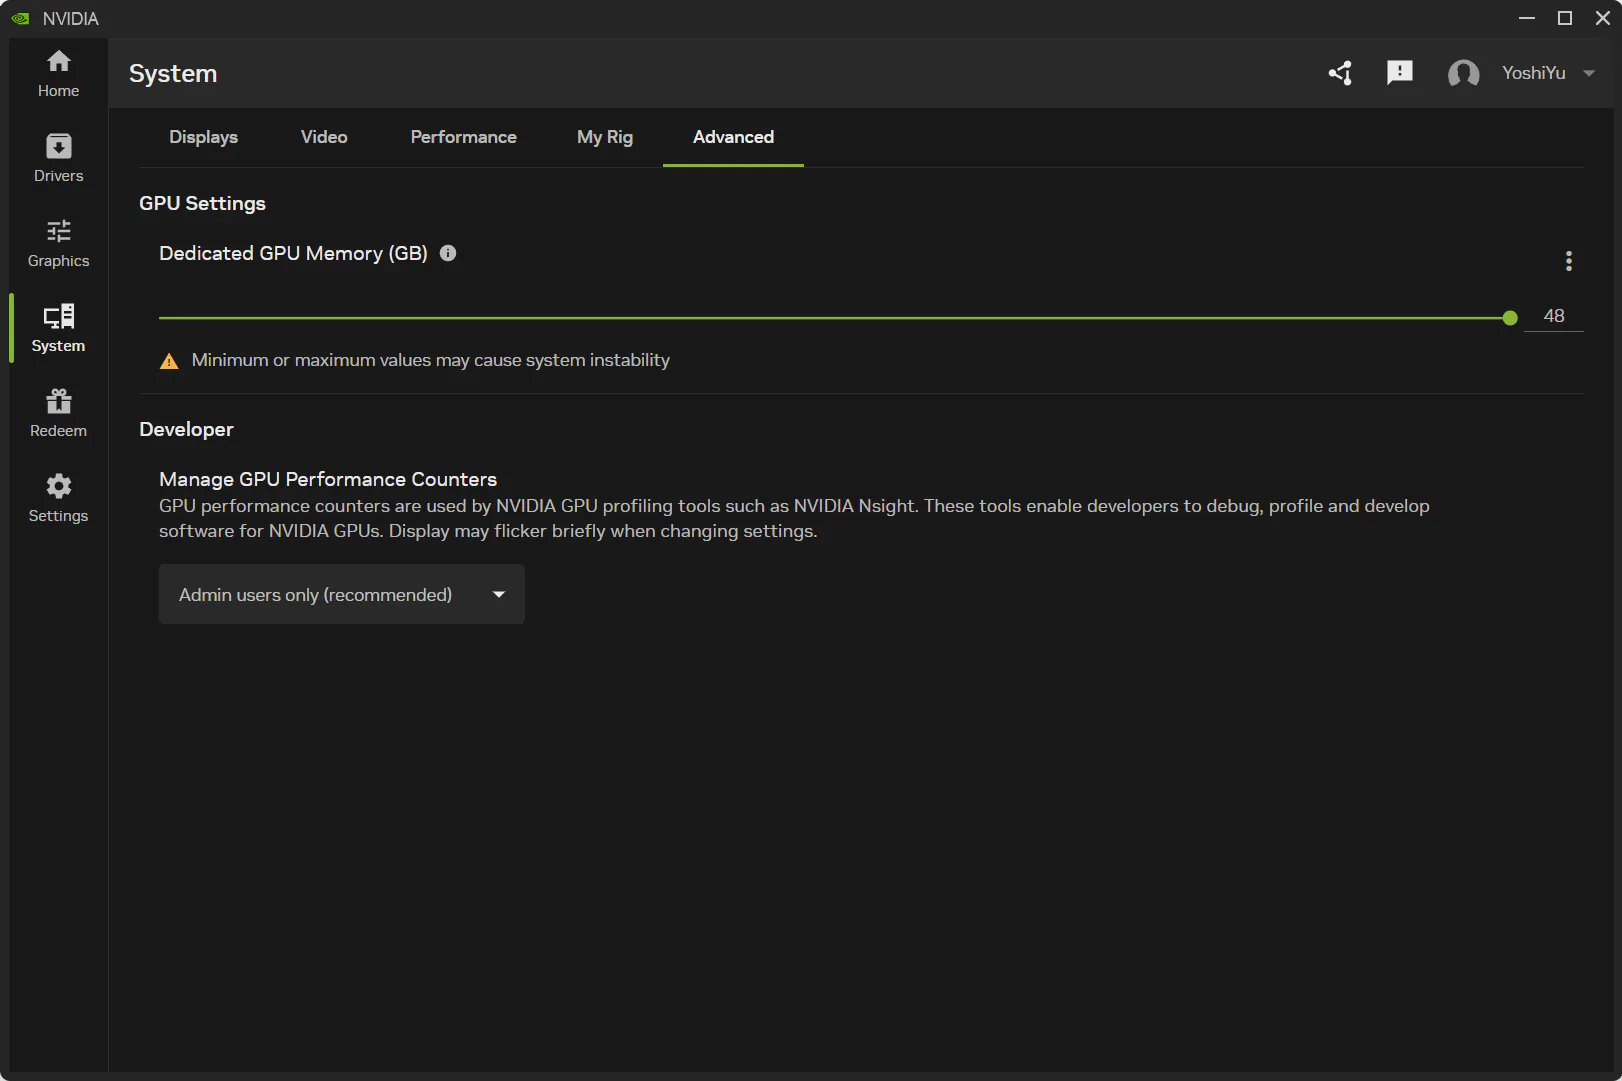
Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 28

Dù không thể xem vùng bộ nhớ này tương đương hoàn toàn với VRAM trên card đồ họa rời, đây vẫn là lợi thế đáng kể khi vận hành những mô hình AI có dung lượng lớn. Điều đó cũng khiến cách đánh giá RTX Spark trở nên khác biệt. Thay vì chỉ quan tâm CPU mạnh đến đâu hoặc GPU chơi game được bao nhiêu FPS, người dùng có thêm một yếu tố cần cân nhắc: hệ thống có đủ bộ nhớ để vận hành mô hình AI mình cần hay không?

Một đặc điểm khác là RTX Spark N1X sử dụng Windows 11 ARM64. Đây là môi trường có những khác biệt so với Windows trên nền tảng x86 truyền thống, đặc biệt khi làm việc với phần mềm chuyên dụng và các thư viện AI. Trong quá trình thử nghiệm, tôi nhận thấy việc lựa chọn đúng phiên bản phần mềm và phương thức tăng tốc GPU có ảnh hưởng đáng kể đến trải nghiệm. Với AI cục bộ, sở hữu phần cứng mạnh mới chỉ là một phần của câu chuyện.

Thử sức với mô hình AI 27 tỉ tham số

Để đánh giá khả năng xử lý mô hình ngôn ngữ lớn, tôi sử dụng Qwen3.8 27B, một mô hình AI có 27 tỉ tham số. Mô hình được lượng tử hóa theo định dạng Q4_K_M nhằm giảm dung lượng bộ nhớ cần thiết. Đây là phương pháp thường được sử dụng khi triển khai AI cục bộ, giúp những mô hình lớn có thể vận hành trên phần cứng phổ thông hơn.

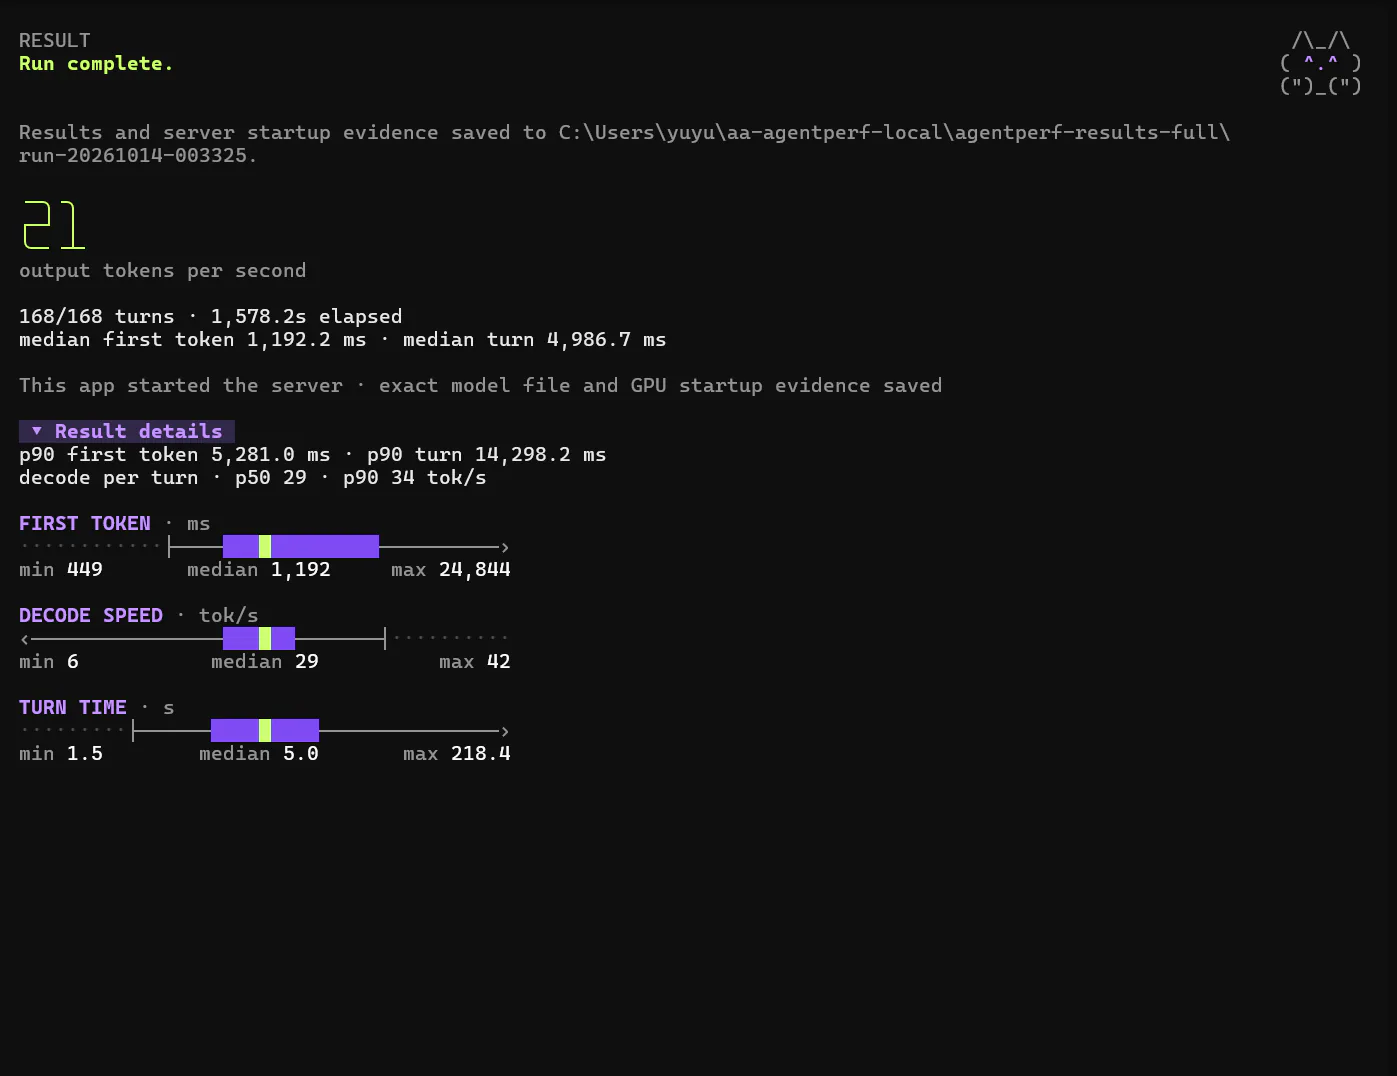
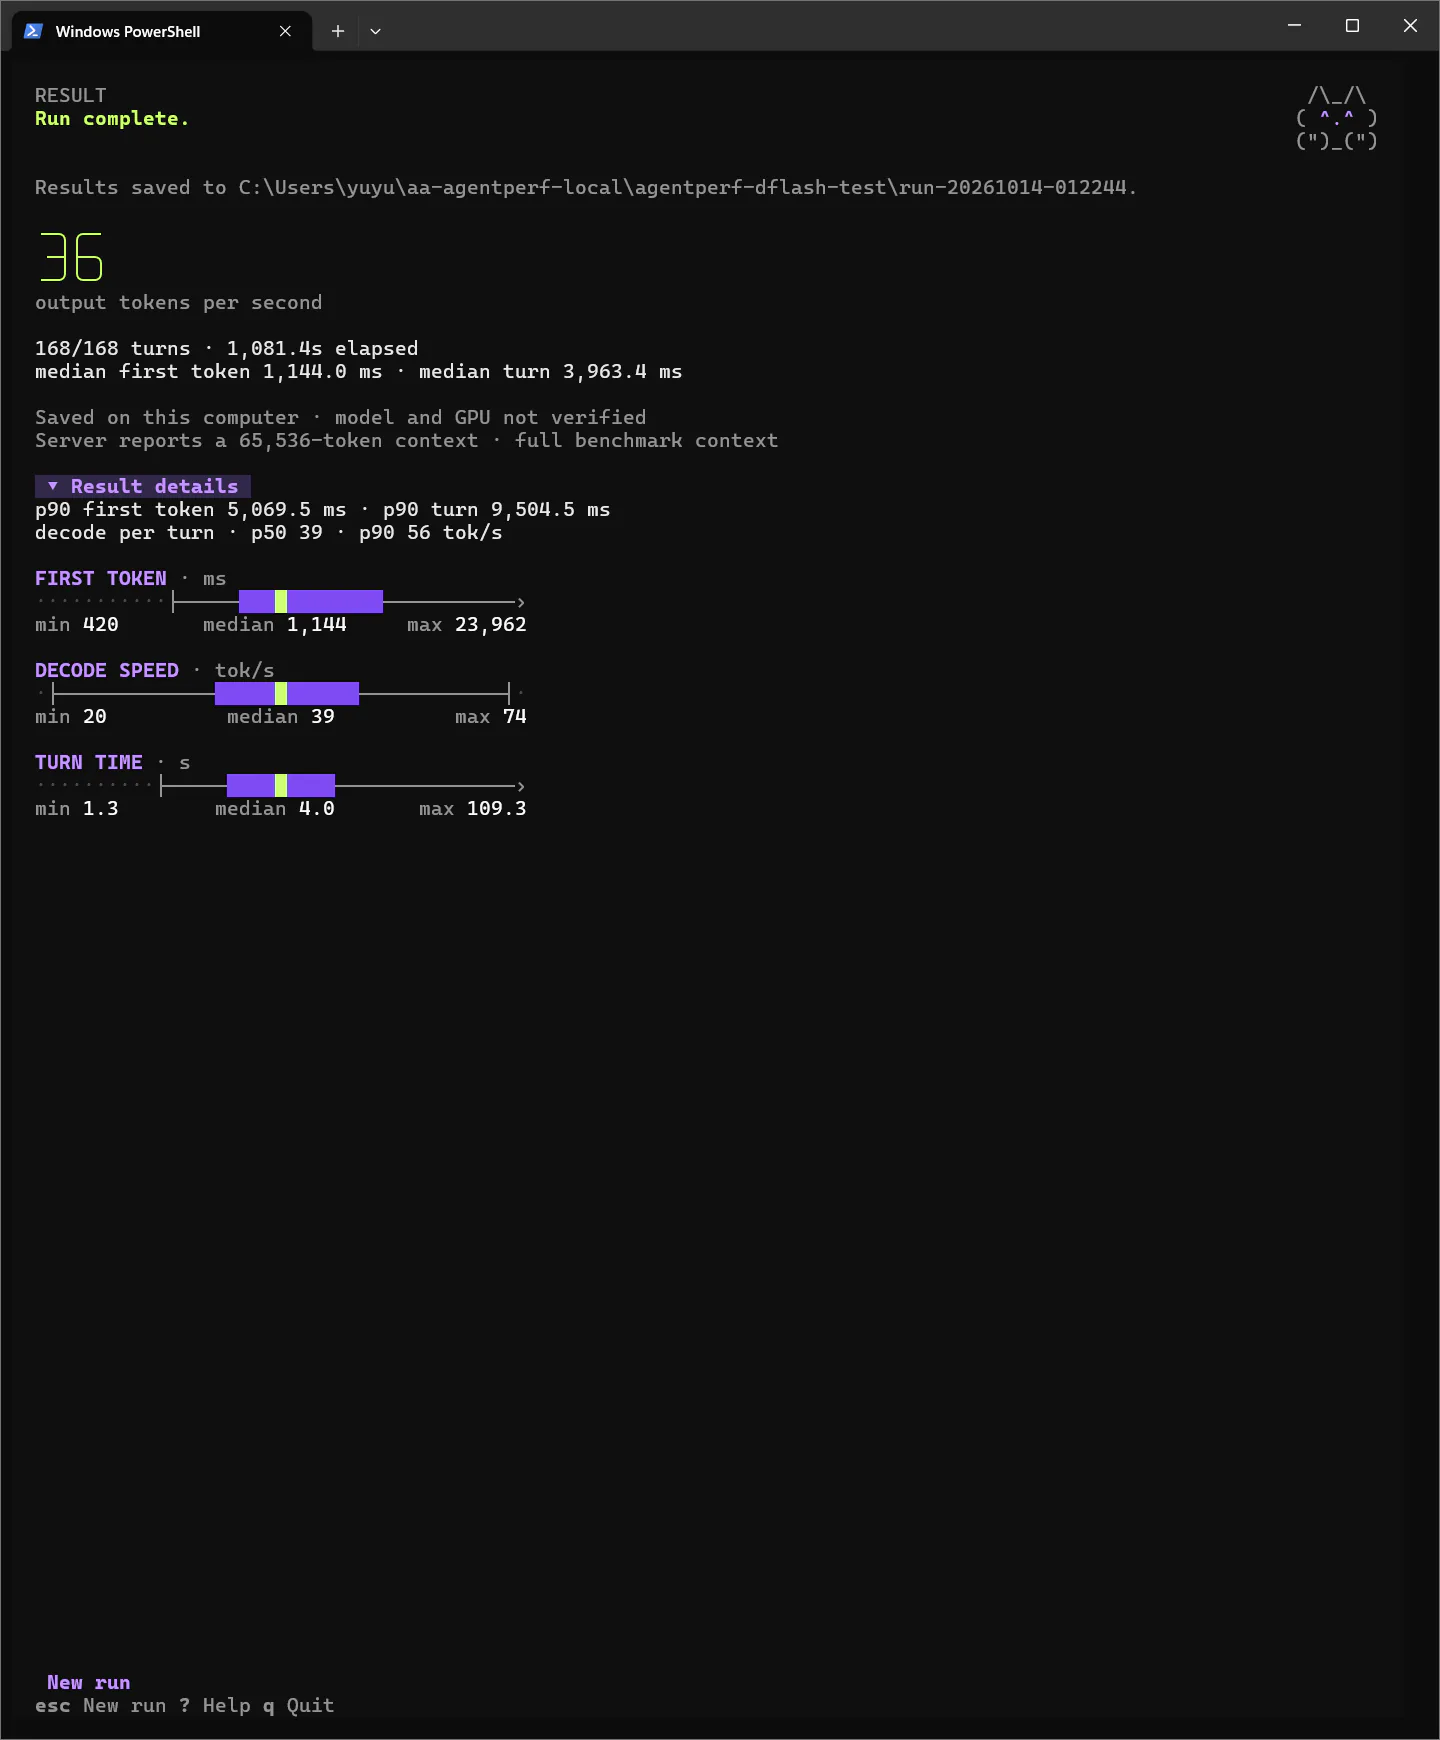
Thay vì chỉ đặt vài câu hỏi và quan sát tốc độ trả lời, tôi sử dụng AgentPerf Local để đánh giá khả năng xử lý của hệ thống trong một chuỗi công việc dài. Bài thử bao gồm 8 tác vụ với tổng cộng 168 lượt xử lý, sử dụng cửa sổ ngữ cảnh 65.536 token. Khối lượng này phù hợp hơn với cách một AI agent hoạt động, khi mô hình phải liên tục tiếp nhận thông tin và thực hiện nhiều bước để hoàn thành nhiệm vụ.
Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 29

Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 30

Ở cấu hình MTP, hệ thống đạt tốc độ sinh nội dung 20,69 token/giây. Tổng thời gian hoàn thành bài thử là 1.576,23 giây, tương đương khoảng 26 phút. Tôi tiếp tục thực hiện phép đo với llama.cpp CUDA sử dụng DFlash. Kết quả cải thiện rõ rệt khi tốc độ sinh nội dung tăng lên 36,22 token/giây, trong khi tổng thời gian giảm xuống còn 1.079,39 giây, tức khoảng 18 phút.

AgentPerf Local MTP DFlash
Tổng số lượt xử lý 168 168
Tốc độ sinh nội dung 20,69 token/giây 36,22 token/giây
Tổng thời gian 1.576,23 giây 1.079,39 giây

Như vậy, chỉ bằng việc thay đổi phương thức xử lý, tổng thời gian thực hiện bài thử đã giảm khoảng 31,5%.

Đây là một kết quả khiến tôi khá bất ngờ. Nó cho thấy hiệu năng AI không đơn giản phụ thuộc vào thông số phần cứng, mà còn chịu ảnh hưởng lớn từ phần mềm và cách mô hình được triển khai. Cần lưu ý rằng bài thử sử dụng cơ chế phát lại thao tác công cụ nhằm đo hiệu năng, không phải phép kiểm tra độc lập về chất lượng câu trả lời của AI. Dù vậy, việc một chiếc laptop có thể vận hành mô hình 27 tỉ tham số trong một bài thử kéo dài hàng trăm lượt xử lý cho thấy lợi ích rõ ràng của bộ nhớ hợp nhất dung lượng lớn.

Tạo hình ảnh bằng AI ngay trên laptop

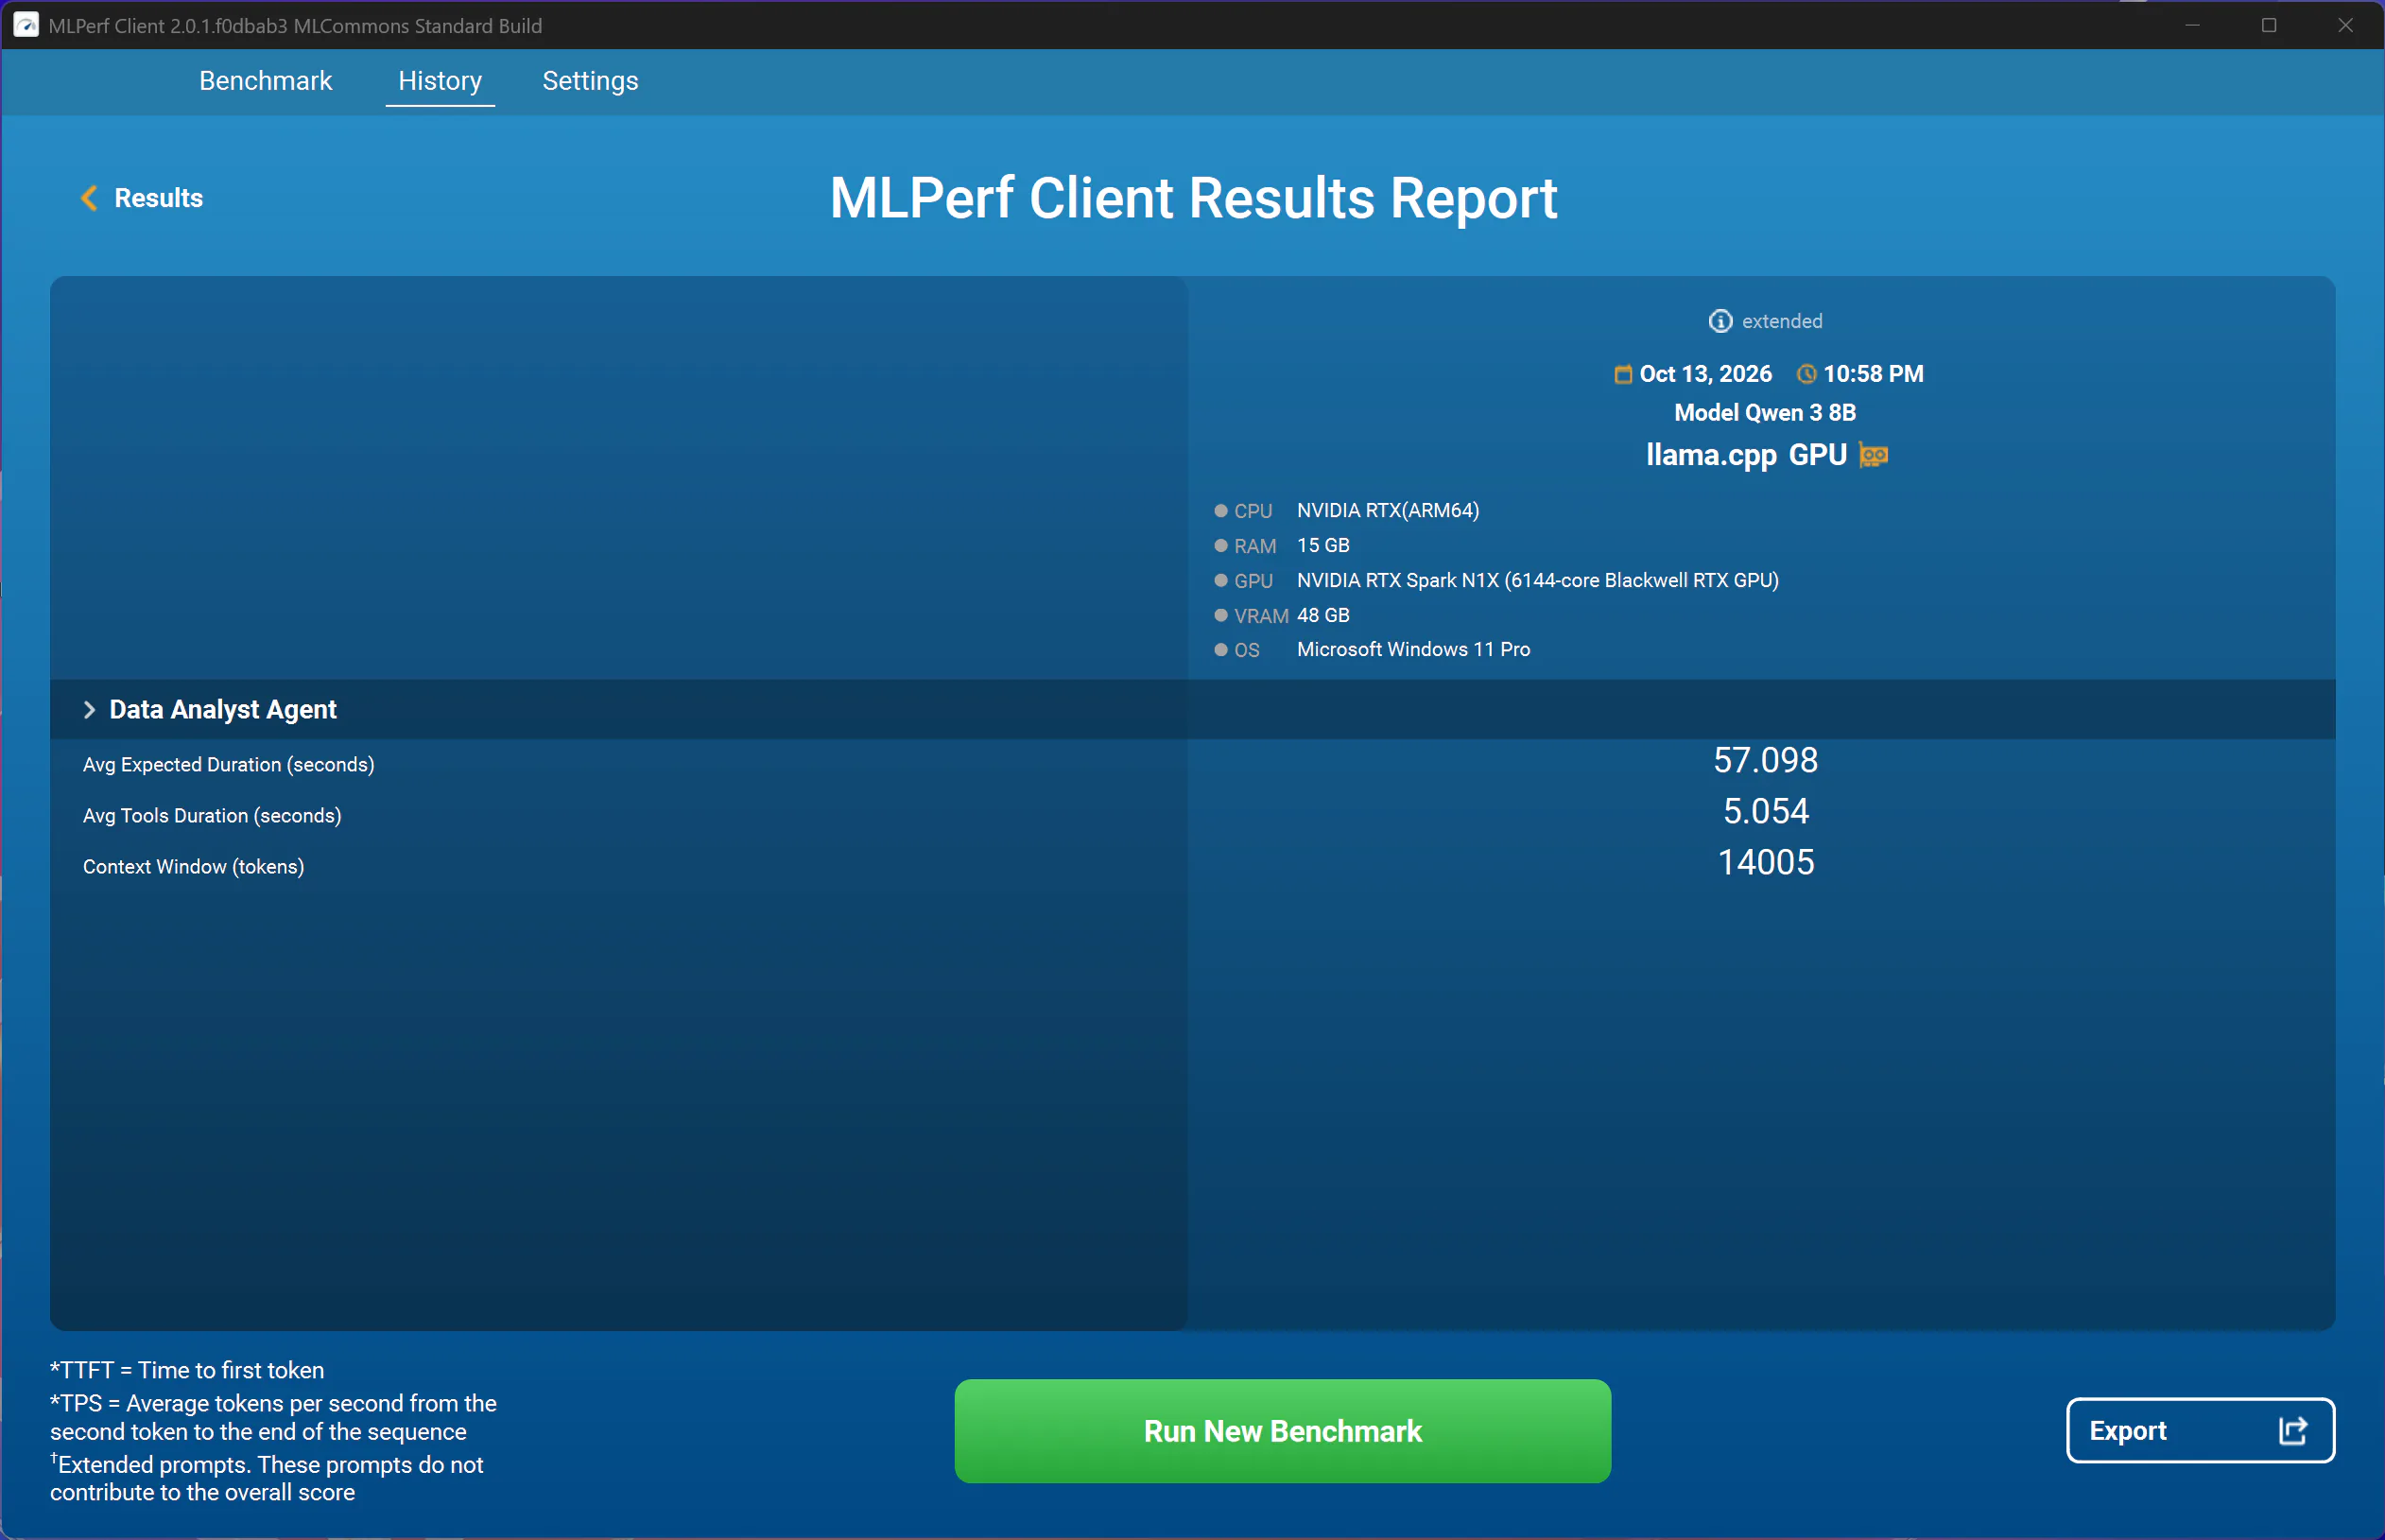
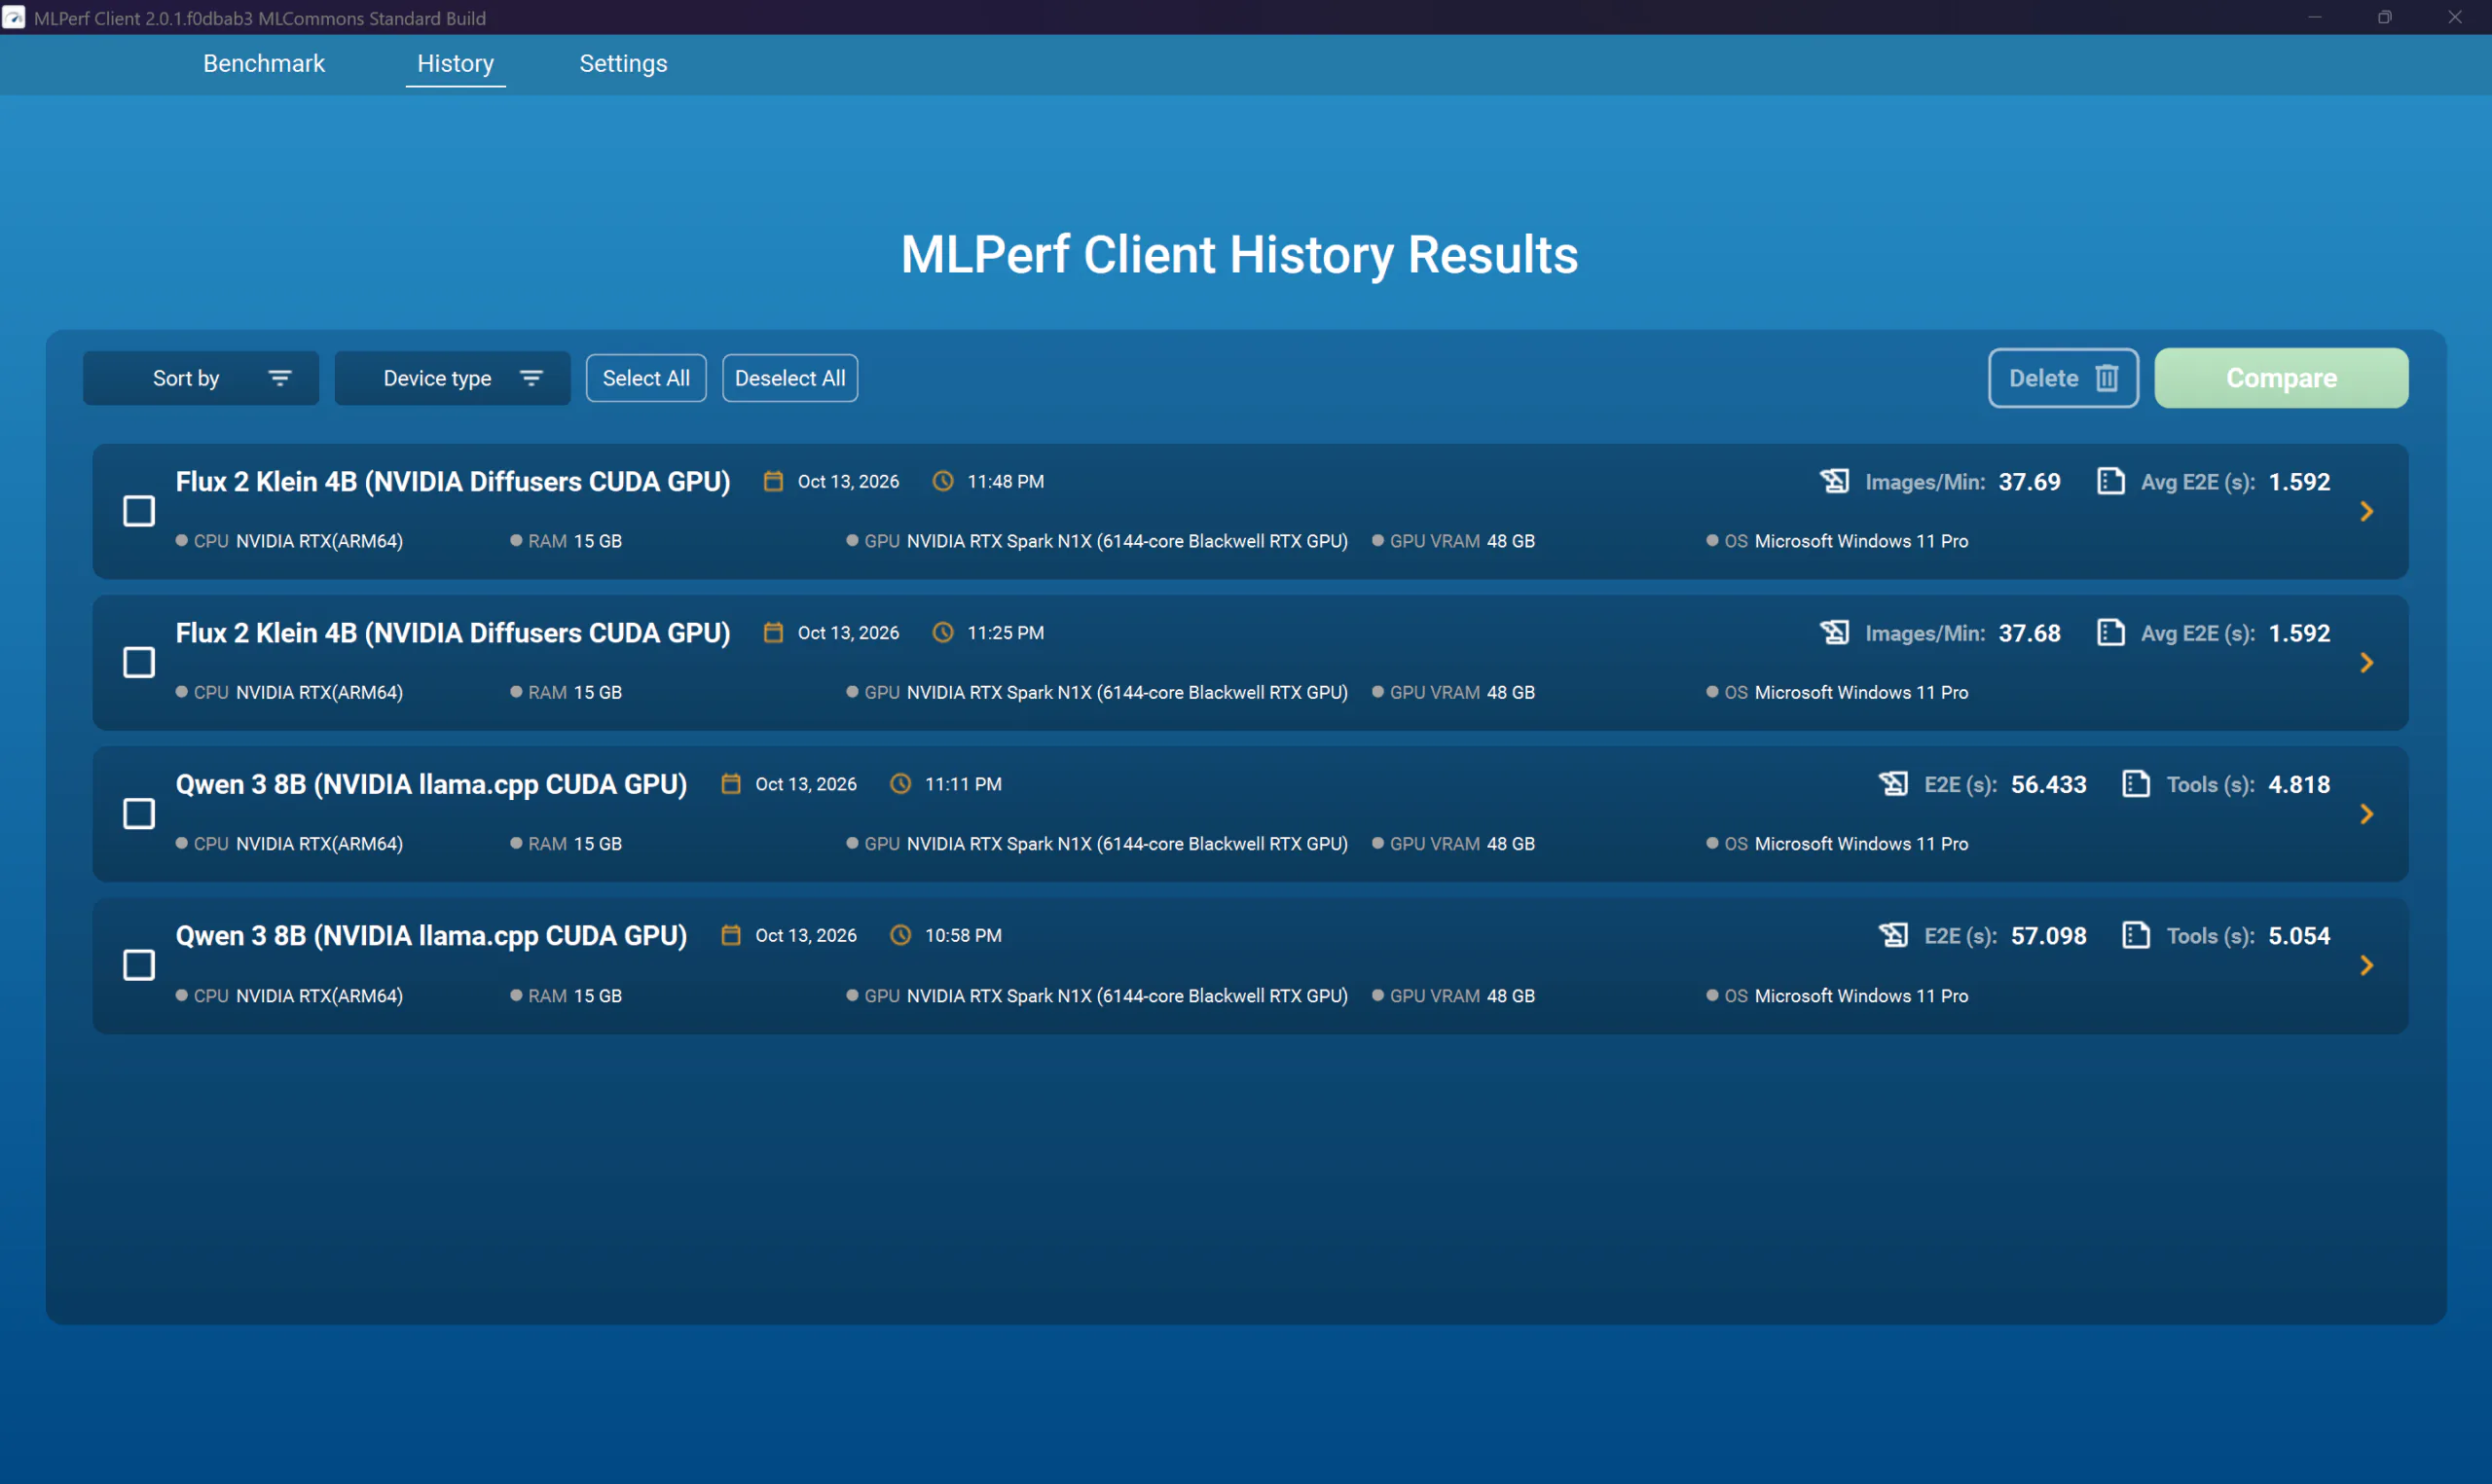
Sau mô hình ngôn ngữ, tôi chuyển sang những tác vụ tạo nội dung bằng AI. Đầu tiên là MLPerf Client 2.0.1, bộ công cụ đánh giá hiệu năng AI với các bài thử được thiết kế theo những nhóm công việc cụ thể.

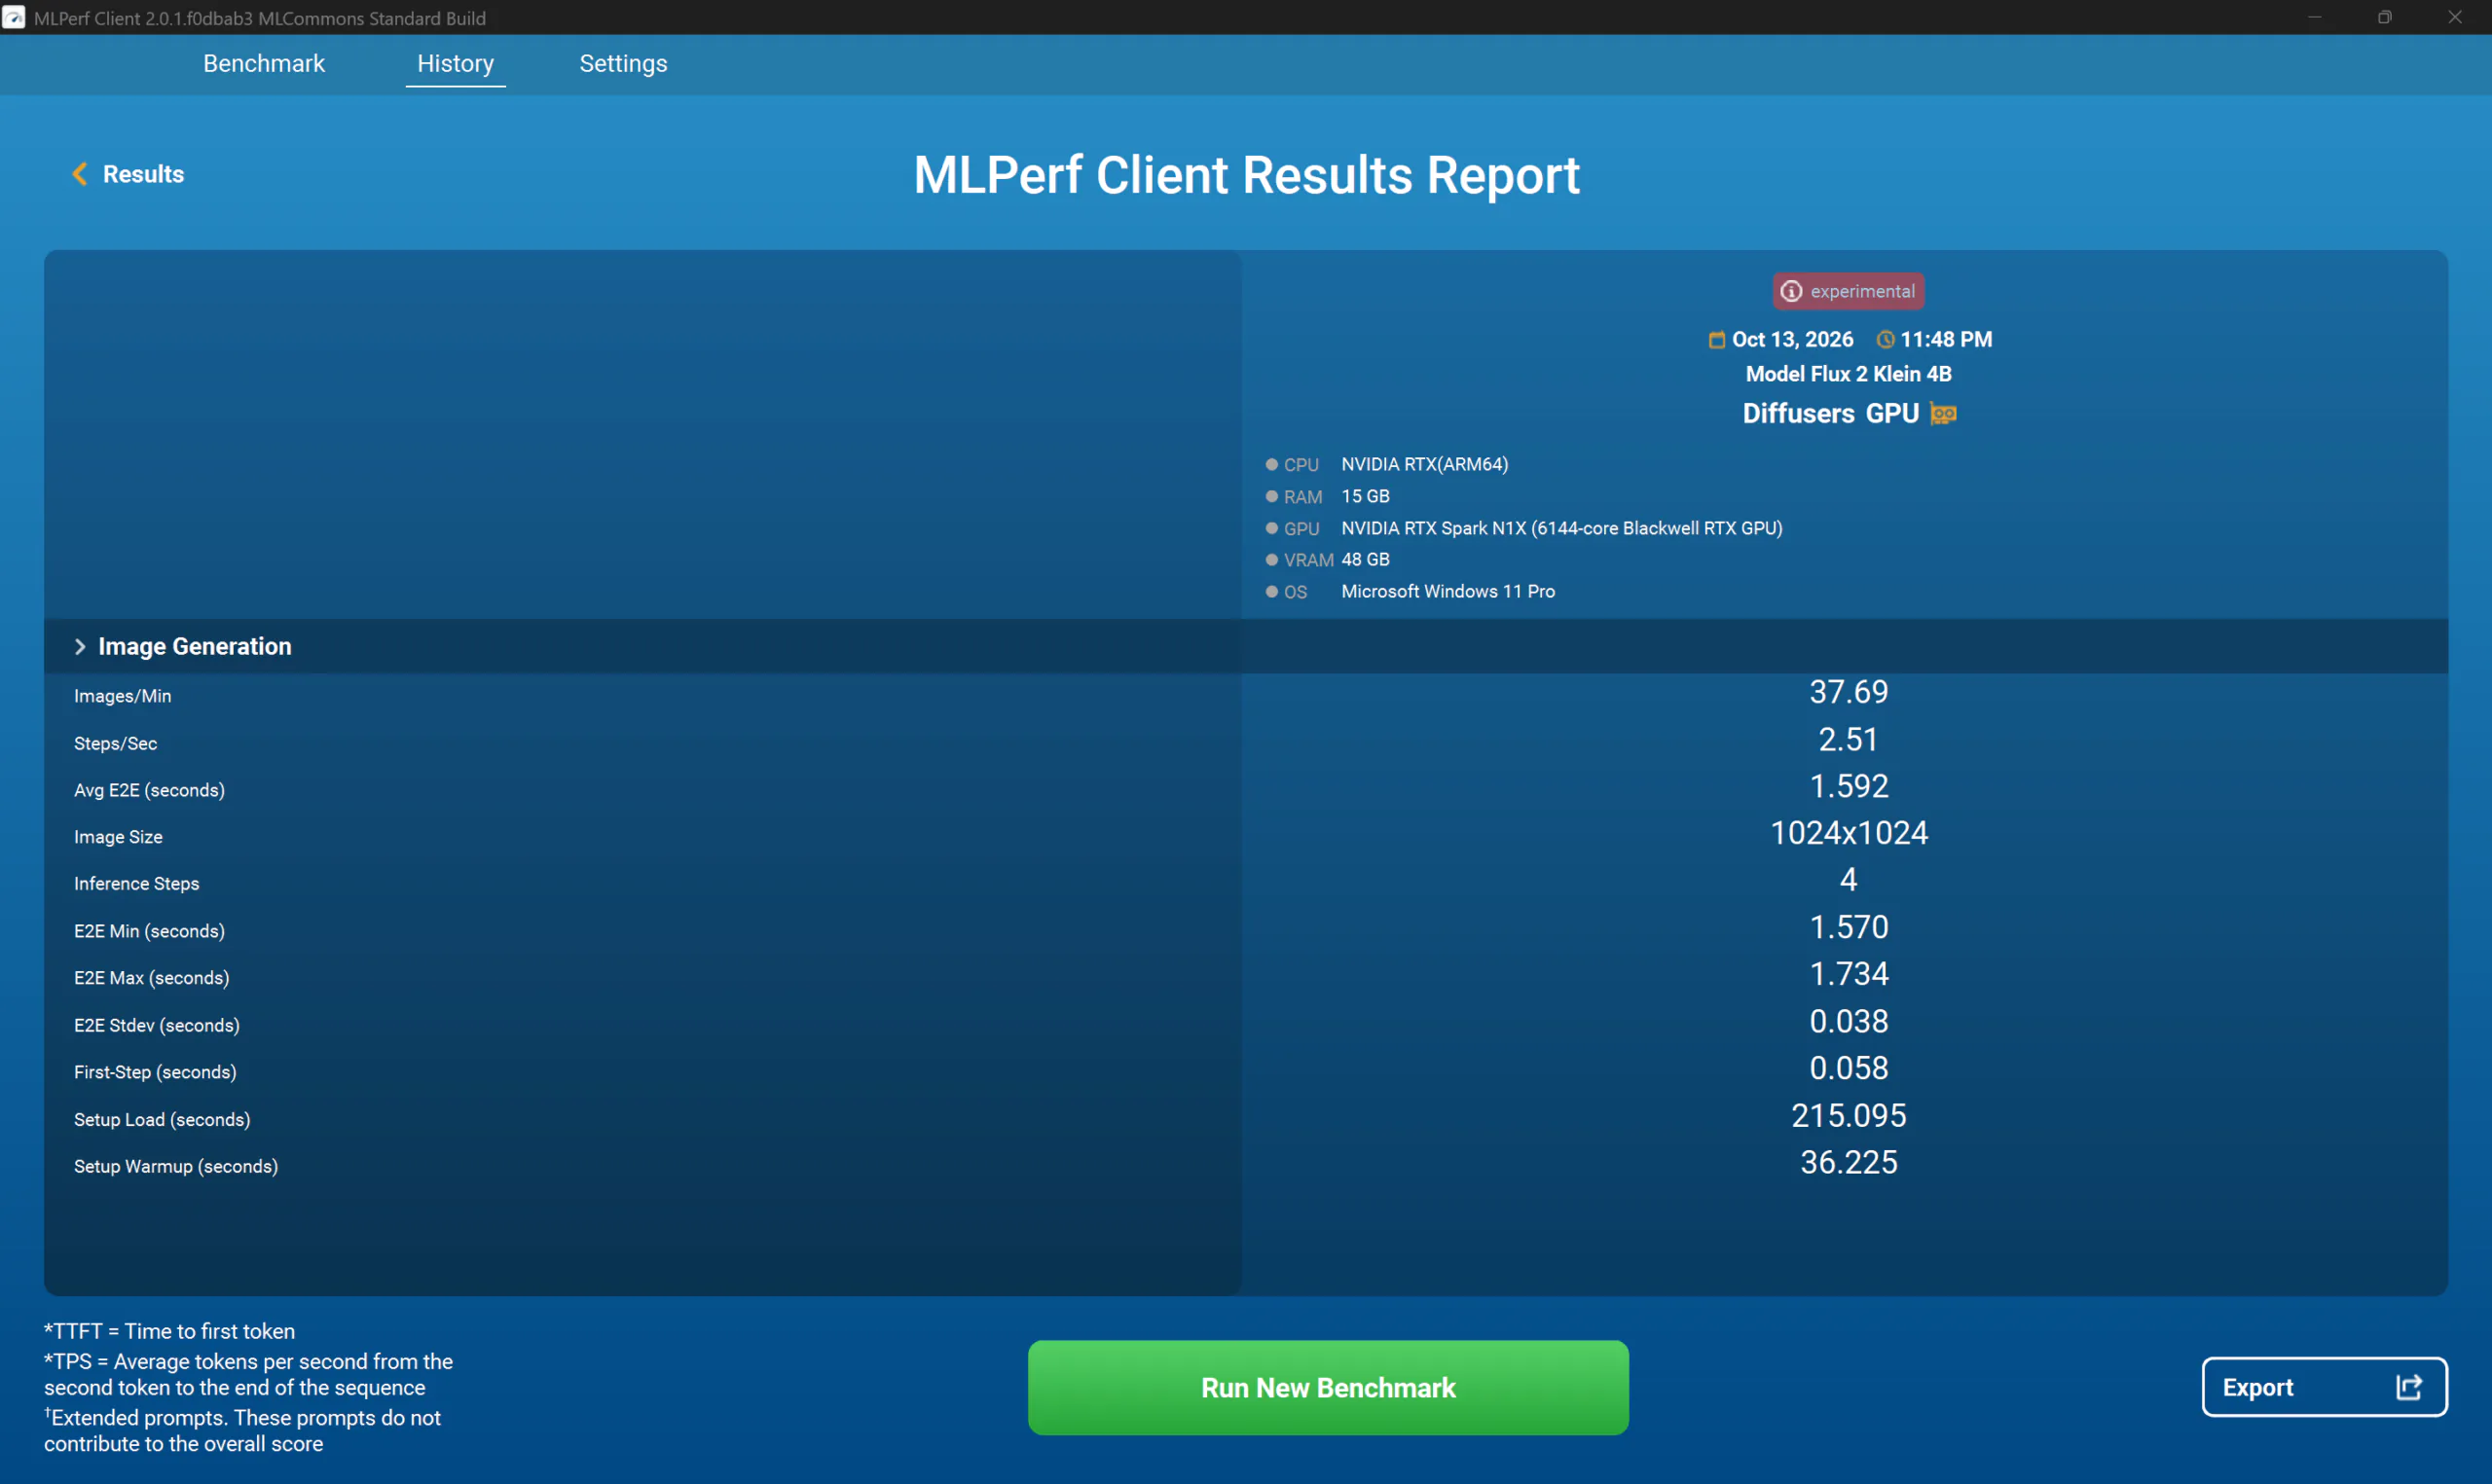
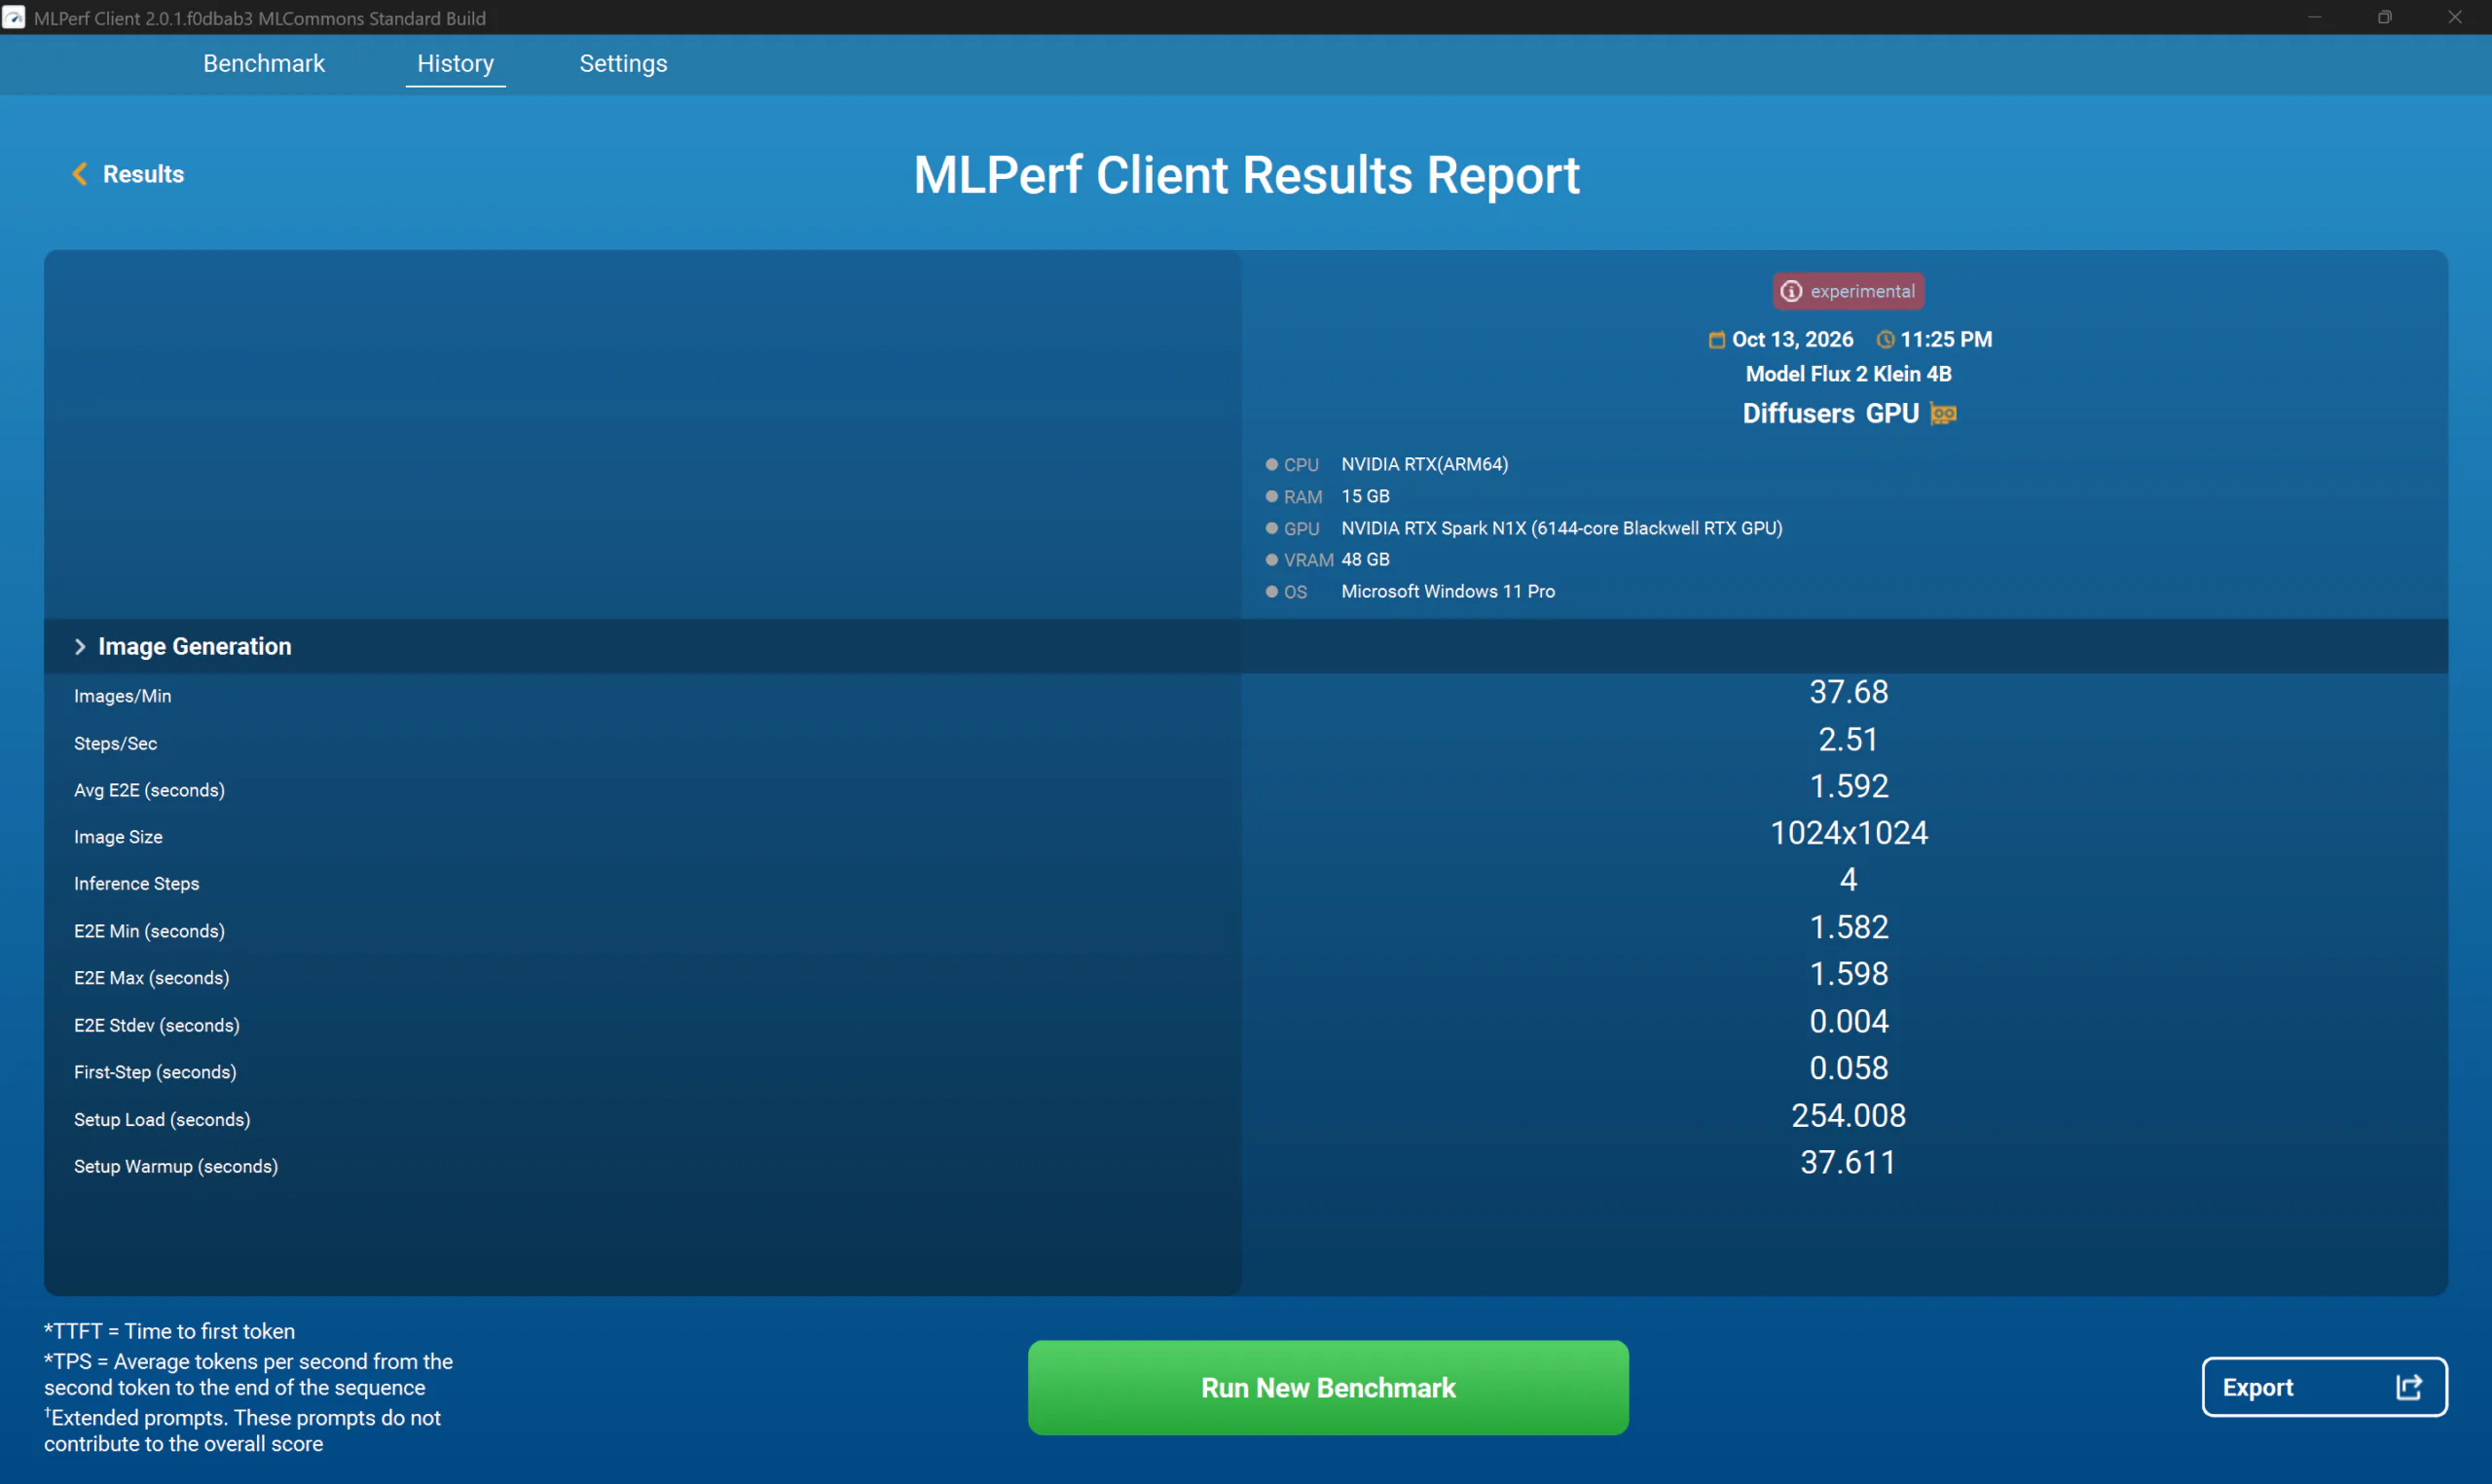
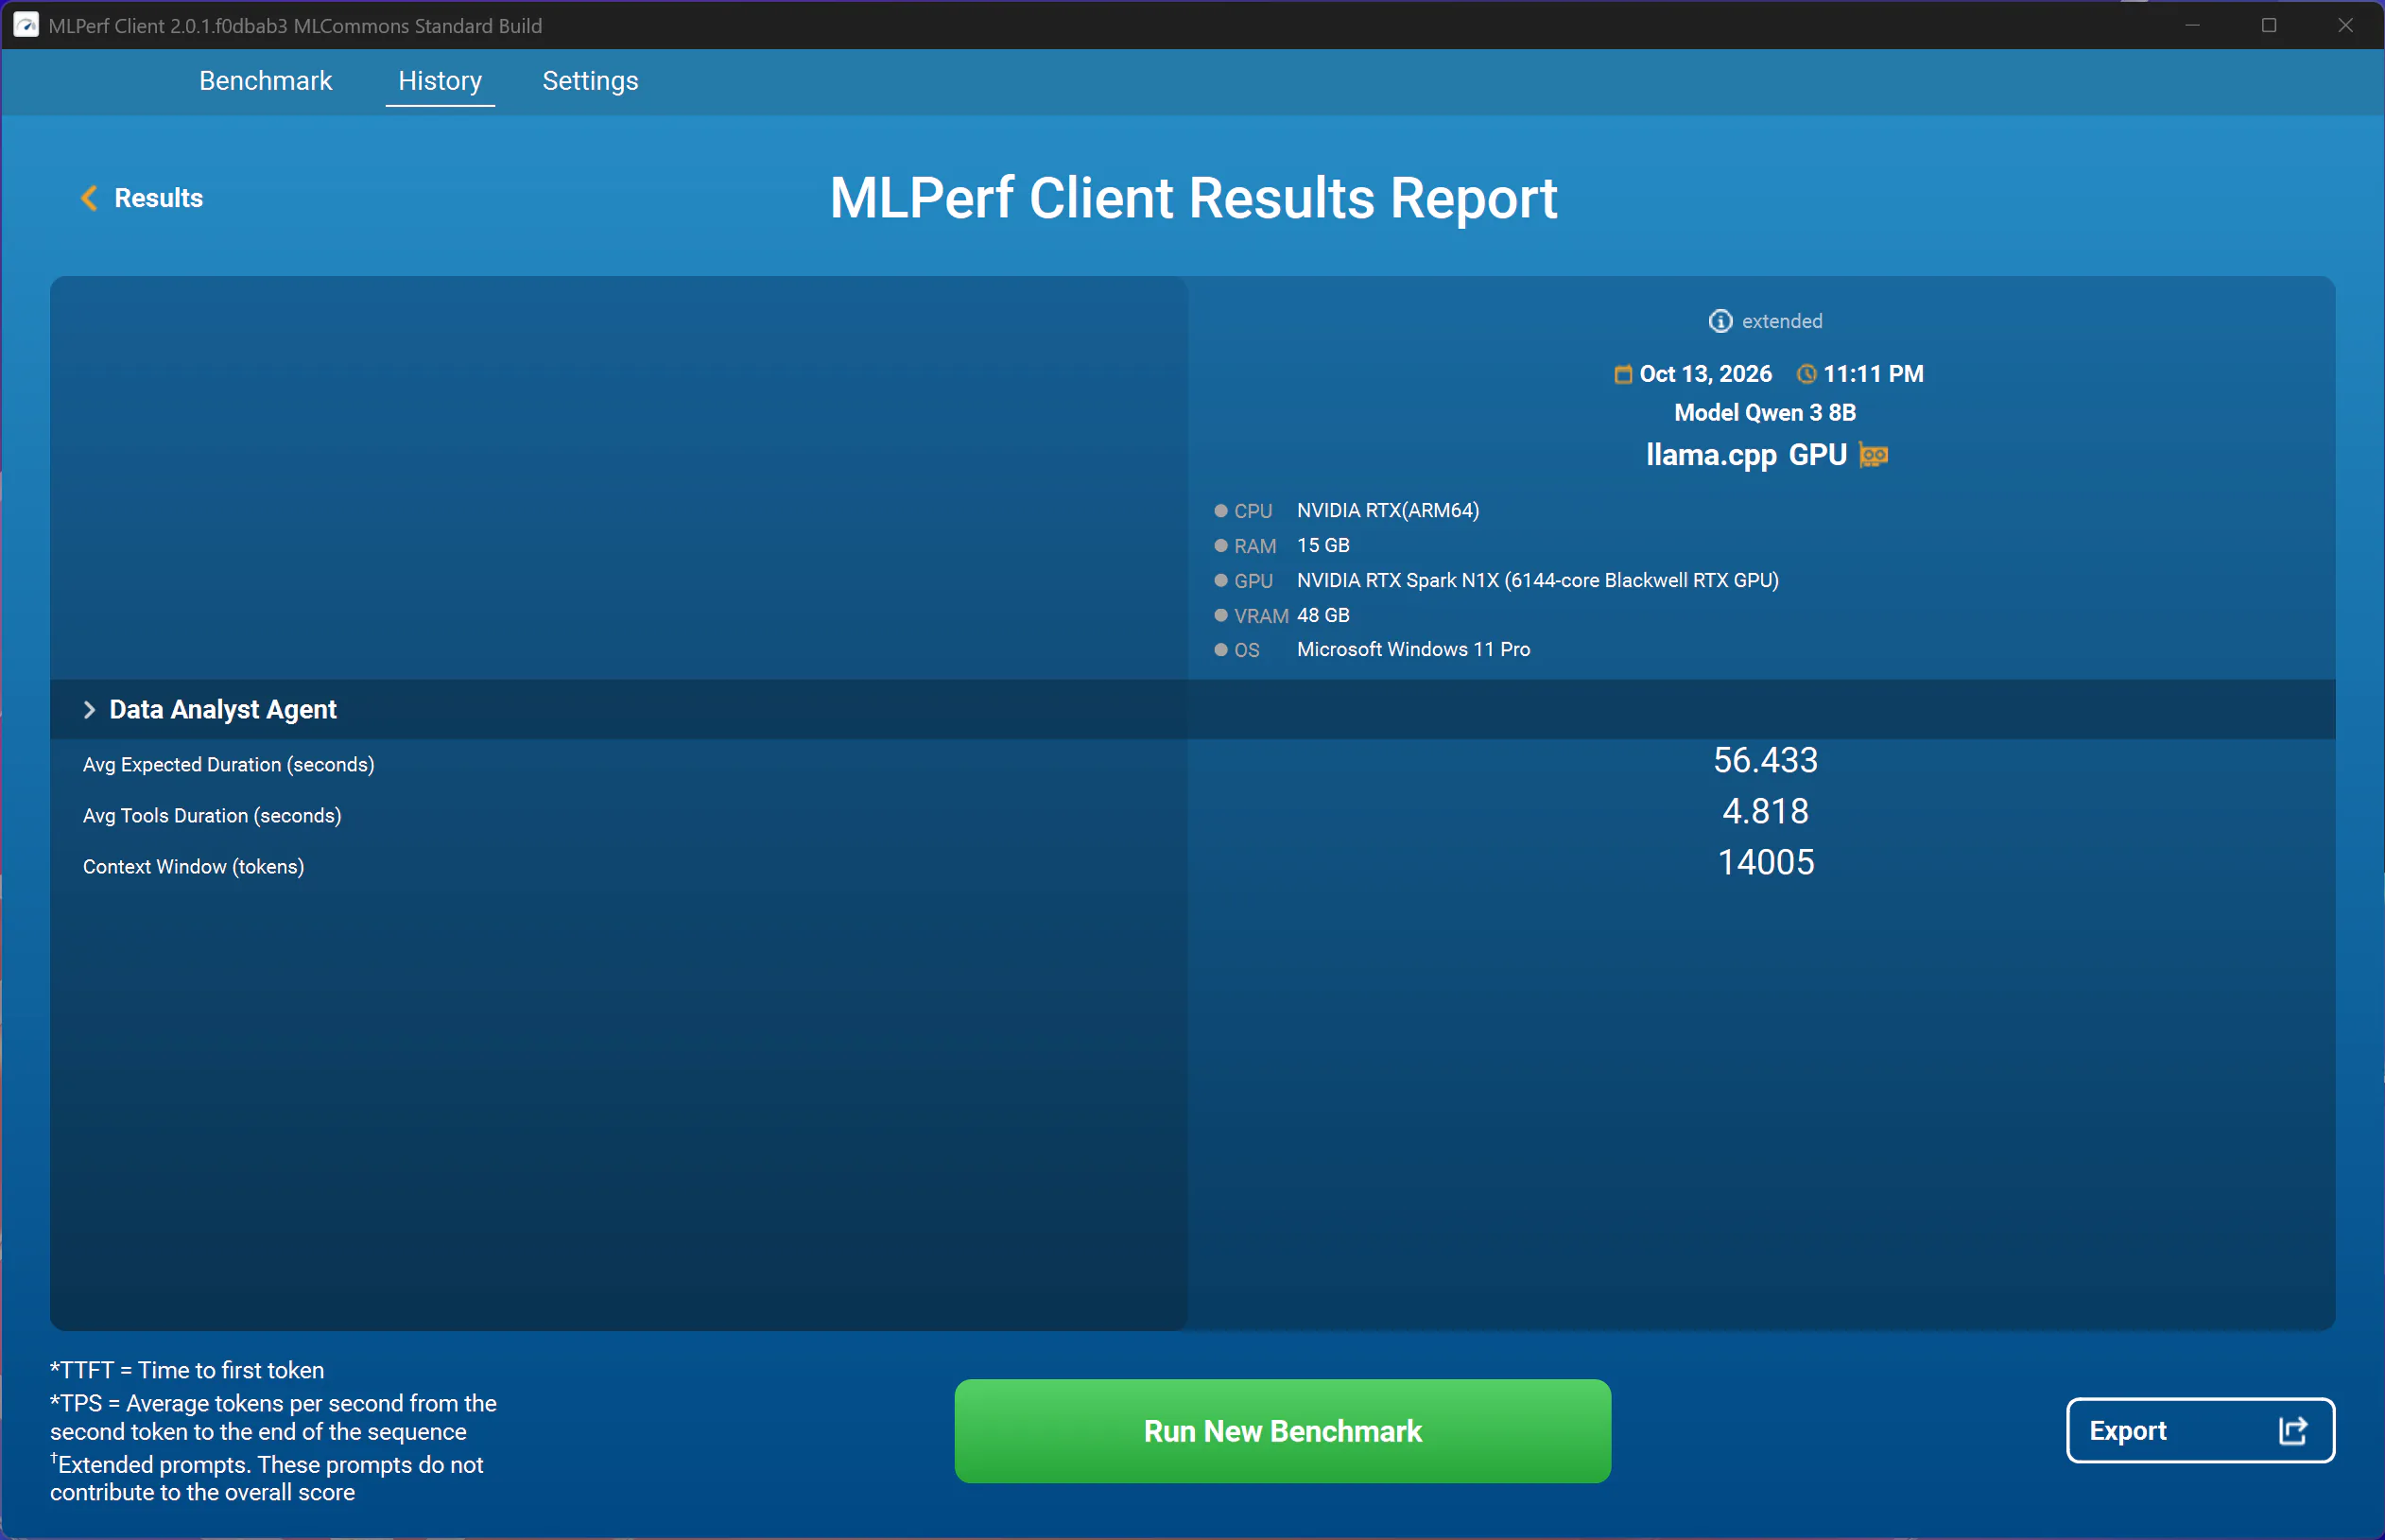
Ở bài kiểm tra Qwen3-8B Agentic Extended, hai lần chạy ghi nhận thời gian lần lượt 57,098 giây và 56,433 giây. Kết quả tương đối sát nhau, cho thấy hệ thống duy trì hiệu năng ổn định trong điều kiện thử nghiệm. Với tác vụ tạo hình ảnh bằng FLUX.2 Klein 4B NVFP4, hệ thống đạt khoảng 37,68–37,69 hình/phút, với thời gian xử lý đầu cuối được ghi nhận ở mức 1,592 giây.

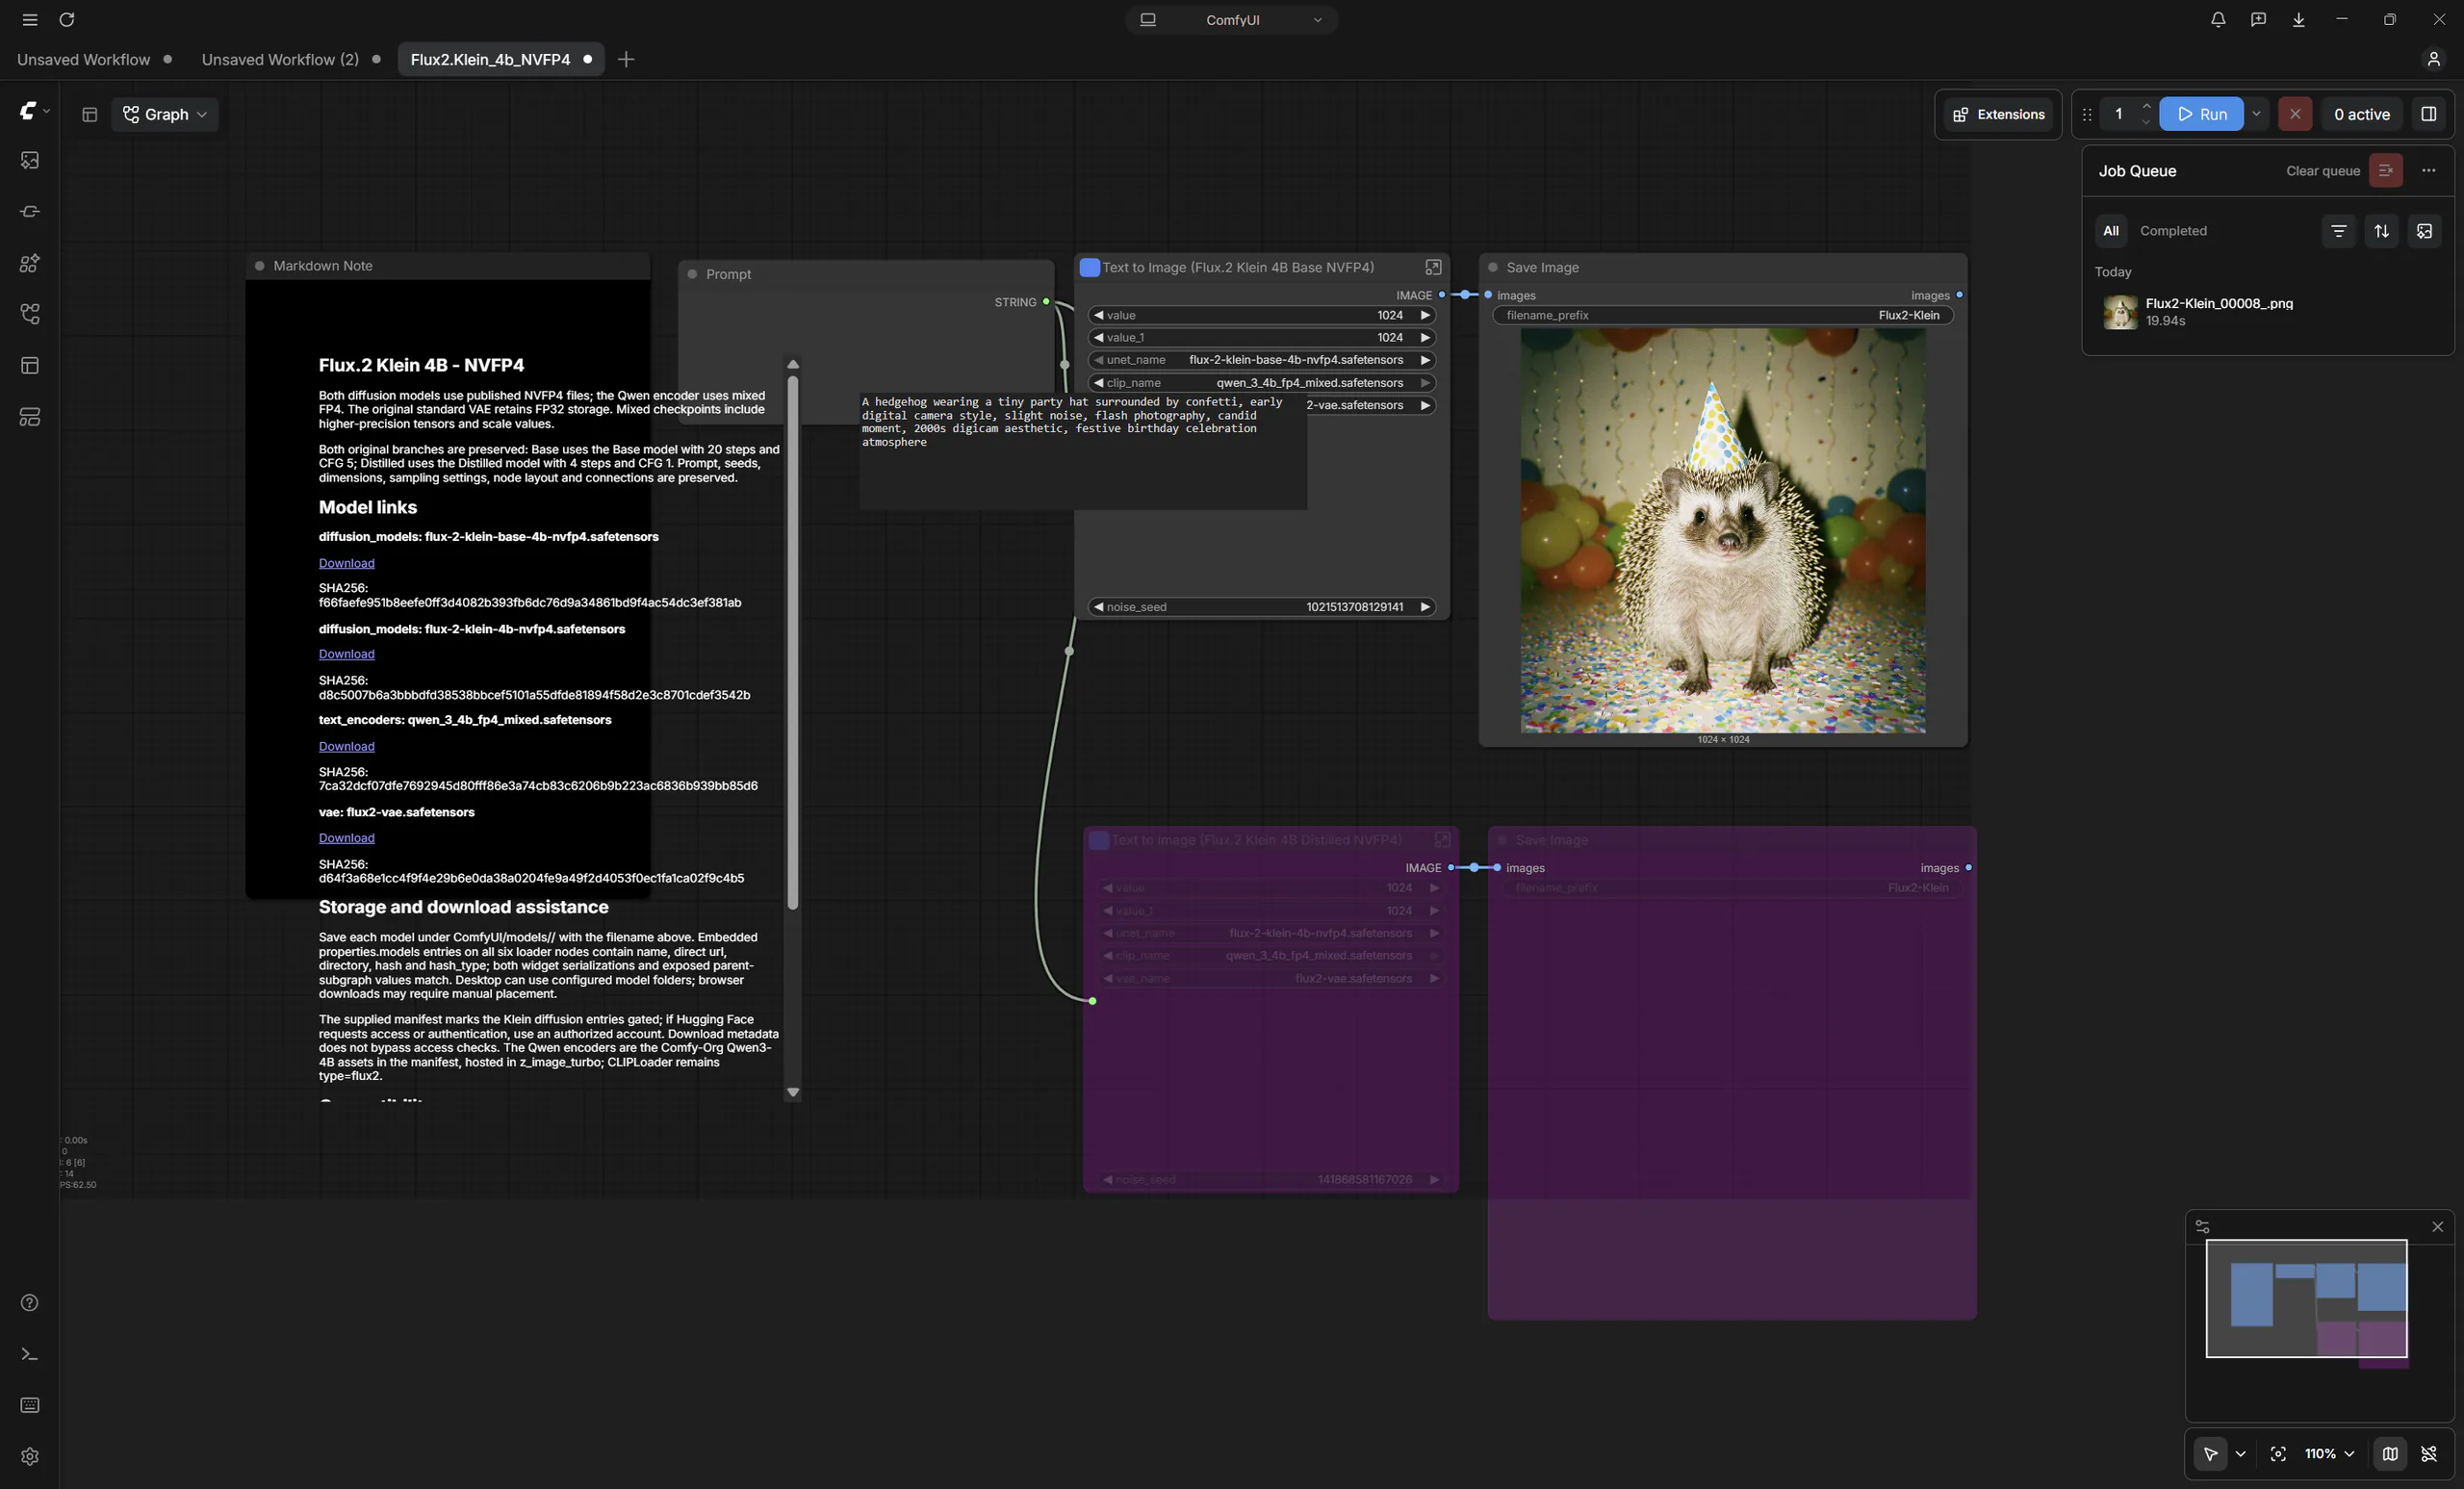
Tuy nhiên, những kết quả benchmark như vậy đôi khi khá khó hình dung. Vì thế, tôi tiếp tục sử dụng ComfyUI, một công cụ quen thuộc với những người thường xuyên thử nghiệm các mô hình tạo ảnh. Điểm thú vị của ComfyUI nằm ở cách xây dựng quy trình xử lý. Người dùng có thể kết nối các thành phần để kiểm soát từng bước tạo hình ảnh, thay vì chỉ nhập câu lệnh vào một giao diện đơn giản.

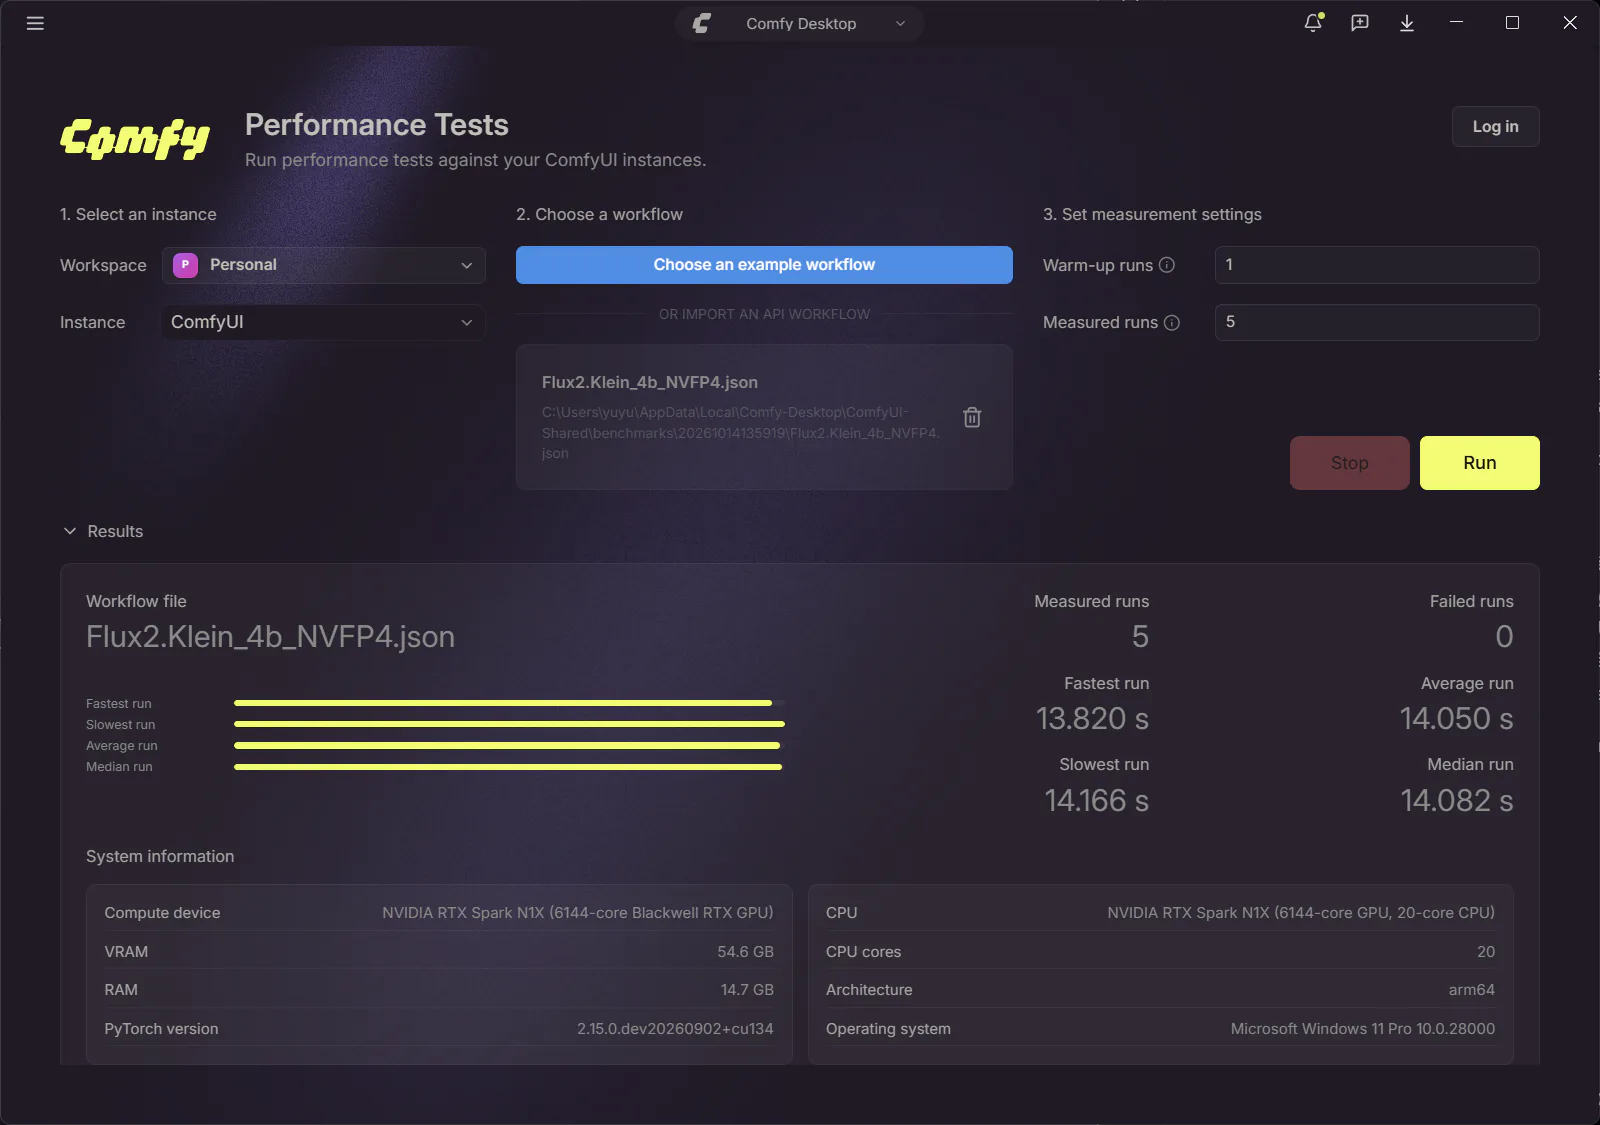
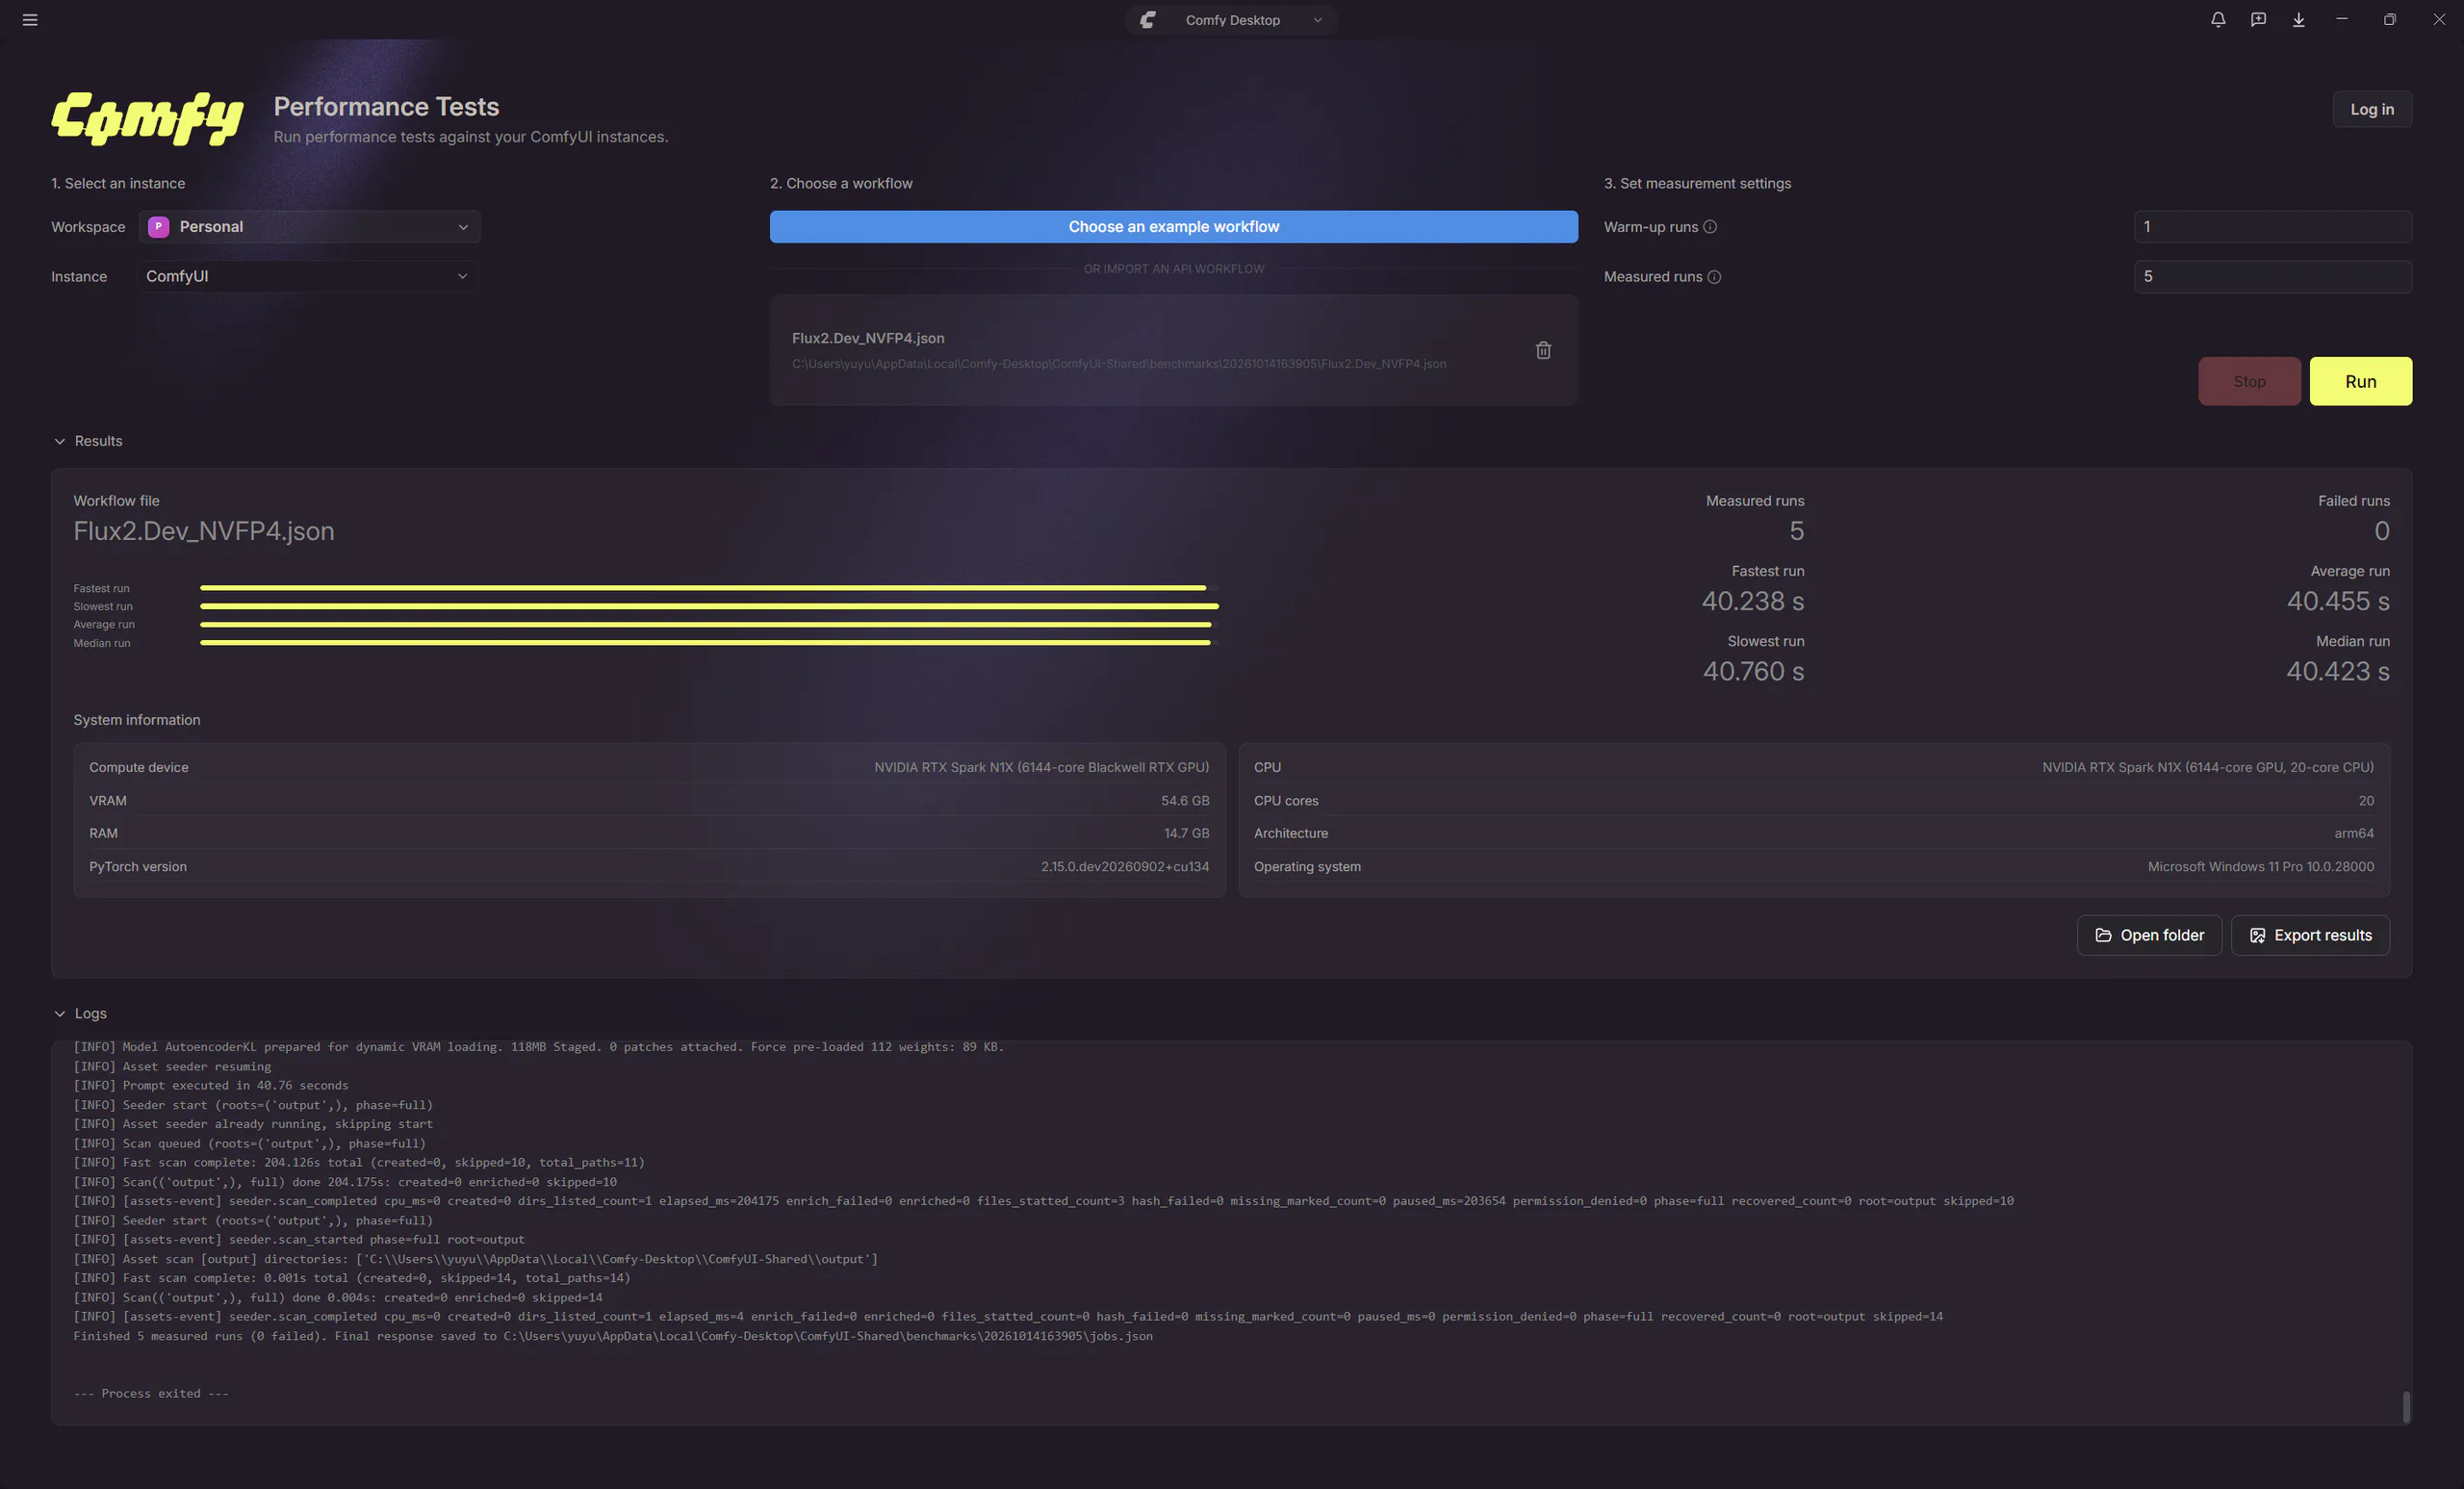
Tôi thực hiện các bài thử trên ComfyUI Desktop dành cho Windows ARM64. Sau một lần chạy khởi động, hệ thống được đo qua năm lần thực hiện tiếp theo.

Với FLUX.2 Klein 4B NVFP4, thời gian xử lý trung bình là 14,05 giây. Khi chuyển sang FLUX.2 Dev NVFP4, thời gian tăng lên 40,46 giây.

Mô hình trên ComfyUI Thời gian trung bình
FLUX.2 Klein 4B NVFP4 14,05 giây
FLUX.2 Dev NVFP4 40,46 giây

Sự chênh lệch giữa hai mô hình là điều có thể dự đoán, bởi chúng có yêu cầu xử lý khác nhau. Quan trọng hơn, cả hai đều có thể hoạt động trực tiếp trên chiếc laptop thử nghiệm.

Với tôi, lợi ích lớn nhất của AI cục bộ trong trường hợp này không nhất thiết là tốc độ nhanh hơn mọi dịch vụ trực tuyến. Điểm đáng giá nằm ở quyền chủ động. Người dùng có thể lựa chọn mô hình, điều chỉnh quy trình, thử nghiệm nhiều cấu hình và xử lý dữ liệu ngay trên thiết bị. Điều này đặc biệt hữu ích với những người làm sáng tạo nội dung hoặc phát triển các công cụ AI theo nhu cầu riêng.

Khi AI tự viết một phần mềm Windows

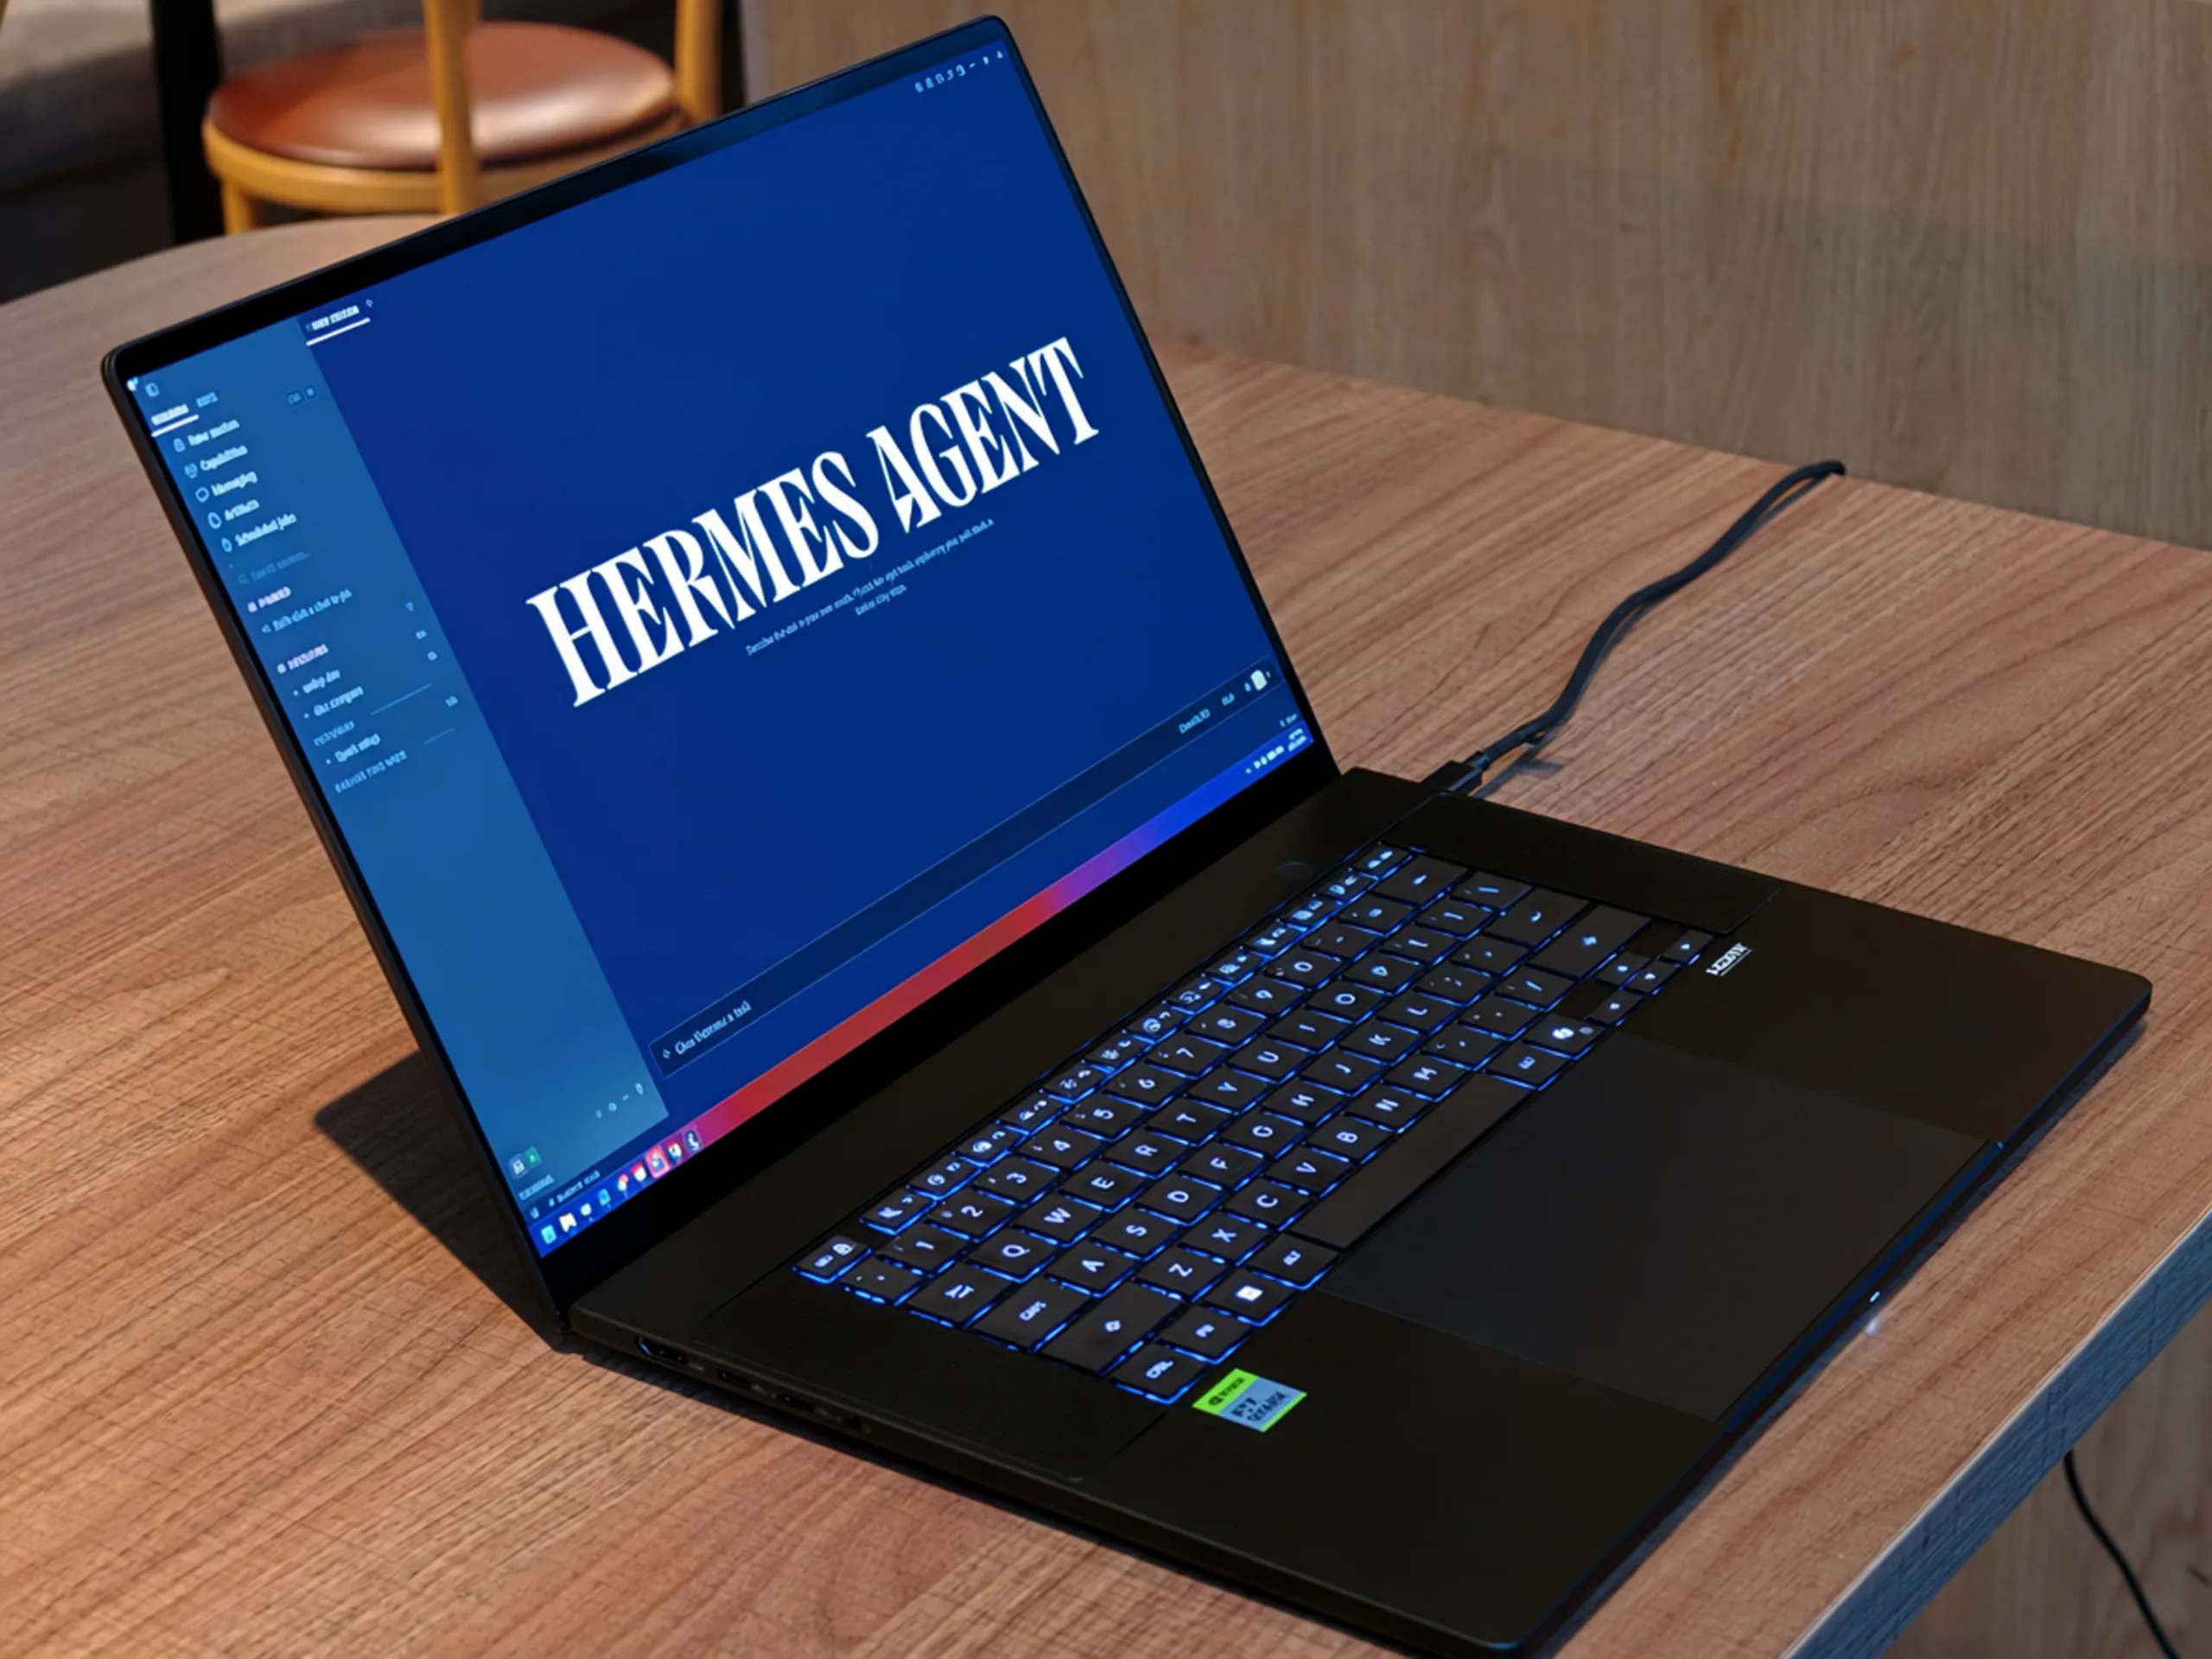
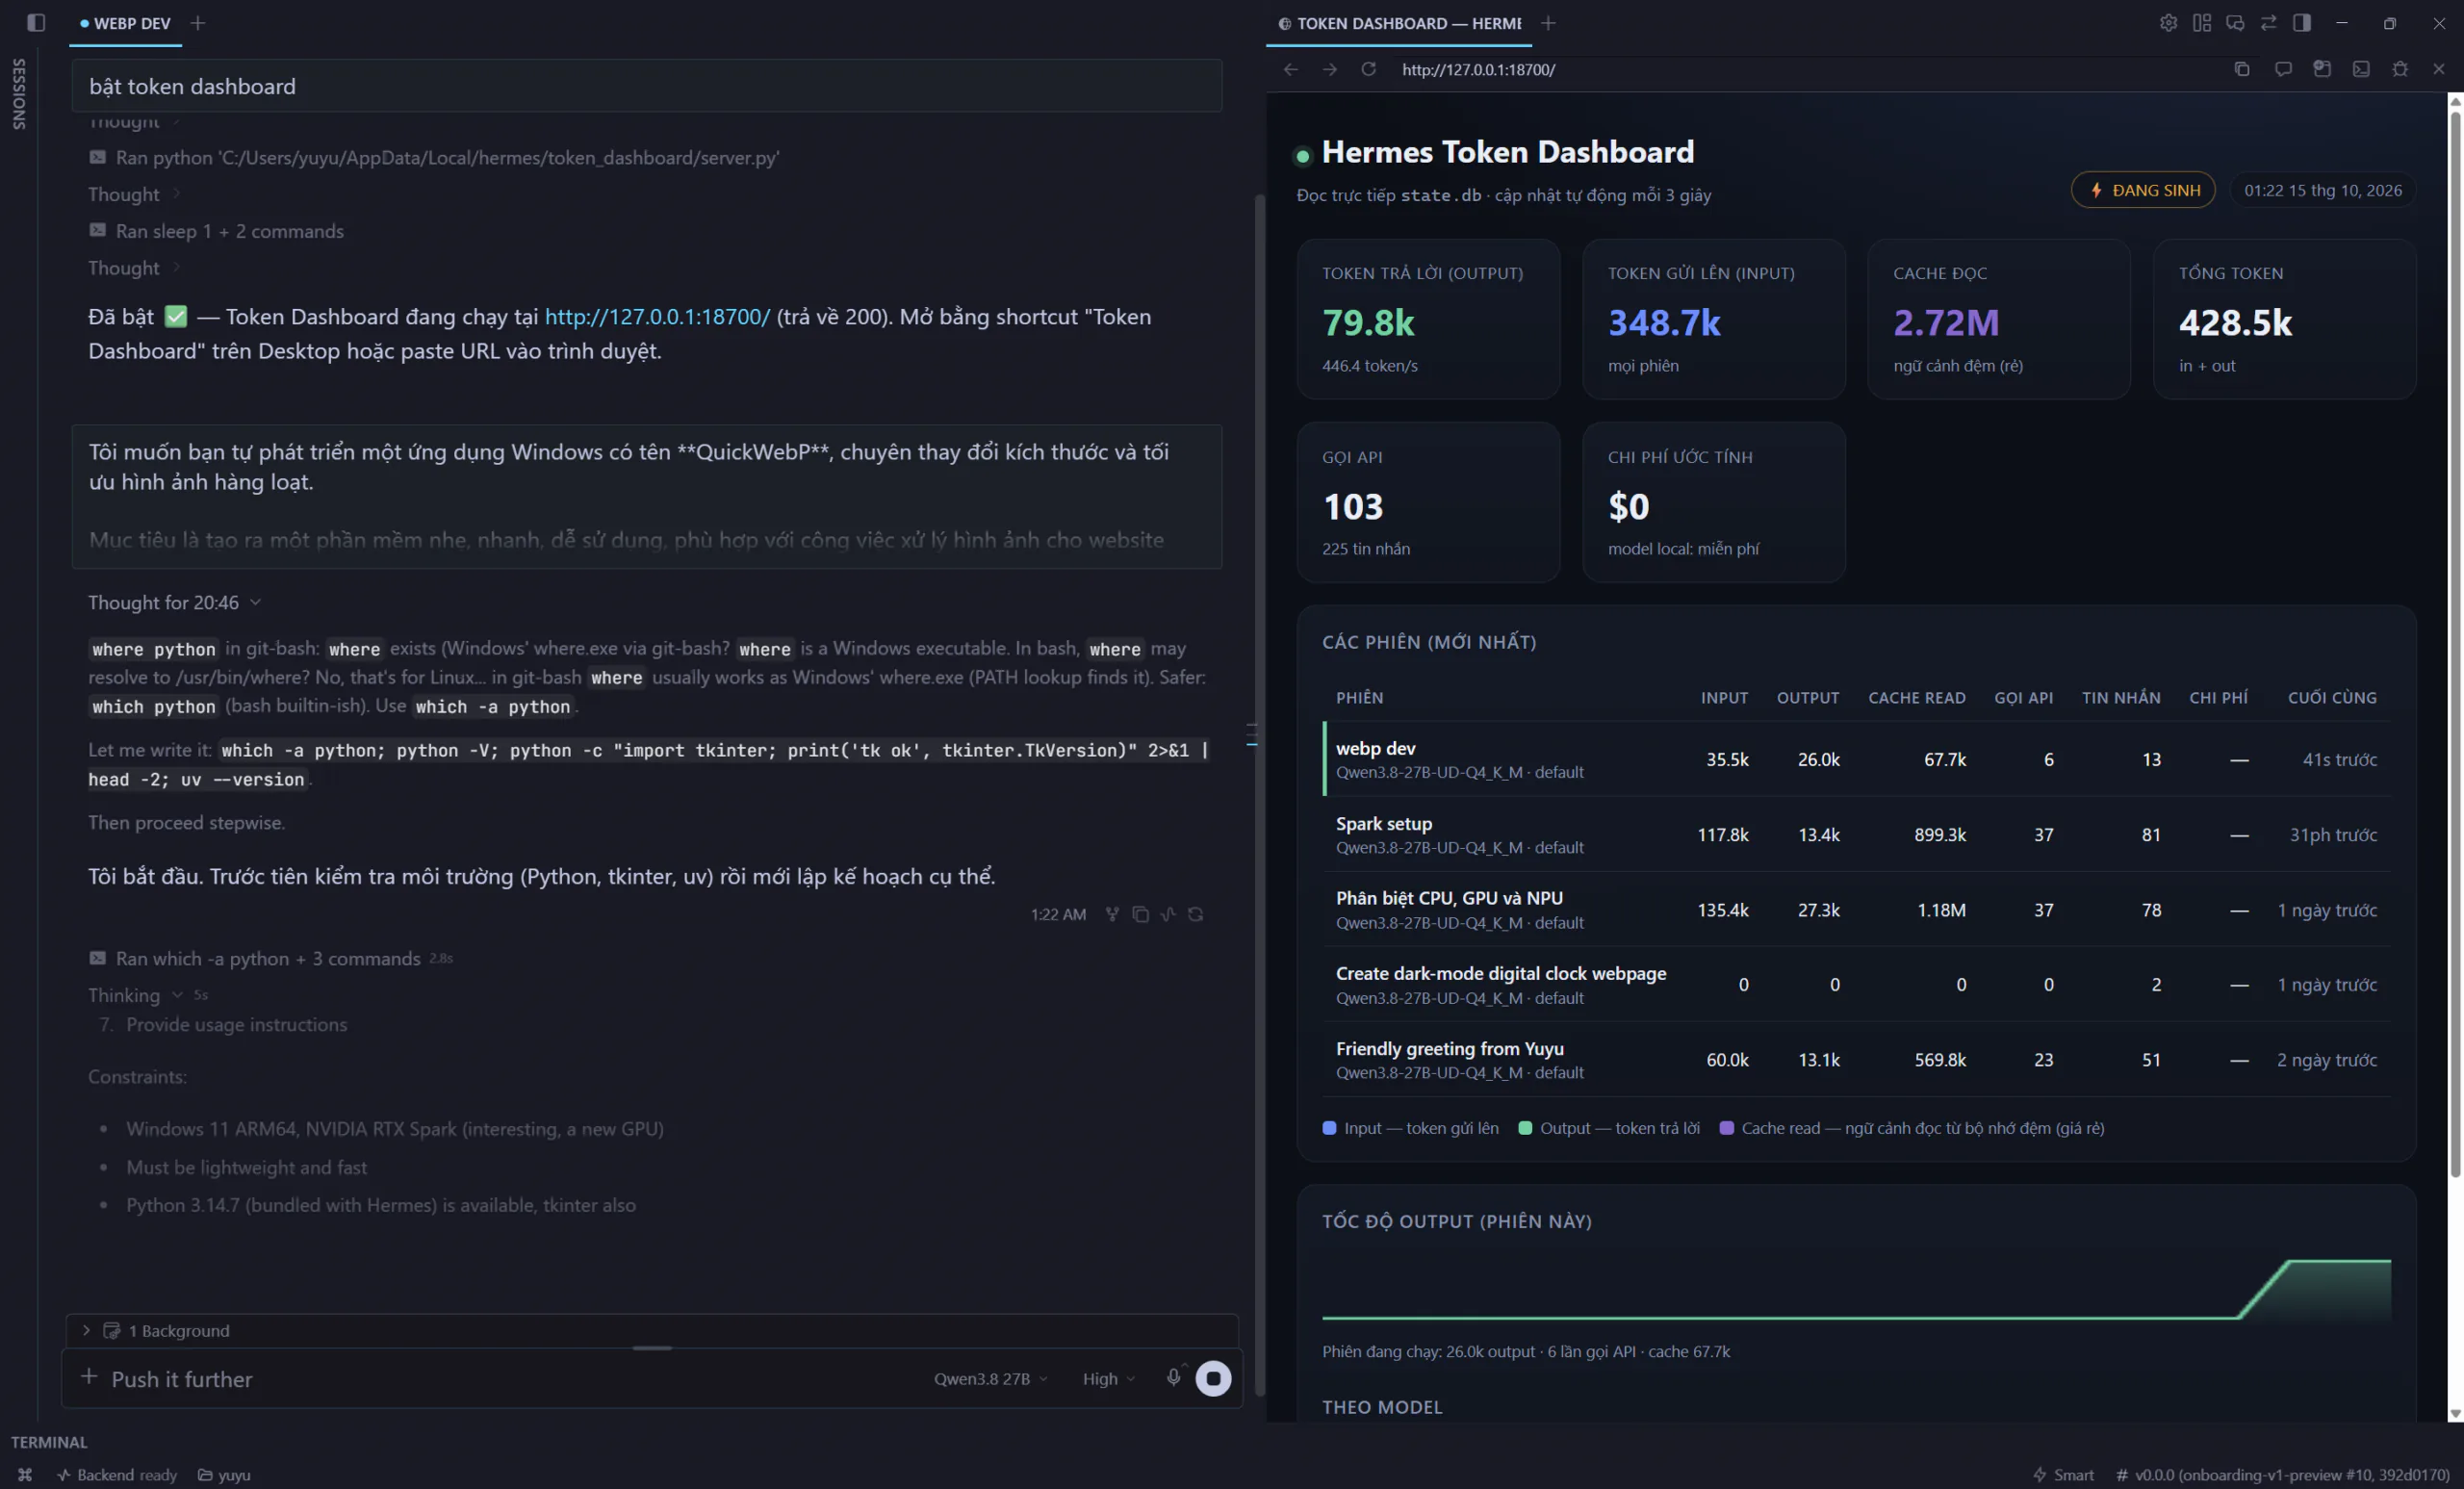
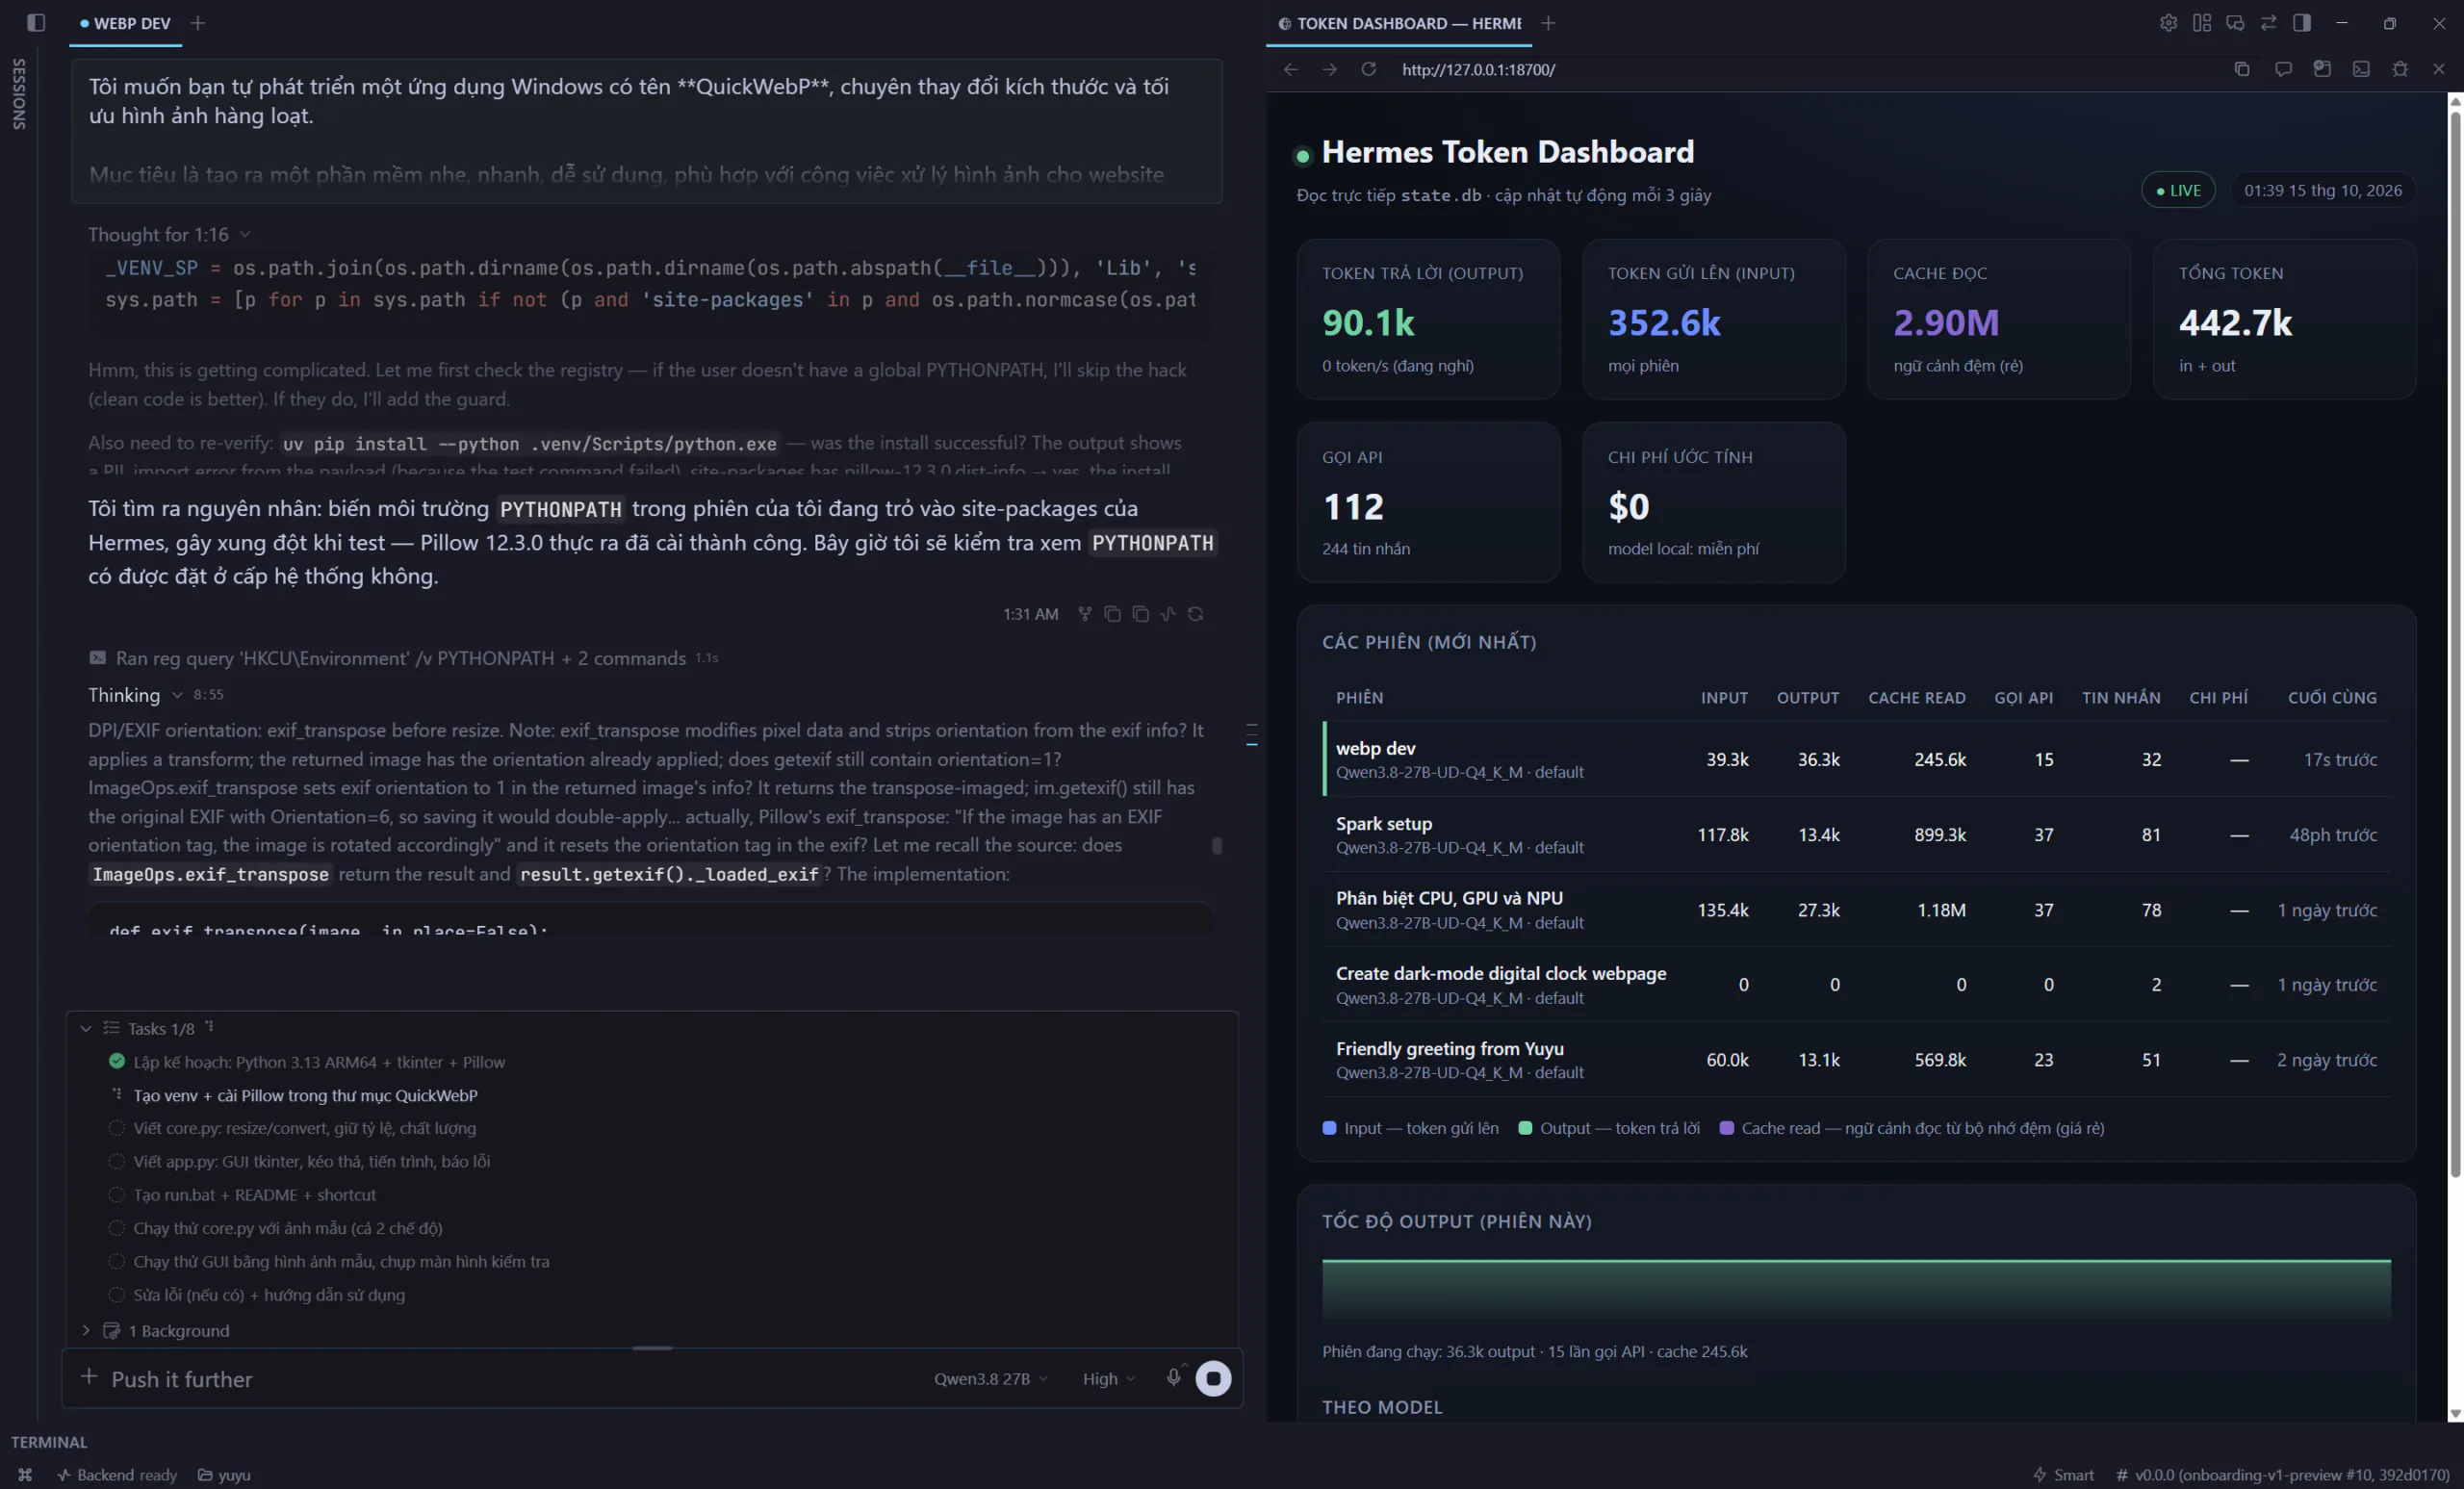
Nếu phải chọn ra trải nghiệm đáng nhớ nhất trong quá trình thử RTX Spark N1X, tôi sẽ chọn phần này. Tôi sử dụng Hermes, một AI agent chạy cục bộ với mô hình Qwen3.8 27B, để thử nghiệm khả năng tự thực hiện công việc trên Windows.

Khác với chatbot thông thường, AI agent có thể sử dụng các công cụ của hệ thống để đọc tệp, thực thi lệnh và xử lý nhiều bước liên tiếp. Thay vì chỉ đưa ra câu trả lời, nó có thể tham gia trực tiếp vào quá trình hoàn thành nhiệm vụ. Tôi quyết định giao cho Hermes một yêu cầu khá gần với công việc hằng ngày: tạo phần mềm Windows để thay đổi kích thước và chuyển đổi định dạng hình ảnh hàng loạt.

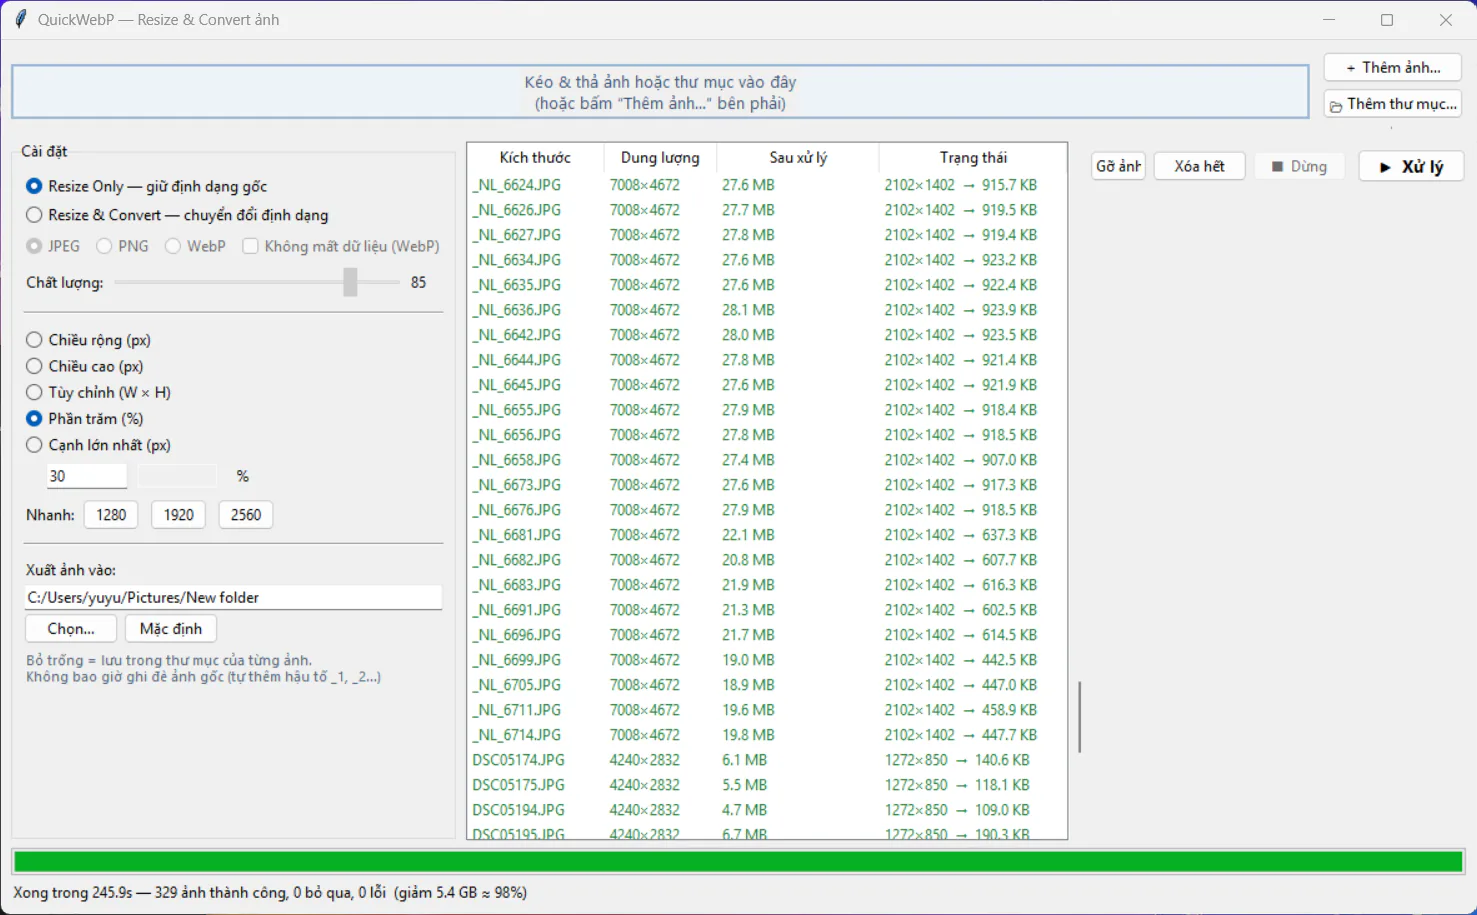
Đây không phải một bài toán quá phức tạp về mặt lập trình, nhưng đủ thực tế để kiểm tra khả năng của AI. Tôi thường xuyên phải xử lý ảnh trước khi đăng bài, từ giảm kích thước đến chuyển sang định dạng phù hợp nhằm tiết kiệm dung lượng lưu trữ. Thay vì tìm kiếm một phần mềm có sẵn, tôi muốn xem AI có thể tự xây dựng một công cụ đáp ứng nhu cầu này hay không. Hermes bắt đầu thực hiện các bước cần thiết và tạo ra một ứng dụng có giao diện đồ họa mang tên QuickWebP.

Phần mềm hỗ trợ thay đổi kích thước nhiều ảnh cùng lúc, giữ nguyên định dạng hoặc chuyển sang JPEG, PNG và WebP. Ngoài ra còn có thanh tiến trình, cơ chế hạn chế ghi đè tệp gốc và sử dụng thuật toán Lanczos khi thay đổi kích thước.

Điều khiến tôi hài lòng là sản phẩm cuối cùng không dừng lại ở một đoạn mã nguồn để tham khảo. QuickWebP có thể mở trên Windows và thực hiện những thao tác xử lý ảnh thực tế. Tôi bắt đầu bằng một bộ ảnh tương đối lớn, gồm 329 tệp với tổng dung lượng khoảng 5,4 GB. Khi thiết lập thu nhỏ ảnh về 30% kích thước ban đầu, QuickWebP hoàn thành công việc trong 245,9 giây, tương đương hơn 4 phút. Tổng dung lượng ảnh đầu ra giảm khoảng 98% và không ghi nhận lỗi trong quá trình xử lý.

Tôi tiếp tục thử chuyển đổi 20 ảnh sang JPEG. Lần này, phần mềm chỉ mất 8,8 giây. Với cùng số lượng ảnh chuyển sang WebP, thời gian xử lý là 12,3 giây.

Tác vụ QuickWebP Thời gian Lỗi
Xử lý 329 ảnh 245,9 giây 0
Chuyển 20 ảnh sang JPEG 8,8 giây 0
Chuyển 20 ảnh sang WebP 12,3 giây 0

Tất nhiên, QuickWebP chưa thể được xem là một phần mềm hoàn thiện ở cấp độ thương mại. Nó vẫn cần được kiểm tra thêm với nhiều định dạng, kích thước ảnh và những tình huống sử dụng khác nhau. Nhưng mục tiêu ban đầu của tôi không phải tạo ra một đối thủ cho các phần mềm xử lý ảnh chuyên nghiệp.

Điều tôi muốn kiểm chứng là liệu AI cục bộ có thể biến một yêu cầu bằng ngôn ngữ tự nhiên thành một công cụ sử dụng được hay không. Và trong trường hợp này, Hermes đã thực hiện được điều đó. Đây là điểm khiến tôi đánh giá cao tiềm năng của AI agent. Thay vì phải tự viết từng dòng mã, người dùng có thể mô tả vấn đề, để AI thực hiện những bước cần thiết, sau đó kiểm tra và điều chỉnh kết quả.

Tuy nhiên, quá trình thử nghiệm cũng bộc lộ một hạn chế đáng chú ý của chiếc ASUS ProArt.

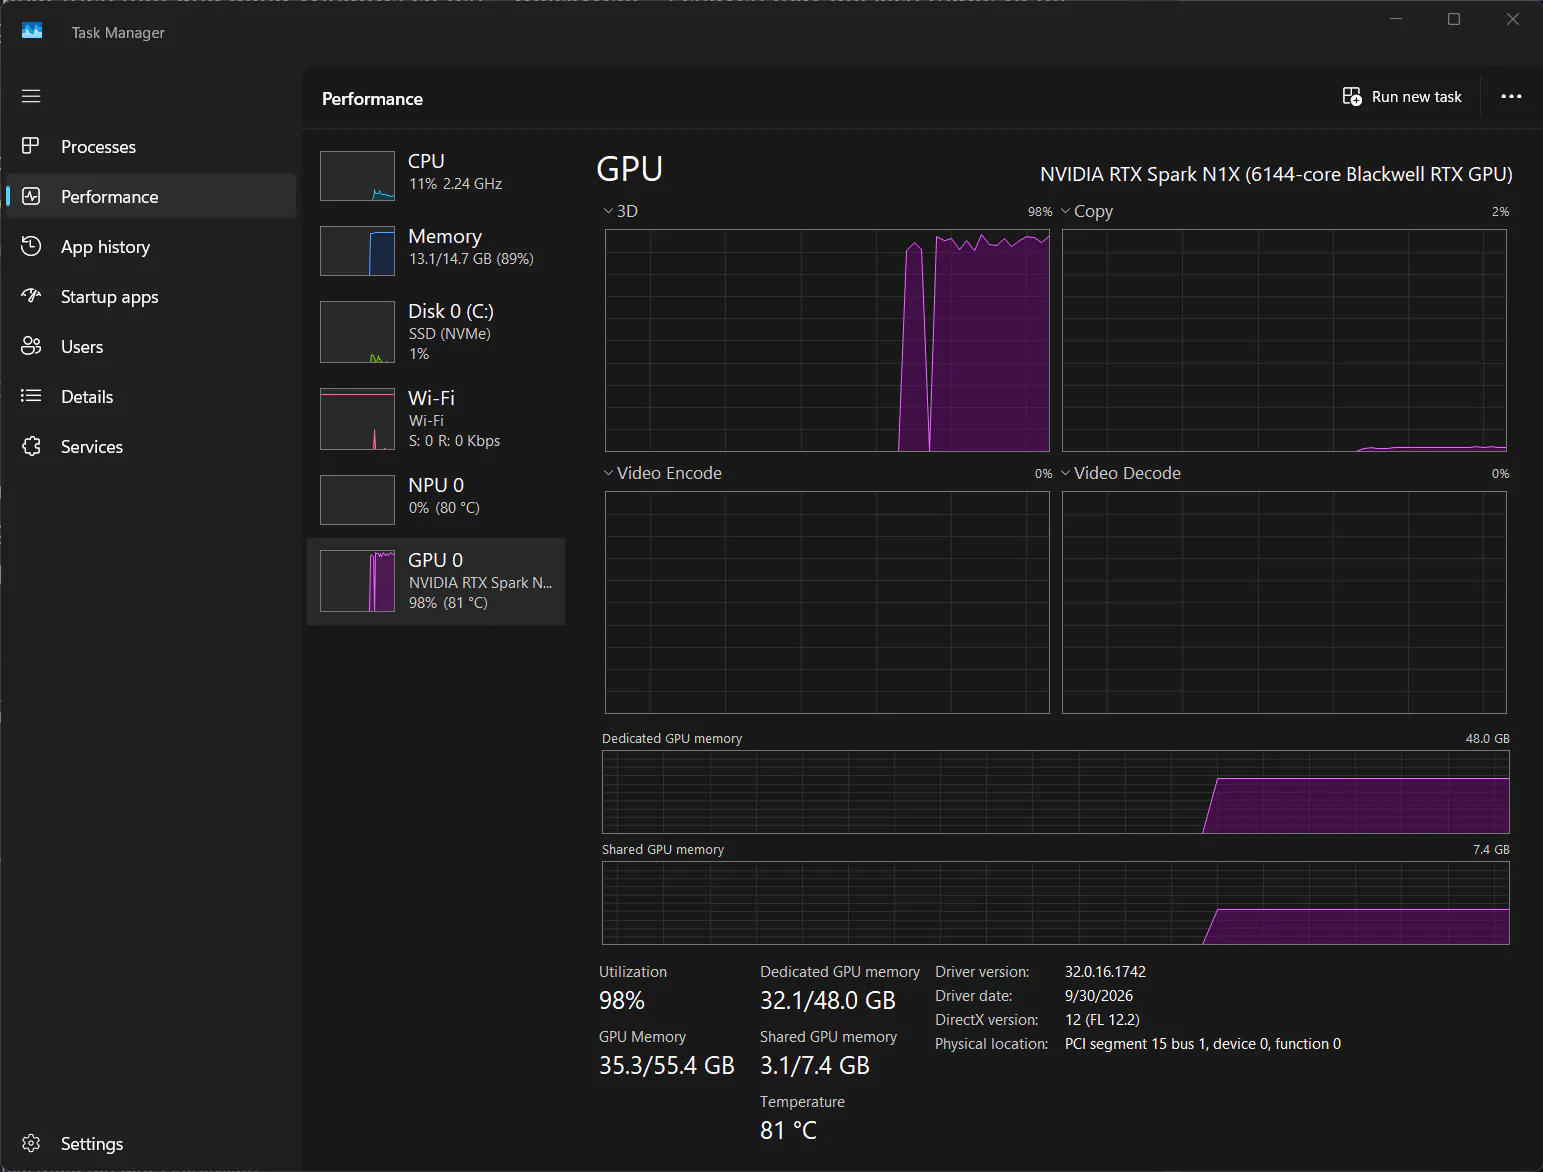
Khi Hermes chạy liên tục để viết và hoàn thiện phần mềm, nhiệt độ GPU có thời điểm đạt 85°C theo thông số hiển thị trong Task Manager. Cùng lúc đó, quạt tản nhiệt hoạt động khá ồn, dễ nhận thấy trong quá trình sử dụng.

Đây là điểm khiến trải nghiệm chưa thực sự thoải mái, nhất là khi AI phải thực hiện những chuỗi công việc kéo dài. Khác với việc gửi một câu hỏi đến dịch vụ AI trực tuyến, chạy mô hình cục bộ đồng nghĩa với việc laptop phải trực tiếp đảm nhận toàn bộ khối lượng tính toán. Dù hệ thống vẫn hoàn thành các tác vụ được giao, mức nhiệt GPU 85°C và tiếng quạt lớn cho thấy hệ thống tản nhiệt trên chiếc ASUS ProArt thử nghiệm phải hoạt động khá vất vả.
Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 43

Cũng cần phân biệt rằng đây là nhiệt độ GPU được ghi nhận tại một thời điểm, không phải nhiệt độ bề mặt máy hay kết quả đo trung bình trong toàn bộ quá trình. Chỉ riêng con số 85°C chưa đủ để kết luận phần cứng hoạt động ngoài giới hạn an toàn. Tuy nhiên, xét từ góc độ người sử dụng, tiếng ồn vẫn là một nhược điểm thực tế. Với một chiếc laptop hướng đến các công việc sáng tạo và AI chuyên sâu, ASUS sẽ cần cân bằng tốt hơn giữa hiệu năng, nhiệt độ và độ ồn nếu muốn mang lại trải nghiệm dễ chịu trong thời gian dài.

Ngoài QuickWebP, tôi còn thử yêu cầu Hermes tìm hiểu những công cụ cần thiết để so sánh hai bản hợp đồng PDF hoặc DOCX. AI đã xác định được các công cụ đọc tài liệu và những kỹ năng có thể hỗ trợ việc đối chiếu nội dung, đồng thời chỉ ra một số thư viện còn thiếu và các vấn đề liên quan đến độ chính xác, bảo mật dữ liệu. Tôi dừng thử nghiệm ở bước khảo sát, chưa tiến hành cài đặt thêm thành phần hay so sánh hợp đồng thực tế. Dù vậy, khả năng tự xác định những gì cần chuẩn bị cho một nhiệm vụ mới vẫn là một đặc điểm đáng chú ý.

Hiệu năng đồ họa của RTX Spark N1X

Mặc dù NVIDIA RTX Spark N1X được phát triển với trọng tâm là xử lý AI cục bộ, tôi vẫn muốn kiểm tra khả năng chơi game của nền tảng này. Xét cho cùng, GPU Blackwell với 6.144 nhân CUDA không chỉ phục vụ các mô hình AI mà còn có thể đảm nhận những tác vụ đồ họa truyền thống.
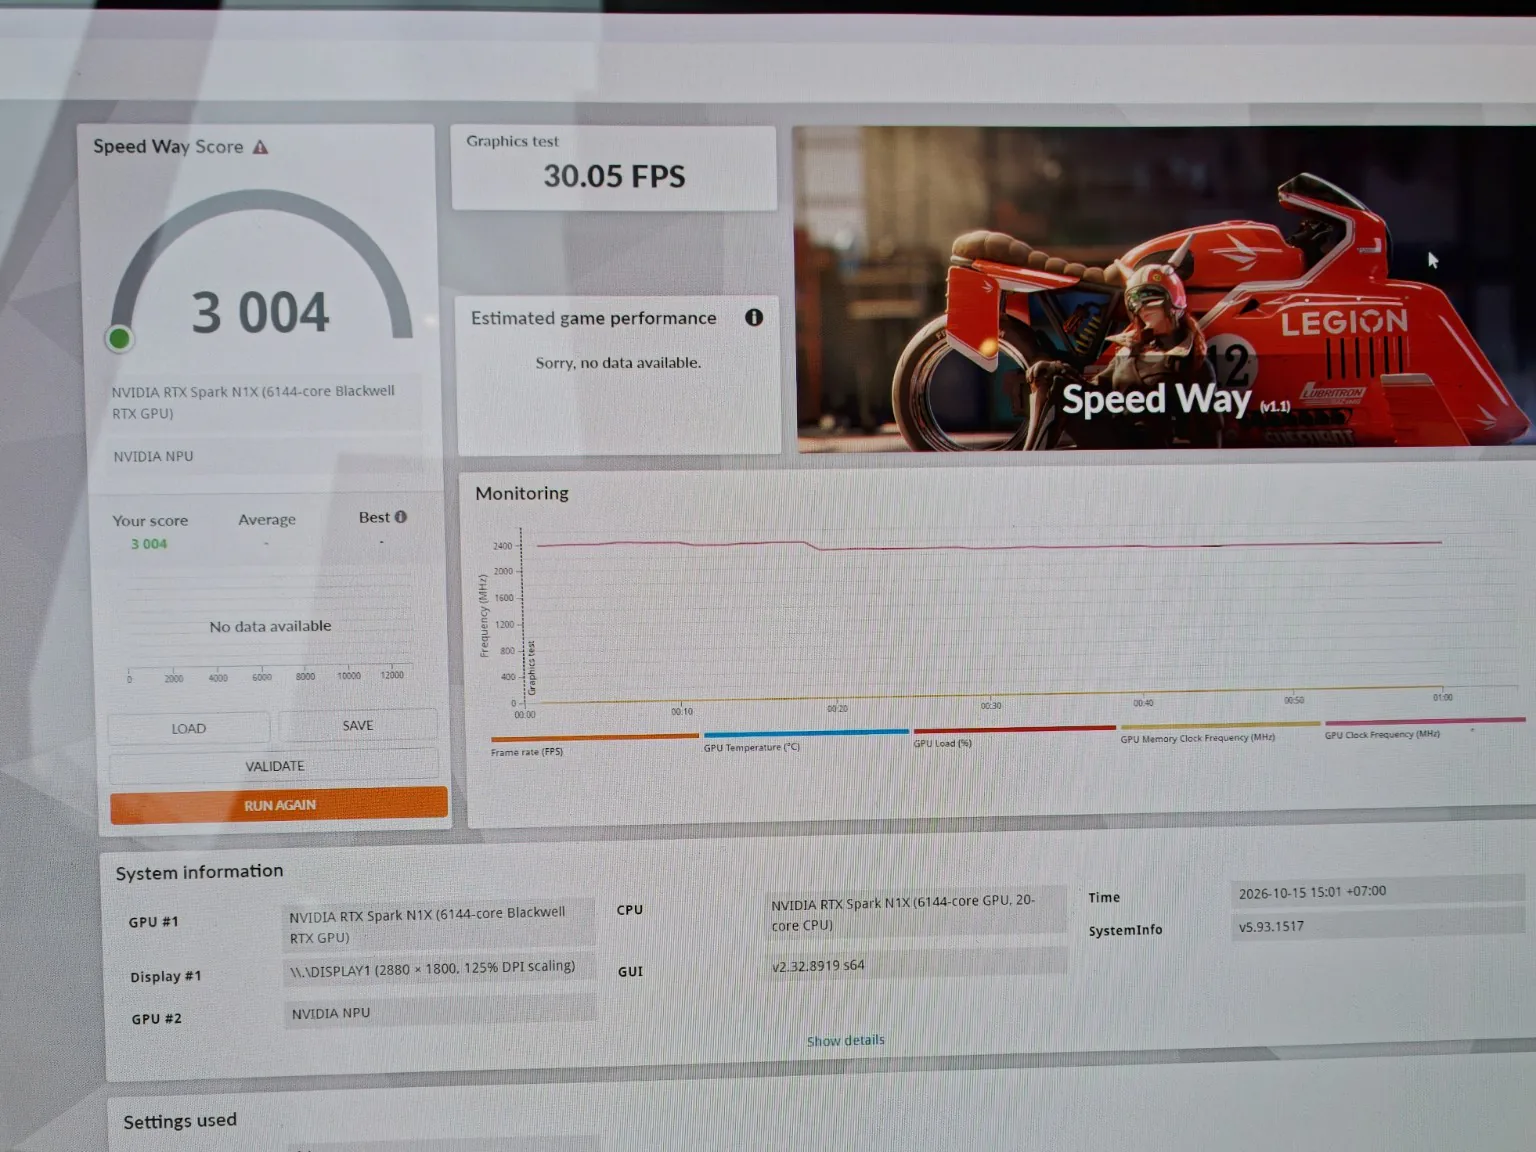
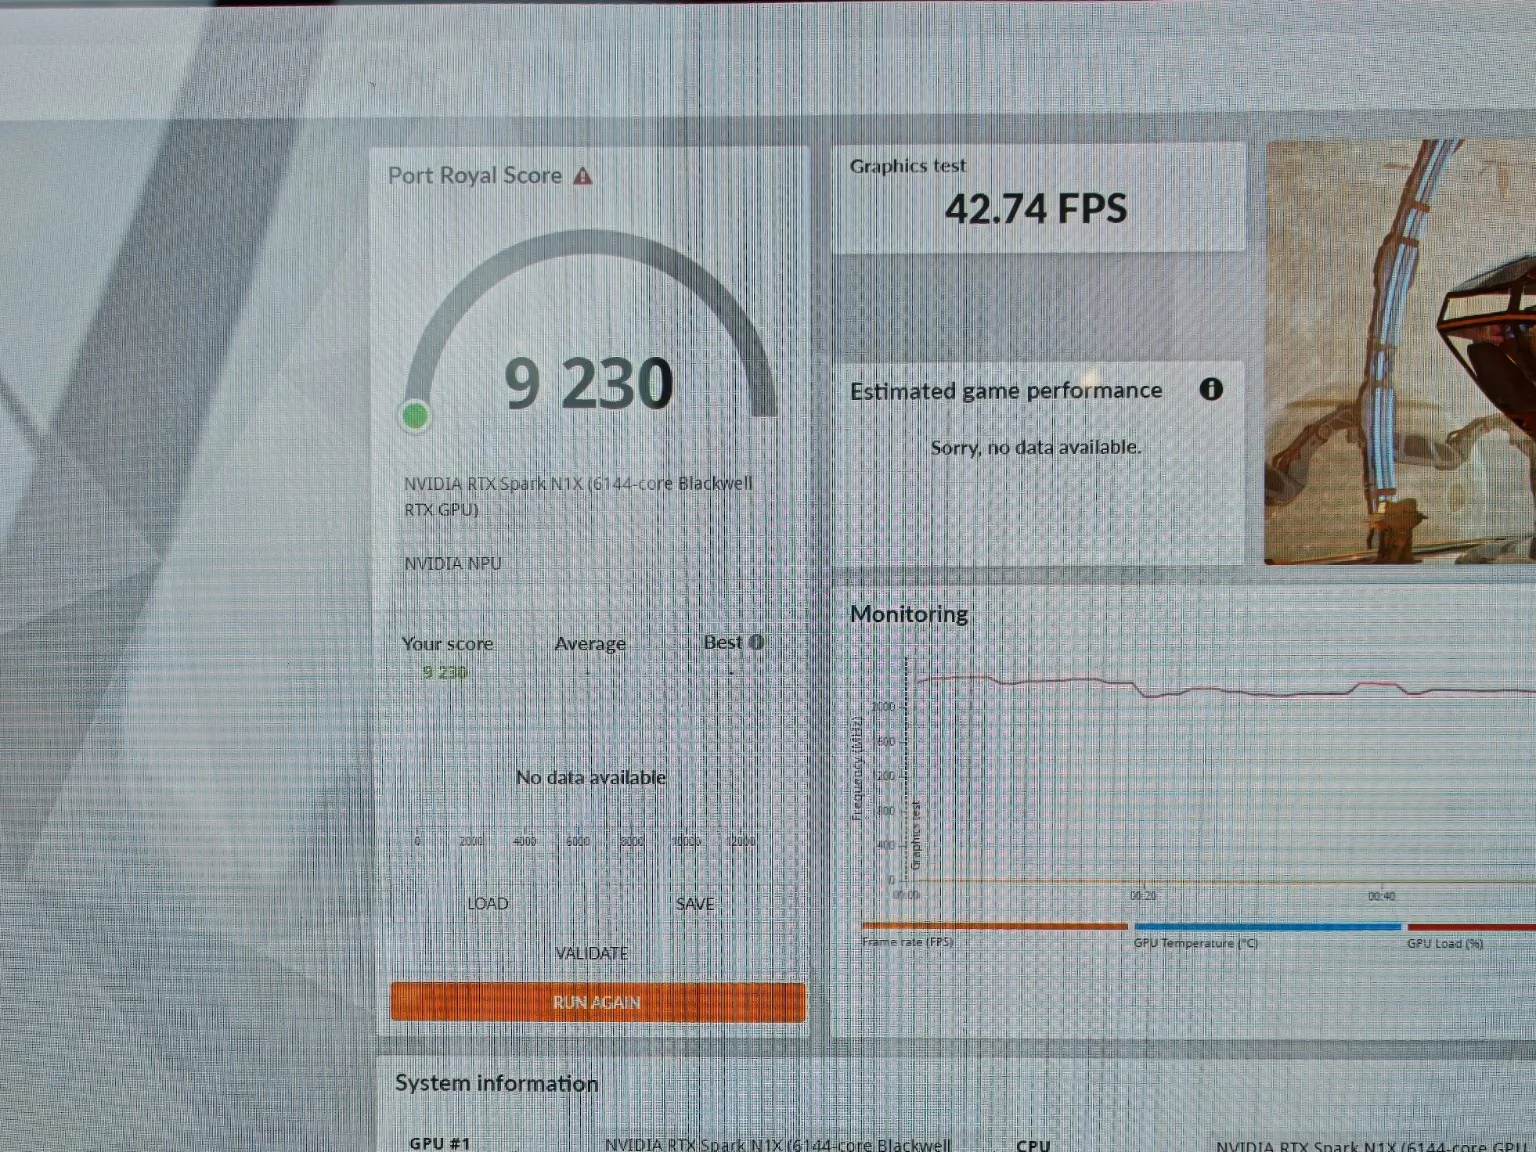
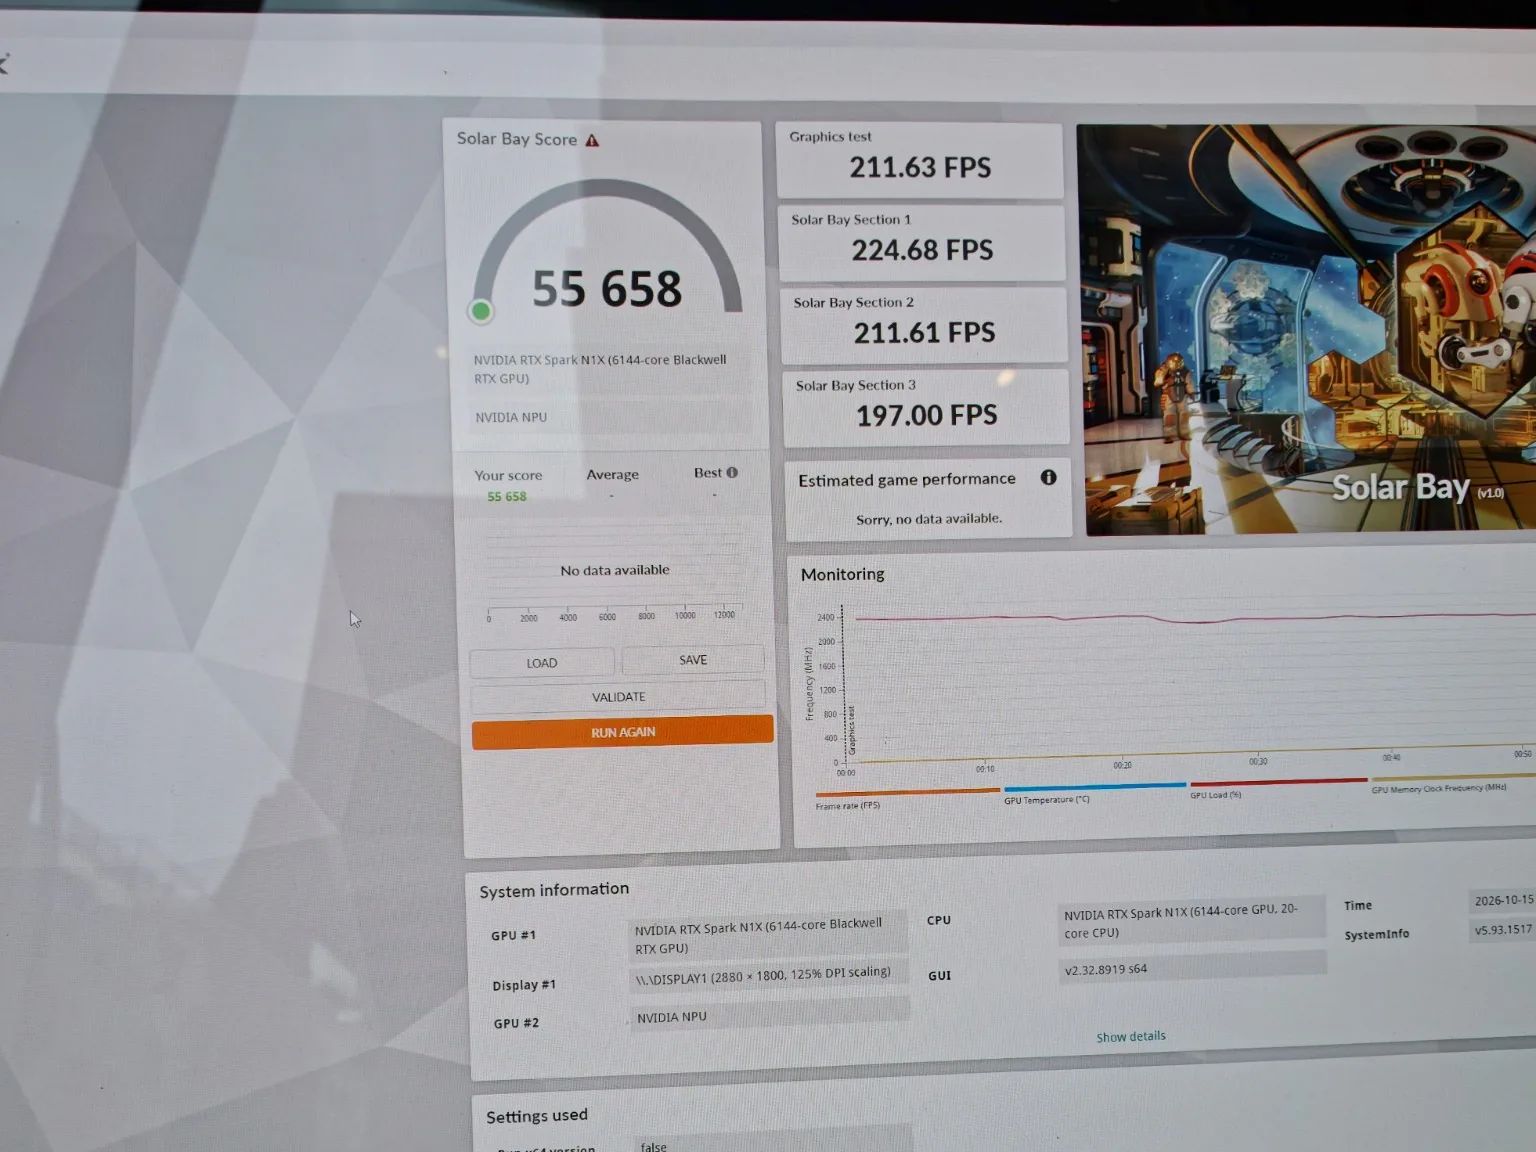
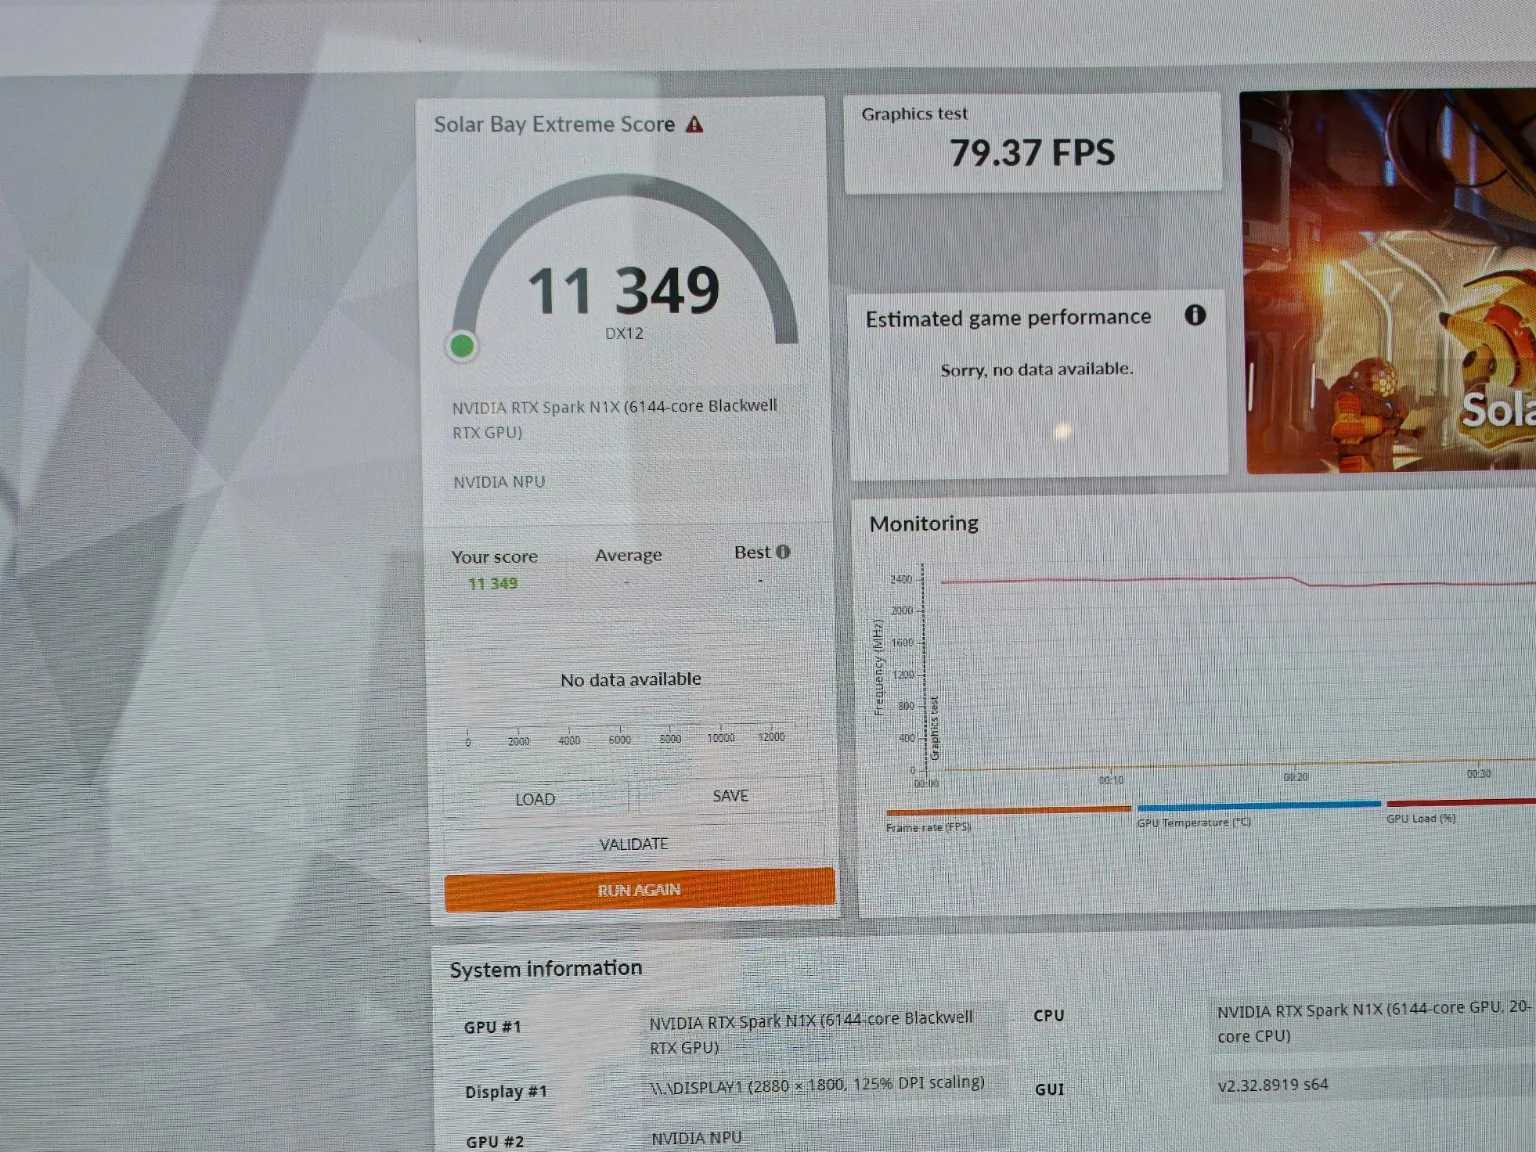
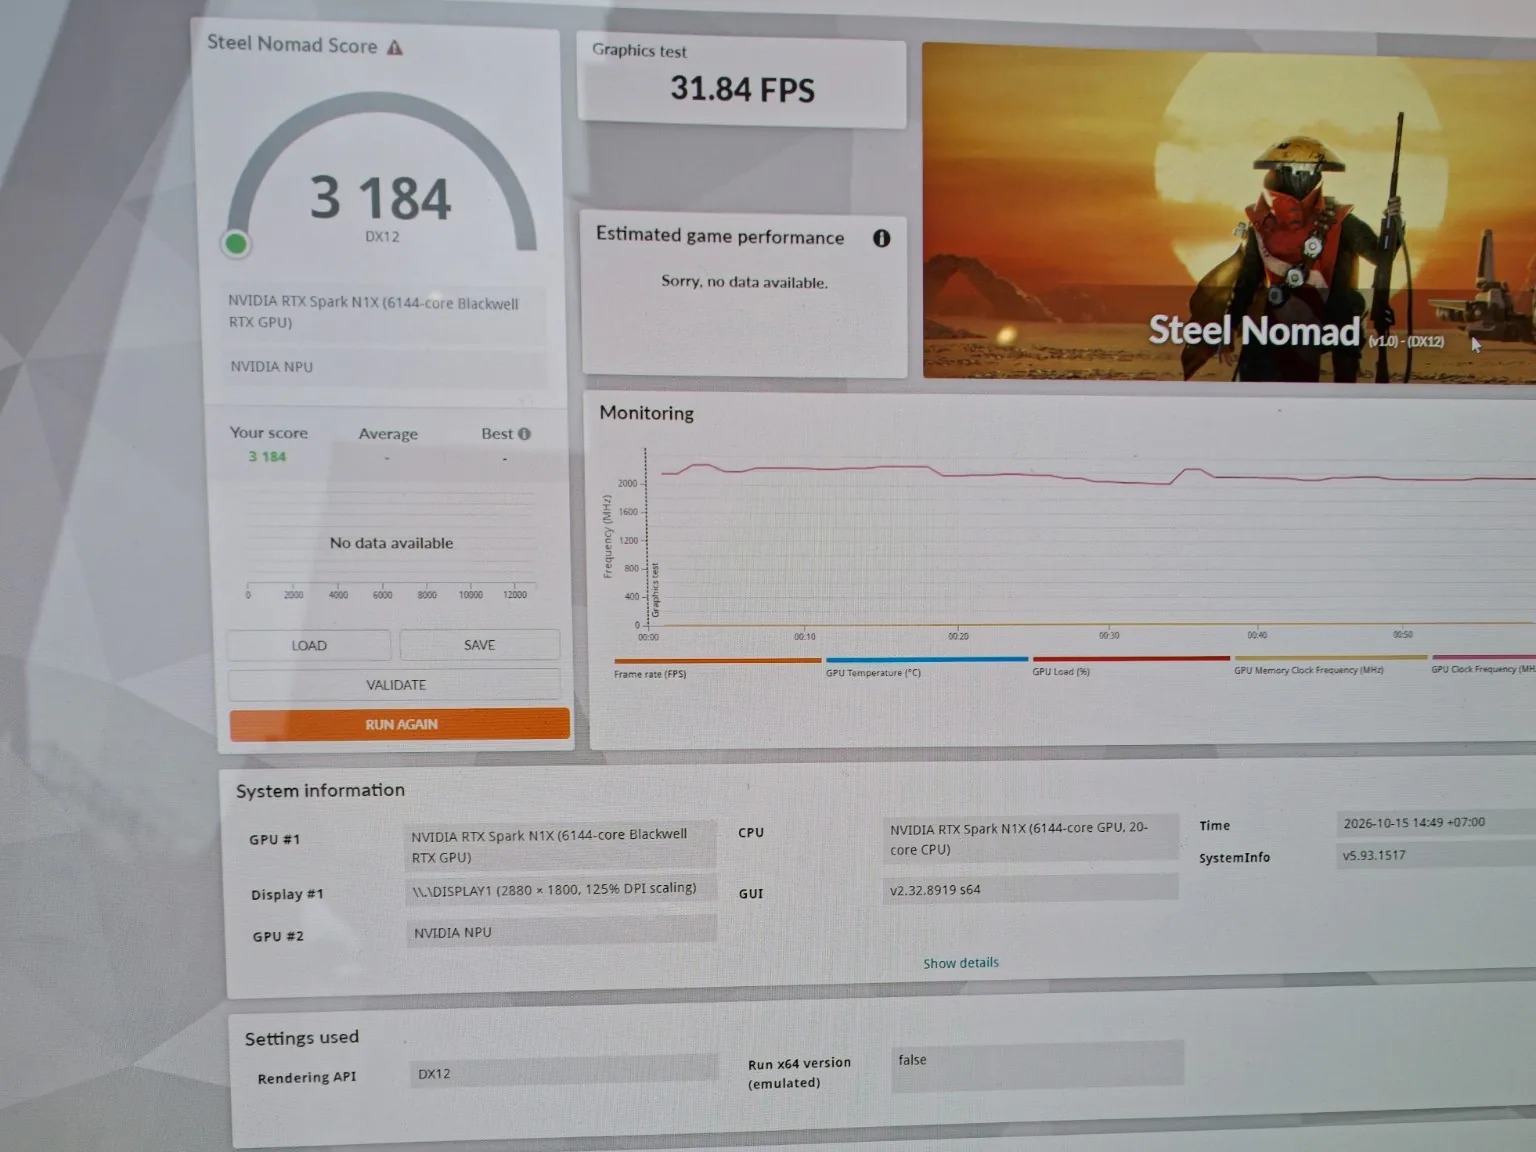
Đầu tiên, tôi sử dụng 3DMark với năm bài kiểm tra gồm Port Royal, Solar Bay, Solar Bay Extreme, Steel Nomad và Speed Way. Kết quả thu được như sau:

Bài kiểm tra Điểm 3DMark FPS
Solar Bay 55.658 211,63
Solar Bay Extreme 11.349 79,37
Port Royal 9.230 42,74
Steel Nomad 3.184 31,84
Speed Way 3.004 30,05

Trong đó, Solar Bay được thực hiện hai lần với kết quả lần lượt 55.529 và 55.658 điểm, cho thấy độ chênh lệch khá nhỏ giữa các lần chạy. Tuy nhiên, cần lưu ý rằng mỗi bài kiểm tra 3DMark sử dụng một khối lượng đồ họa và thang điểm riêng, do đó không thể so sánh trực tiếp điểm số giữa chúng.

Port Royal và Speed Way tập trung vào khả năng xử lý đồ họa có dò tia (ray tracing), trong khi Steel Nomad đặt GPU trước những tác vụ dựng hình nặng. Những kết quả này cho thấy RTX Spark N1X có khả năng đáp ứng nhiều dạng xử lý đồ họa hiện đại, dù mục tiêu chính của nền tảng vẫn là AI.

Dĩ nhiên, benchmark tổng hợp chỉ phản ánh một phần hiệu năng. Để đánh giá sát hơn trải nghiệm thực tế, tôi tiếp tục thử nghiệm ba trò chơi gồm Cyberpunk 2077, Marvel Rivals và Gears of War: E-Day.

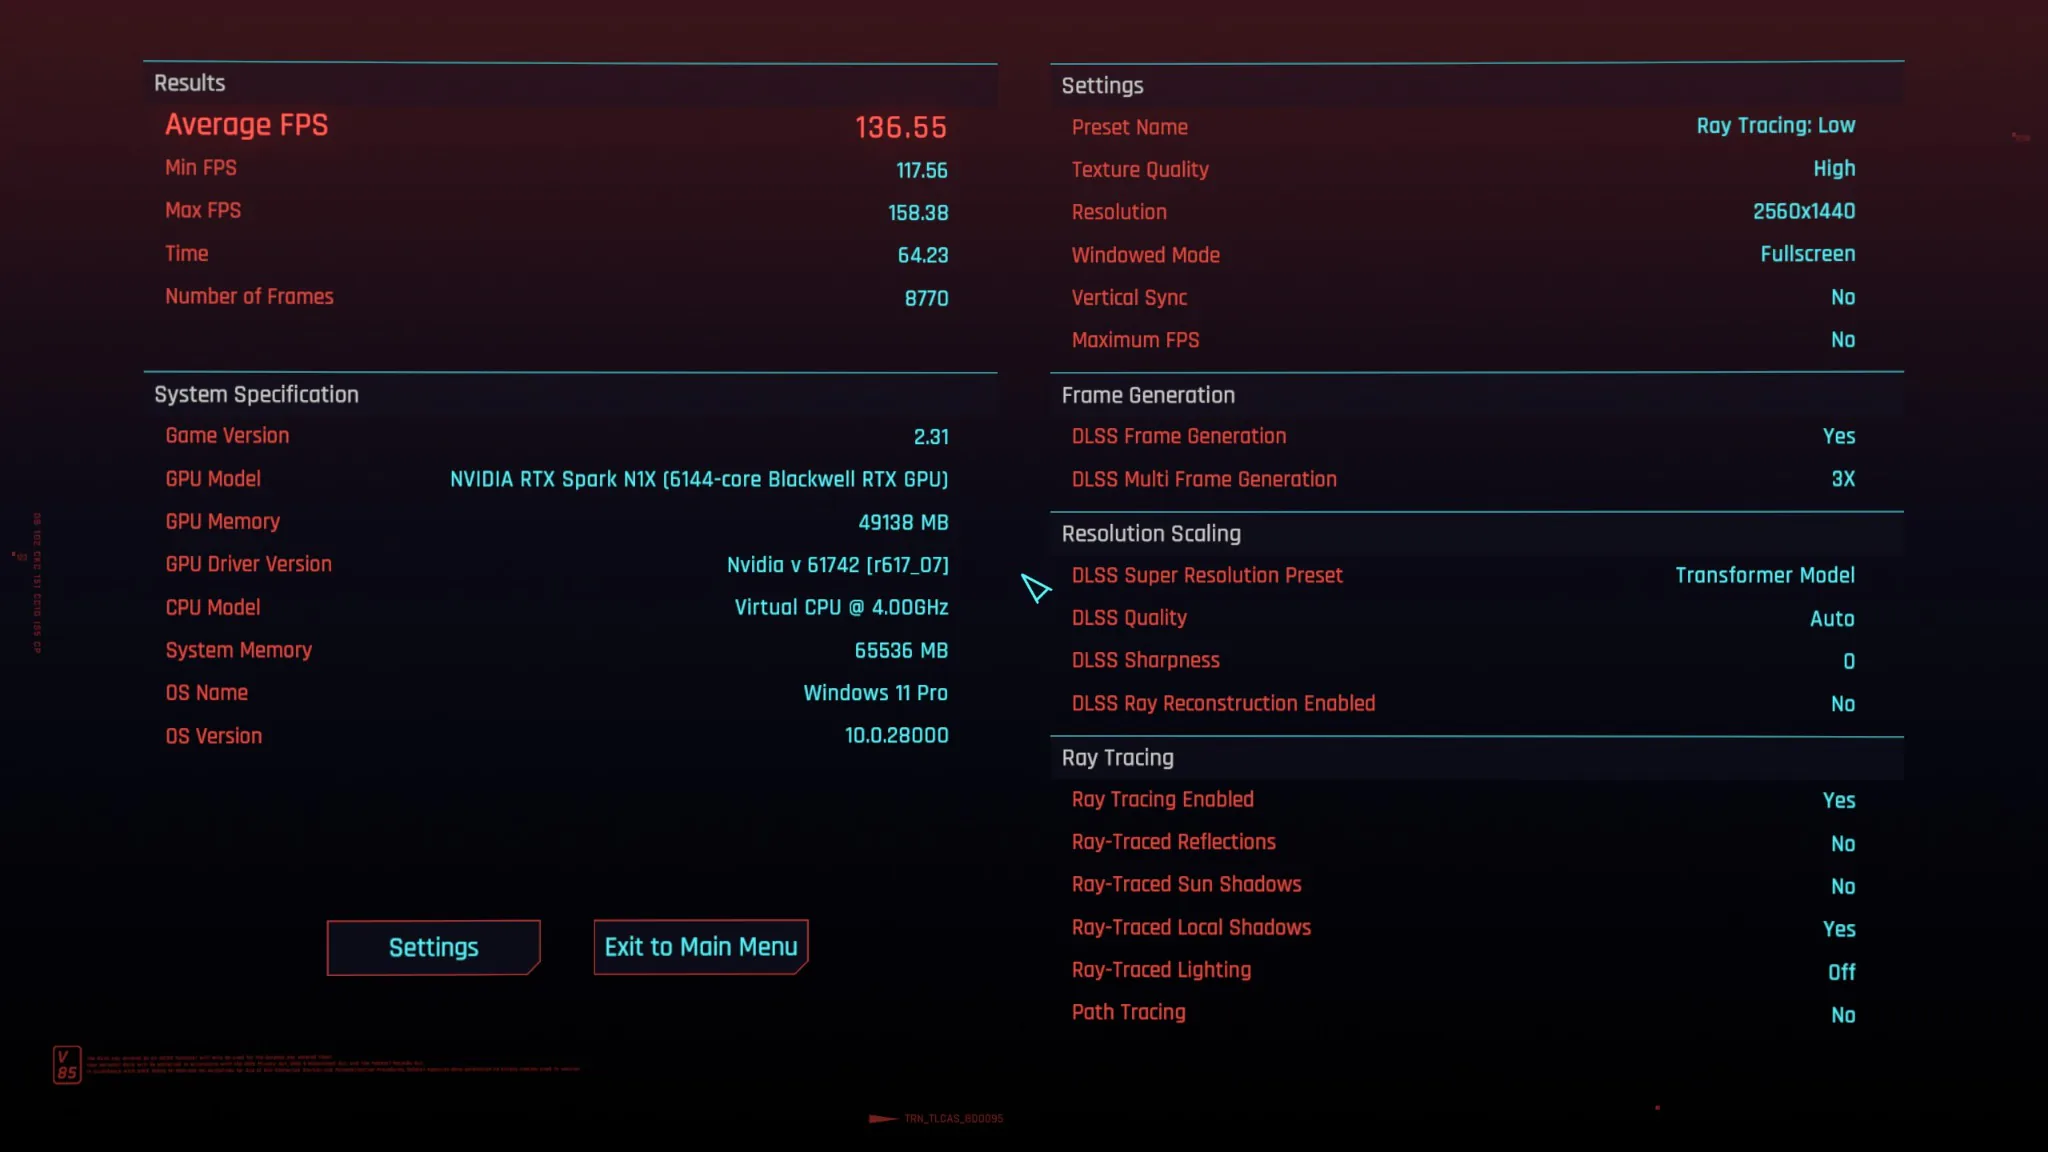
Với Cyberpunk 2077, tôi thiết lập độ phân giải 2560 × 1440 pixel, chất lượng kết cấu High và Ray Tracing Low. NVIDIA DLSS sử dụng mô hình Transformer ở chế độ Quality, kết hợp Multi Frame Generation 3X. Kết quả benchmark đạt trung bình 136,55 FPS, thấp nhất 117,56 FPS và cao nhất 158,38 FPS.
Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 49 Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 50 Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 51 Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 52 Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 53

Đây là mức khung hình khá ấn tượng đối với một chiếc laptop sử dụng bộ nhớ hợp nhất. Tuy nhiên, cần nhấn mạnh rằng kết quả đã bao gồm những khung hình được tạo thêm bằng AI. Vì vậy, 136,55 FPS không đồng nghĩa GPU có thể dựng hình gốc ở tốc độ tương ứng.

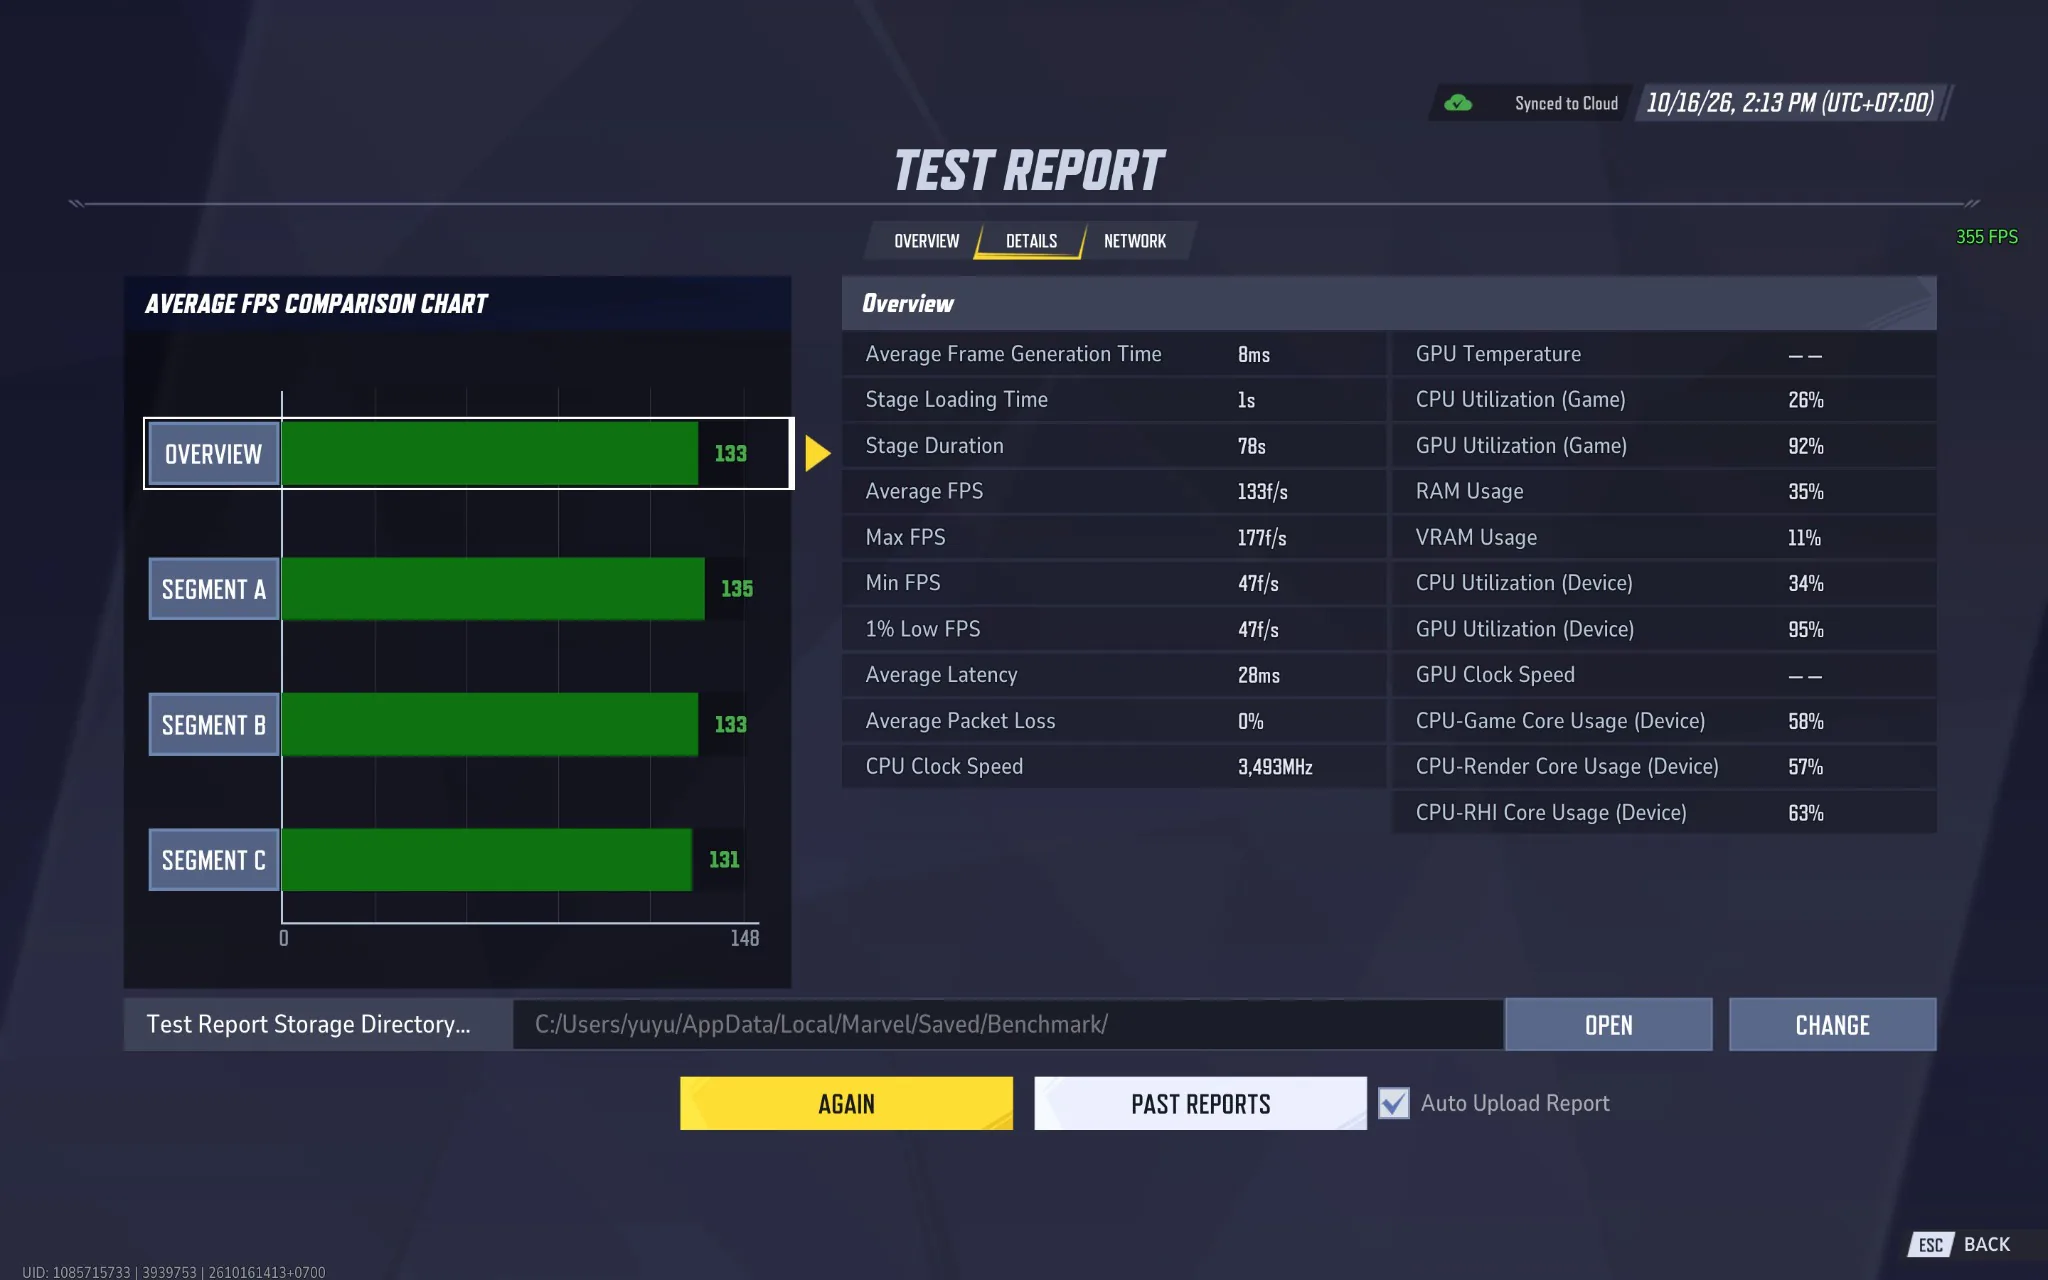
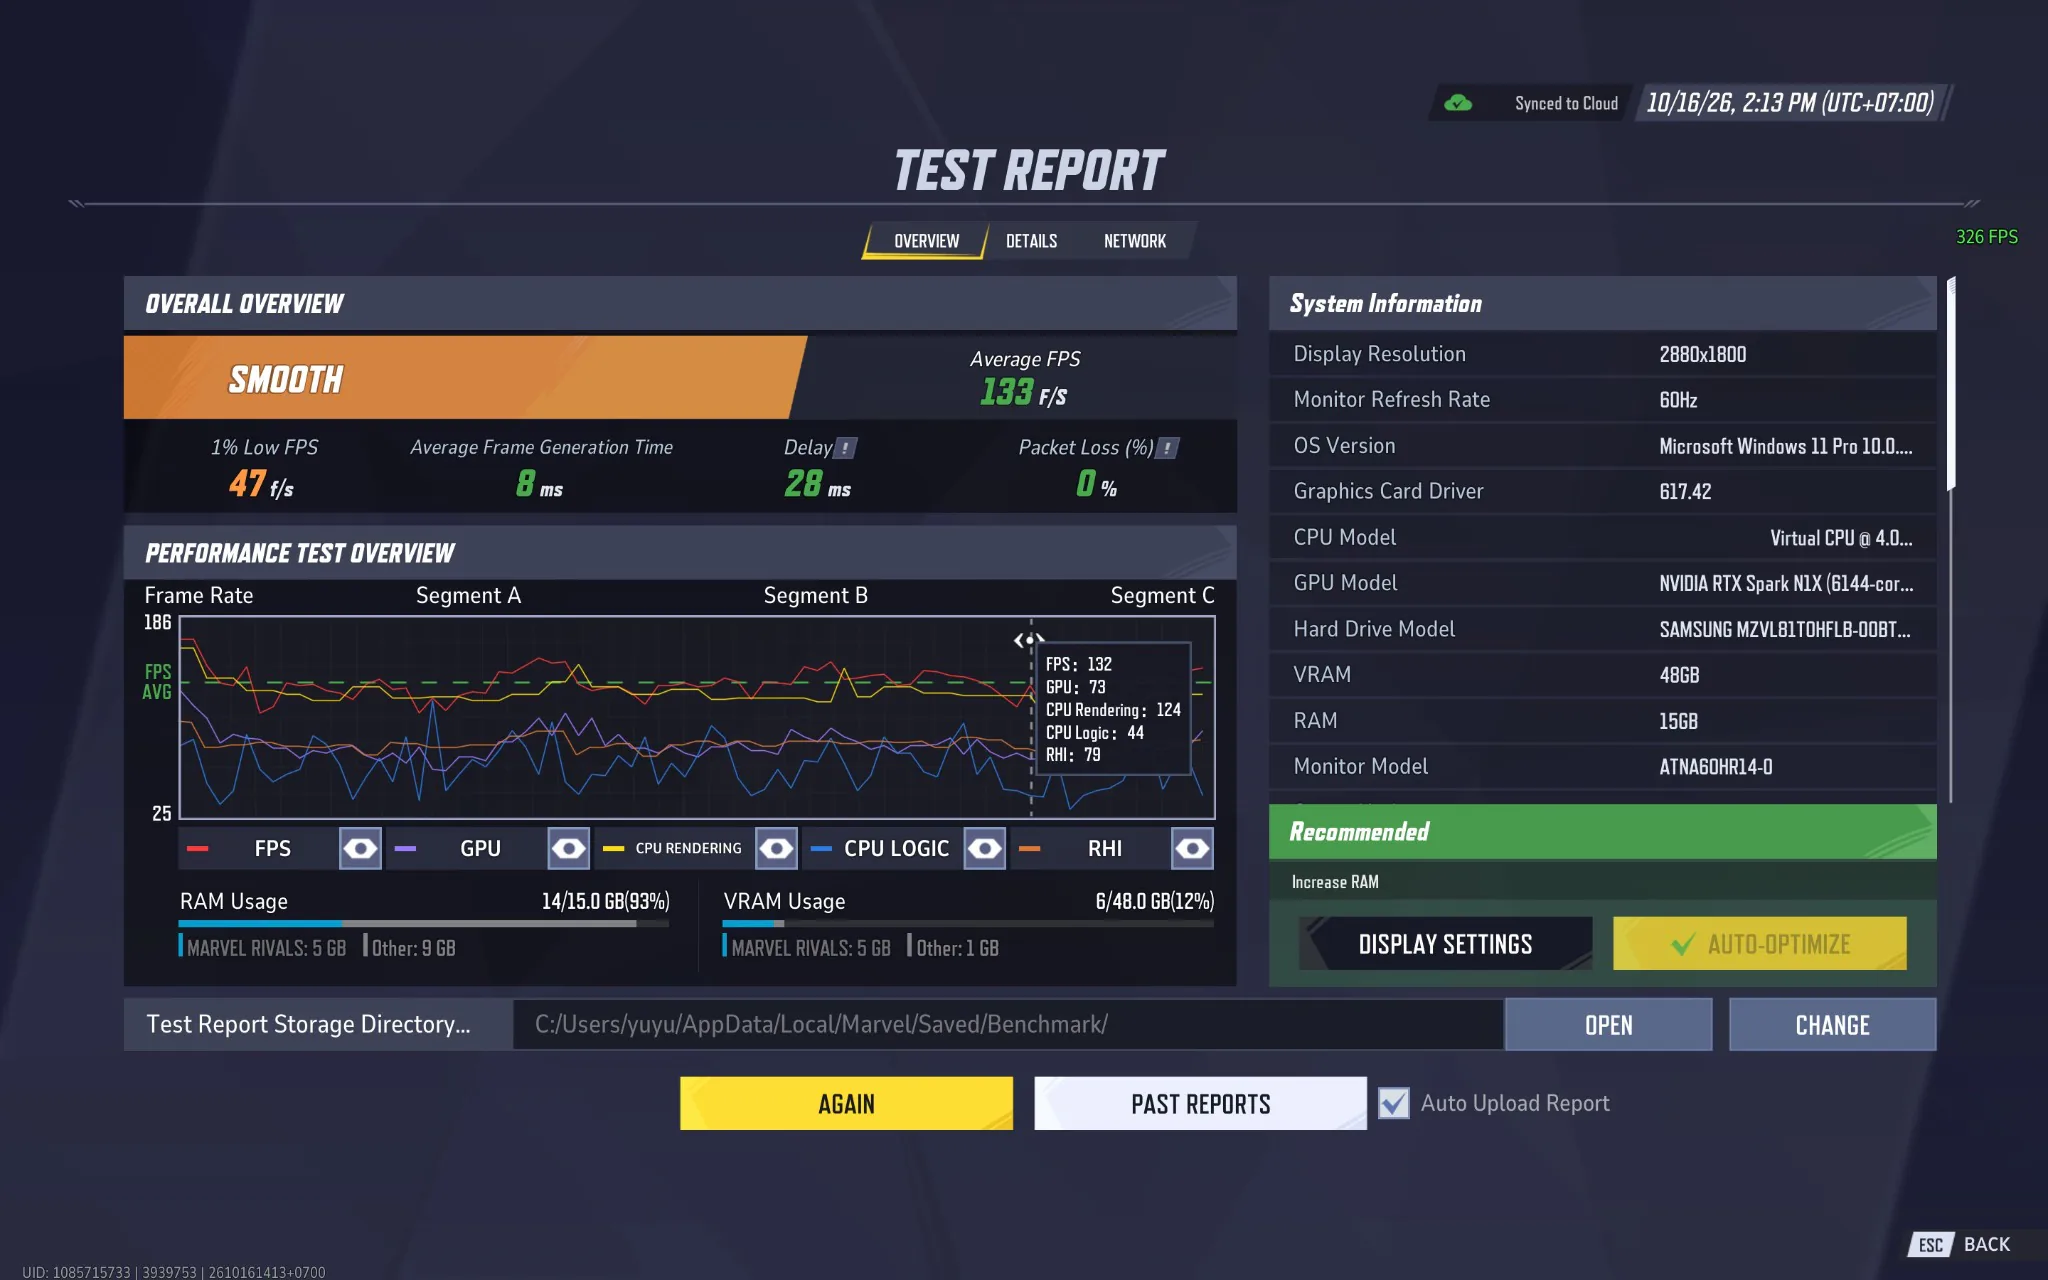
Tôi tiếp tục chuyển sang Marvel Rivals, trò chơi có nhịp độ nhanh và đòi hỏi khả năng phản hồi tốt trong những pha giao tranh đông người. Ở độ phân giải 2880 × 1800 pixel, bài kiểm tra tích hợp ghi nhận tốc độ trung bình 133 FPS, với mức cao nhất 177 FPS.

Điểm đáng chú ý là kết quả của ba phân đoạn khá đồng đều, lần lượt đạt 135, 133 và 131 FPS. Điều này cho thấy tốc độ khung hình trung bình không biến động nhiều giữa các khu vực được thử nghiệm.

Tuy nhiên, chỉ số 1% Low chỉ đạt 47 FPS, thấp hơn đáng kể so với mức trung bình. Đây là chi tiết tôi cho rằng không nên bỏ qua, đặc biệt đối với một trò chơi mang tính cạnh tranh như Marvel Rivals. Tốc độ khung hình trung bình cao có thể mang lại cảm giác mượt mà, nhưng những thời điểm FPS giảm sâu vẫn có khả năng ảnh hưởng đến trải nghiệm điều khiển.

Báo cáo cũng ghi nhận độ trễ trung bình 28 ms và mức sử dụng GPU trong trò chơi khoảng 92%. Điều này cho thấy GPU phải đảm nhận khối lượng xử lý đáng kể trong bài thử. Riêng các thiết lập nâng cấp hình ảnh và tạo khung hình của Marvel Rivals chưa được thể hiện đầy đủ trong ảnh kết quả, nên tôi không sử dụng bài kiểm tra này để so sánh trực tiếp với Cyberpunk 2077.

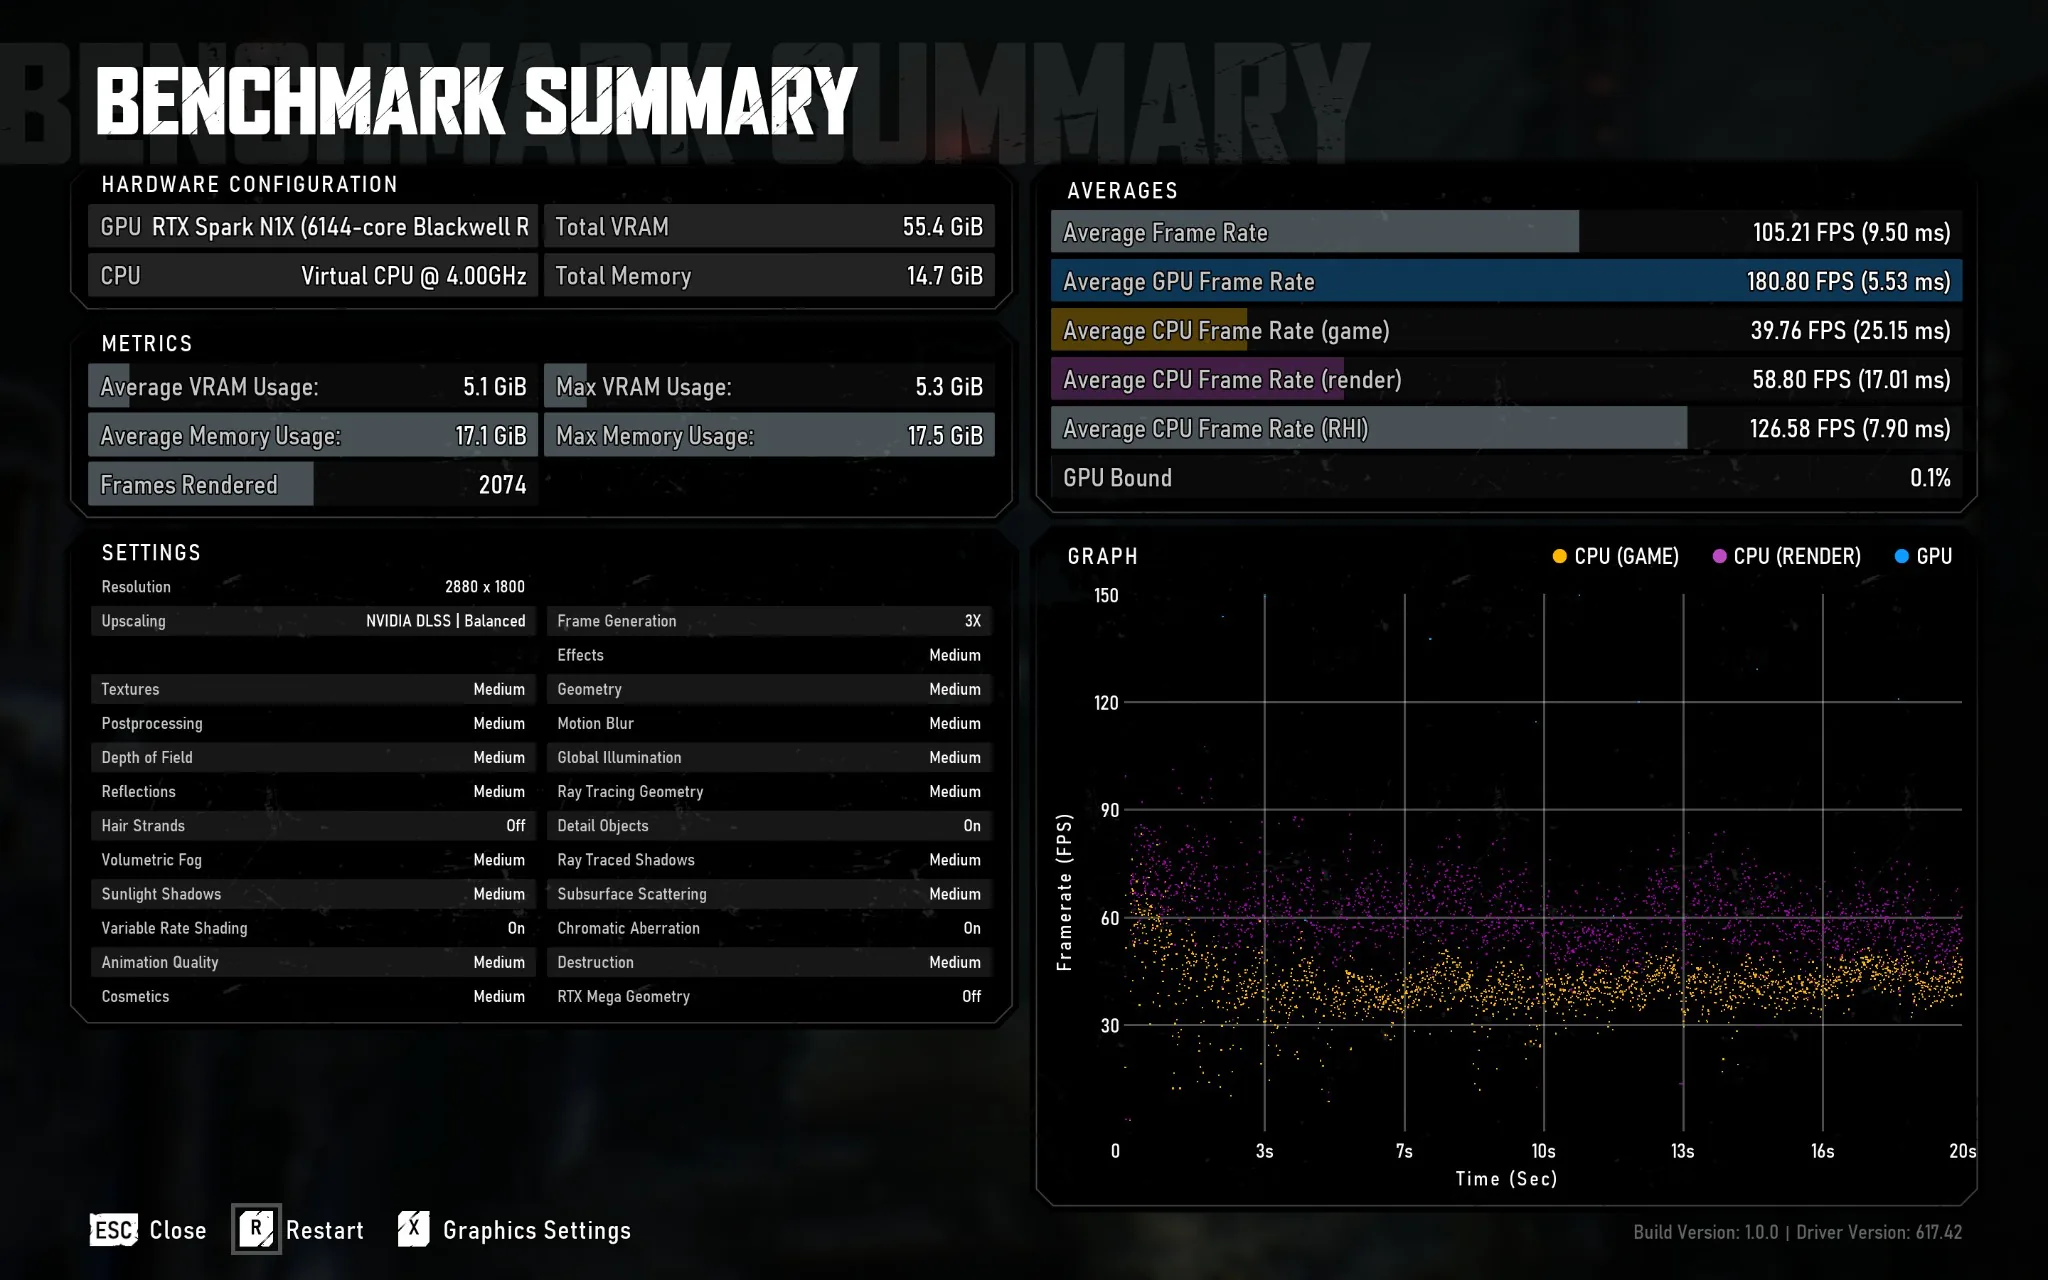
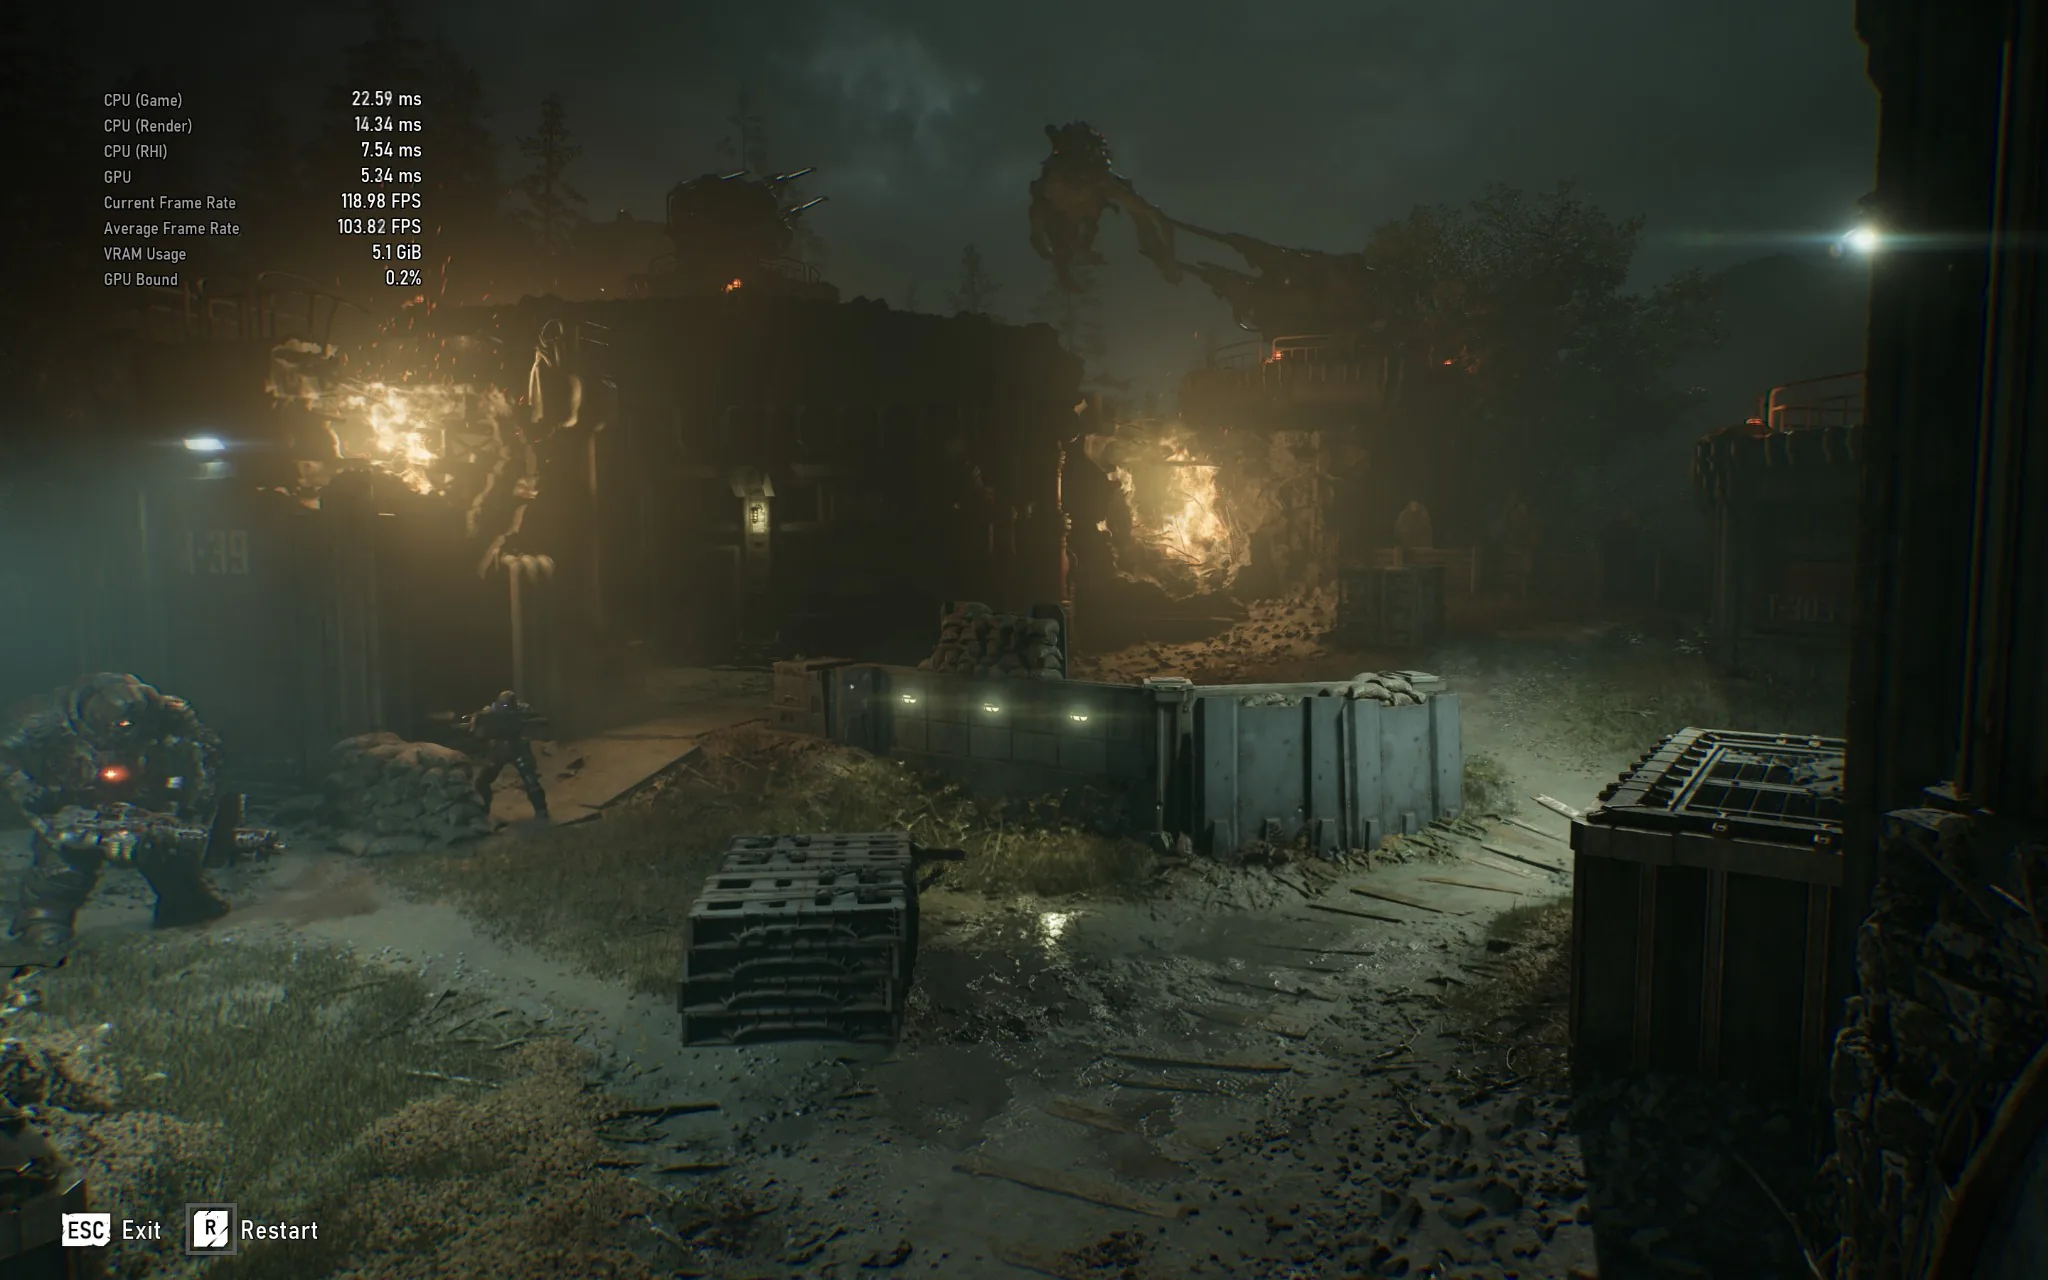
Trò chơi cuối cùng là Gears of War: E-Day, được thử nghiệm ở độ phân giải 2880 × 1800 pixel, NVIDIA DLSS Balanced và Frame Generation 3X. Phần lớn thiết lập đồ họa được đặt ở mức Medium, bao gồm cả một số hiệu ứng dò tia.

Kết quả benchmark ghi nhận tốc độ khung hình trung bình 105,21 FPS. Đây là con số tương đối cao ở độ phân giải gần 3K, nhưng báo cáo chi tiết cho thấy một điểm khá thú vị: tốc độ khung hình phía CPU ở phần game chỉ đạt 39,76 FPS, trong khi chỉ số GPU Frame Rate đạt 180,80 FPS.

Sự chênh lệch này phản ánh đặc điểm của quá trình dựng hình khi công nghệ tạo khung hình được kích hoạt. FPS hiển thị không thể được xem là tốc độ dựng hình gốc, còn các chỉ số của CPU và GPU trong báo cáo thể hiện những công đoạn khác nhau của hệ thống.

Vì vậy, mặc dù kết quả trung bình vượt 100 FPS, không nên mặc định trò chơi sẽ mang lại cảm giác phản hồi tương đương một hệ thống dựng trực tiếp hơn 100 khung hình mỗi giây. Đối với các trò chơi hành động, độ trễ đầu vào và khả năng duy trì tốc độ khung hình ổn định vẫn là những yếu tố quan trọng.

Tổng hợp kết quả ba trò chơi:

Trò chơi Độ phân giải FPS trung bình
Cyberpunk 2077 2560 × 1440 136,55
Marvel Rivals 2880 × 1800 133
Gears of War: E-Day 2880 × 1800 105,21

Các trò chơi được thử nghiệm với những thiết lập khác nhau, vì vậy bảng trên chỉ nhằm tổng hợp kết quả thực tế, không phải bảng xếp hạng hiệu năng giữa các tựa game.

Sau những phép thử, tôi cho rằng khả năng chơi game là một điểm cộng đáng chú ý của RTX Spark N1X. Nền tảng này không được định hướng như một giải pháp chuyên dành cho game thủ, nhưng GPU Blackwell vẫn đủ khả năng xử lý các trò chơi hiện đại ở độ phân giải cao, đặc biệt khi kết hợp với những công nghệ như NVIDIA DLSS.

RTX Spark có thể thay đổi cách sử dụng laptop như thế nào?

Sau những bài thử nghiệm, điều khiến tôi suy nghĩ nhiều nhất là cách AI cục bộ có thể thay đổi mối quan hệ giữa người dùng và máy tính.

Trong mô hình sử dụng AI phổ biến hiện nay, người dùng thường mở một trang web hoặc ứng dụng, gửi yêu cầu đến máy chủ rồi nhận câu trả lời. Mọi thứ tương đối đơn giản, nhưng khả năng kiểm soát mô hình và quy trình xử lý thường bị giới hạn bởi dịch vụ đang sử dụng.

Với AI cục bộ, người dùng có thể chủ động hơn trong việc lựa chọn mô hình, cấu hình hệ thống và kết hợp các công cụ để giải quyết một công việc cụ thể.

Thử nghiệm Hermes là ví dụ rõ ràng nhất. Tôi không cần yêu cầu AI giải thích cách viết phần mềm xử lý ảnh. Thay vào đó, tôi giao một nhiệm vụ và để AI tham gia trực tiếp vào quá trình tạo ra công cụ đáp ứng nhu cầu. Đó là sự khác biệt đáng kể giữa việc sử dụng AI như một công cụ hỏi đáp và sử dụng AI như một trợ lý có khả năng thực hiện công việc.

Tuy nhiên, trải nghiệm cũng cho thấy AI cục bộ chưa phải giải pháp chỉ cần cài đặt là mọi thứ sẽ hoạt động tối ưu.Hiệu năng phụ thuộc nhiều vào mô hình, phương thức suy luận và phần mềm sử dụng. Bài thử AgentPerf cho thấy thay đổi cấu hình có thể rút ngắn thời gian xử lý hơn 30%, dù phần cứng không thay đổi.

Bên cạnh đó, Windows ARM64 đòi hỏi người dùng quan tâm hơn đến khả năng tương thích của những ứng dụng chuyên dụng. Một số công cụ có thể cần phiên bản phù hợp hoặc thêm bước thiết lập trước khi khai thác được GPU. Về phía phần cứng, nhiệt độ và tiếng ồn cũng là những yếu tố không nên bỏ qua. Trải nghiệm trên ASUS ProArt cho thấy khi chạy AI liên tục, hệ thống tản nhiệt phải làm việc với cường độ cao hơn đáng kể so với những tác vụ văn phòng thông thường.

Điều này đặc biệt quan trọng với người dùng muốn sử dụng laptop như một máy trạm AI cá nhân. Khả năng chạy được mô hình lớn là một chuyện, còn duy trì trải nghiệm thoải mái trong nhiều giờ lại là một yêu cầu khác.

Kết luận

Sau thời gian trải nghiệm, tôi cho rằng NVIDIA RTX Spark N1X là một nền tảng đáng chú ý, không chỉ vì cấu hình phần cứng mà còn bởi những khả năng AI cục bộ mà nó mang lại. Bộ nhớ hợp nhất dung lượng lớn giúp laptop tiếp cận những mô hình ngôn ngữ hàng chục tỉ tham số. GPU Blackwell hỗ trợ nhiều công cụ AI và vẫn đáp ứng được những bài kiểm tra đồ họa hiện đại.
Trải nghiệm Nvidia RTX Spark N1X: Khi laptop có thể tự chạy AI và viết phần mềm 54

Nếu chỉ xét những con số benchmark, RTX Spark N1X có thể được nhìn nhận như một nền tảng CPU và GPU mới. Nhưng sau khi trực tiếp sử dụng AI để xây dựng một phần mềm Windows, tôi cho rằng giá trị thú vị hơn nằm ở khả năng biến chiếc laptop thành một môi trường làm việc AI độc lập.

Đó cũng là điều khiến tôi muốn tiếp tục khám phá RTX Spark: không chỉ xem nó xử lý nhanh đến đâu, mà còn tìm hiểu những công việc nào trước đây cần nhiều thao tác thủ công nay có thể được AI thực hiện ngay trên máy.
Google Play trên ô tô chính thức hỗ trợ trình duyệt Firefox, phát YouTube trong nền và hàng loạt tính năng mới

0

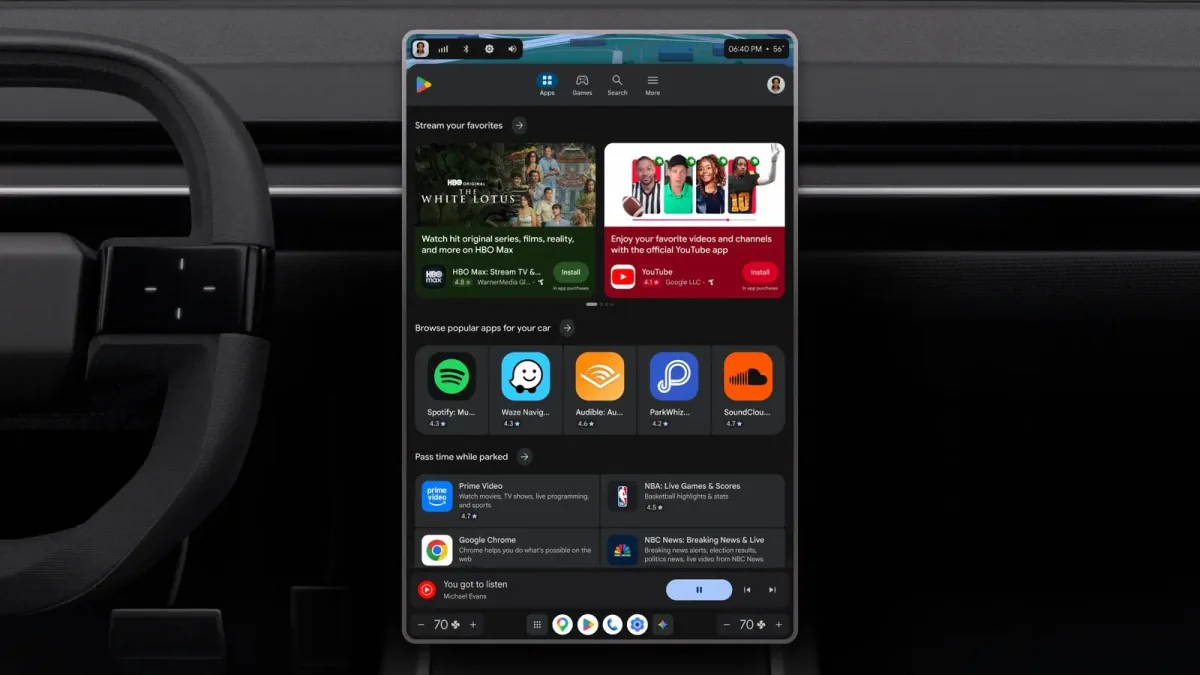
Google vừa tung ra một bản cập nhật lớn nhằm nâng tầm trải nghiệm Android Automotive. Bản cập nhật này mang đến một giao diện được thiết kế lại, đồng thời hỗ trợ thêm các ứng dụng mới như trình duyệt Firefox cùng hàng loạt nền tảng giải trí hấp dẫn.

LƯỚT WEB VÀ GIẢI TRÍ ĐA PHƯƠNG TIỆN NGAY TRÊN XE
Với phiên bản mới, người dùng ô tô có thể lướt web bằng Firefox, bên cạnh các lựa chọn quen thuộc trước đó như Chrome và Vivaldi. Không dừng lại ở đó, bạn cũng có thể xem trực tuyến các chương trình trên hệ thống Starz và JioHotstar, hoặc thậm chí là giải trí nhẹ nhàng với tựa game Ludo King.
Google Play trên ô tô chính thức hỗ trợ trình duyệt Firefox, phát YouTube trong nền và hàng loạt tính năng mới 55
Đương nhiên, những tính năng này chỉ hoạt động khi bạn đang đỗ xe. Liên quan đến vấn đề an toàn, ứng dụng YouTube cũng nhận được một tinh chỉnh cực kỳ thông minh. Cụ thể, ứng dụng sẽ phát video đầy đủ hình ảnh khi xe dừng đỗ, nhưng sẽ tự động chuyển sang chế độ phát trong nền chỉ có âm thanh ngay khi bạn vào số để di chuyển. Tính năng này tỏ ra cực kỳ hoàn hảo cho những video mang hơi hướng podcast hoặc các chương trình talkshow.
TỐI ƯU HÓA TRẢI NGHIỆM TÌM KIẾM ỨNG DỤNG
Đối với các phần mềm trên ô tô, việc phân biệt trạng thái đang đỗ hay đang di chuyển là yếu tố sống còn. Chợ ứng dụng Google Play Store giờ đây sẽ phân loại rõ ràng phần mềm thành từng danh mục cụ thể, bao gồm nhóm ứng dụng dùng khi đỗ xe và nhóm ứng dụng an toàn khi đang lái. Cửa hàng cũng sẽ ưu tiên hiển thị các phần mềm nổi bật, ứng dụng mới cùng nhiều chi tiết hữu ích khác, giúp người dùng dễ dàng làm chủ không gian kỹ thuật số trên xe.
Google Play now has more than 700 car apps
Hiện tại, Google Play Store đã sở hữu hơn 700 ứng dụng dành riêng cho Android Automotive. Cần lưu ý rằng đây là hệ điều hành độc lập được cài đặt trực tiếp trên hệ thống máy tính của xe, hoàn toàn khác biệt với nền tảng Android Auto vốn hoạt động dựa vào kết nối với điện thoại thông minh.
MỞ RỘNG HỆ SINH THÁI VÀ ĐỊNH HƯỚNG TƯƠNG LAI
Để tạo đà phát triển bền vững, Google đã bắt tay với hàng loạt nhà sản xuất ô tô danh tiếng như Mazda, Honda, BYD, Polestar và Volvo, cùng các ông lớn trong ngành truyền thông như Audible, Pandora, SiriusXM, Amazon Music, TuneIn, Gaana và The Post.
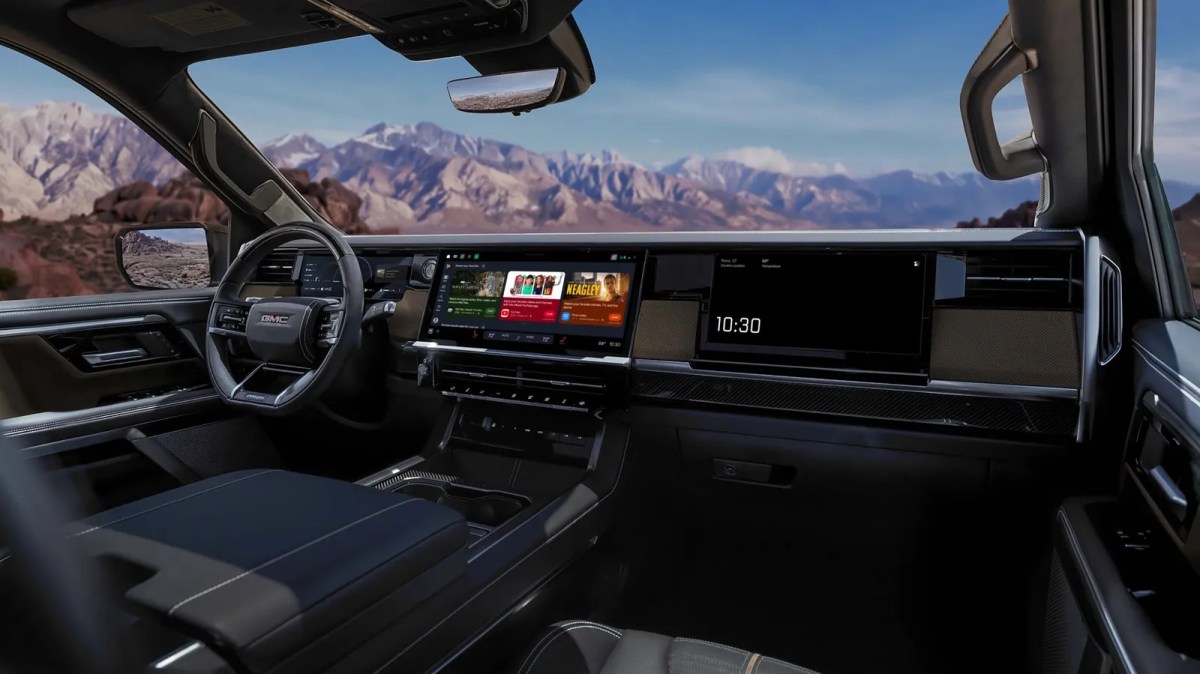
The 2027 GMC Sierra 1500 Denali Ultimate AT4X with Google built-in
Tính đến thời điểm hiện tại, các mẫu xe sở hữu hệ sinh thái Google built-in (một thuật ngữ được Google ưu ái sử dụng hơn nhằm tránh gây nhầm lẫn với Android Auto) đang được sản xuất bởi 16 thương hiệu và trải dài trên hơn 100 dòng xe khác nhau.
Trong số đó phải kể đến GM với thế hệ xe mới năm 2027 bao gồm Chevrolet Silverado 1500 và GMC Sierra 1500. Như nhiều người đã biết, dù GM đã thẳng tay loại bỏ Android Auto trên các mẫu xe đời mới, hãng vẫn tiếp tục đặt niềm tin vào nền tảng cốt lõi Android Automotive.
Một thông tin đáng chú ý khác là vào đầu năm nay, Google đã công bố kế hoạch biến Android Automotive thành một hệ điều hành mã nguồn mở.
Trải nghiệm Google Play hoàn toàn mới trên ô tô sẽ bắt đầu được tung ra trong vài tuần tới và sẽ tiến hành cập nhật tự động trực tiếp trên màn hình hệ thống của xe.
Nguồn: gsmarena

Intel Core 5 205H lần đầu lộ diện điểm số benchmark trên PassMark

0

Bộ vi xử lý Intel Raptor Lake-H không tích hợp iGPU vừa được thử nghiệm hiệu năng trên PassMark, qua đó chứng minh được sức mạnh thực sự của mình.

INTEL CORE 5 205H 8 NHÂN ÁP ĐẢO CORE I5 13420H TRONG CÁC BÀI KIỂM TRA HIỆU NĂNG
Thời gian qua, giới công nghệ không có nhiều thông tin về hai mẫu chip Raptor Lake refresh mới thuộc dòng vi xử lý Core Series 2. Vài tháng trước, Intel đã âm thầm ra mắt Core 7 230H và Core 5 205H, cả hai đều là những phiên bản làm mới của dòng chip Raptor Lake-H dành cho thiết bị di động. Mặc dù nhà sản xuất ấn định thời điểm ra mắt là vào quý 1 năm 2026, nhưng phải đến khi nhà sản xuất MaxSun tích hợp chúng lên các mẫu bo mạch chủ MoDT, người dùng mới thực sự được chiêm ngưỡng những bộ vi xử lý này.
A benchmark results page for the Intel Core 5 205H shows a multithread rating of '19390' and a single-thread rating of '3699', with total cores listed as 8 cores and 12 threads.
Tuy nhiên, giờ đây chúng ta đã có những điểm số benchmark đầu tiên của một trong hai mẫu CPU này. Tài khoản @x86deadandback đã phát hiện ra dữ liệu benchmark của Intel Core 5 205H trên PassMark, một nền tảng phổ biến chuyên dùng để đánh giá và so sánh hiệu năng CPU. Sự xuất hiện của Core 5 205H trên trang web này vài ngày trước đánh dấu màn chào sân chính thức của con chip, đồng thời hé lộ sức mạnh thực sự mà nó sở hữu.
TỐI ƯU HÓA VƯỢT TRỘI MANG LẠI BƯỚC NHẢY VỌT VỀ SỨC MẠNH
Mẫu CPU này sở hữu 8 nhân và 12 luồng, xung nhịp turbo boost lên đến 4.8 GHz cùng mức TDP mặc định là 45W, những thông số đặt nó lên bàn cân trực tiếp với Intel Core i5 13420H. Cả hai vi xử lý đều chia sẻ chung một cấu hình nhân, dải TDP và được sản xuất trên cùng một tiến trình. Điểm khác biệt nằm ở chỗ i5 13420H chỉ đạt xung nhịp turbo ở mức 4.6 GHz, thấp hơn 200 MHz so với người đàn em mới ra mắt. Dù vậy, Core 5 205H cho thấy sự tối ưu hóa vượt trội khi mang lại điểm số single-core cao hơn gần 10% so với i5 13420H.
A comparison table shows specifications and benchmark scores for the Intel Core 5 205H and Intel Core i5-13420H, with the former having a higher CPU Mark of 19390 compared to 16751.
Cụ thể, Core 5 205H ghi nhận 3.699 điểm trong bài kiểm tra single-core trên PassMark, cao hơn khoảng 10.5% so với Core i5 13420H. Khi bước sang bài test multi-core, khoảng cách này còn được nới rộng hơn nữa. Core 5 205H xuất sắc đạt 19.390 điểm so với mức 16.751 điểm của Core i5 13420H, tương đương mức tăng trưởng ấn tượng 15.7%. Hạn chế duy nhất của Core 5 205H là không được trang bị iGPU, nhưng điều này không phải là vấn đề quá lớn bởi hầu hết các nhà sản xuất máy tính đều sẽ ghép nối bộ vi xử lý này với một card đồ họa rời.
Nguồn: wccftech

NVIDIA DLSS 5 hiện chạy nhanh hơn 30%, giảm 20% mức ngốn VRAM

0

NVIDIA vừa chính thức thông báo bản cập nhật DLSS 5 mới nhất sẽ mang đến tốc độ xử lý vượt trội, tiết kiệm tài nguyên hệ thống hơn và chuẩn bị góp mặt trên hàng loạt tựa game mới, trong đó có bom tấn Hogwarts Legacy.

MÔ HÌNH NVIDIA DLSS 5 ĐƯỢC TỐI ƯU HÓA KÍCH THƯỚC GIẢM 24%, TỐC ĐỘ XỬ LÝ TĂNG VỌT
Hôm nay, NVIDIA đã công bố những bản cập nhật lớn dành cho DLSS 5, không chỉ bao gồm một AI model nhanh hơn mà còn mở rộng danh sách game hỗ trợ cũng như tích hợp sâu vào nền tảng RTX Remix.
Theo chia sẻ từ NVIDIA, AI model DLSS 5 phát hành trong tháng này mang lại tốc độ nhanh gấp đôi so với phiên bản từng được hé lộ hồi tháng 3 tại sự kiện GTC 2026. Mặc dù phiên bản ra mắt vào tháng 9 đã có tốc độ rất ấn tượng, nhưng NVIDIA từng ẩn ý rằng họ đang phát triển một model còn nhanh hơn thế, và người dùng hoàn toàn có thể kỳ vọng vào những đợt nâng cấp DLSS 5 liên tục trong thời gian tới.
A line graph titled 'DLSS 5 Model Now Twice as Fast' shows the NVIDIA RTX 50 Series and RTX Spark achieving a 10x performance increase since March, starting at 'Dual RTX 5090.'
Với model mới, NVIDIA đã tinh chỉnh lại hệ thống dữ liệu huấn luyện, cắt giảm 24% số lượng parameters, đưa tổng kích thước model xuống chỉ còn 118 triệu parameters. Nước đi này không chỉ giúp hệ thống chạy mượt mà hơn mà còn giảm thiểu đáng kể mức tiêu thụ tài nguyên. Khi chiến game ở độ phân giải 4K, mức ngốn VRAM của model mới đã giảm tới 20%.
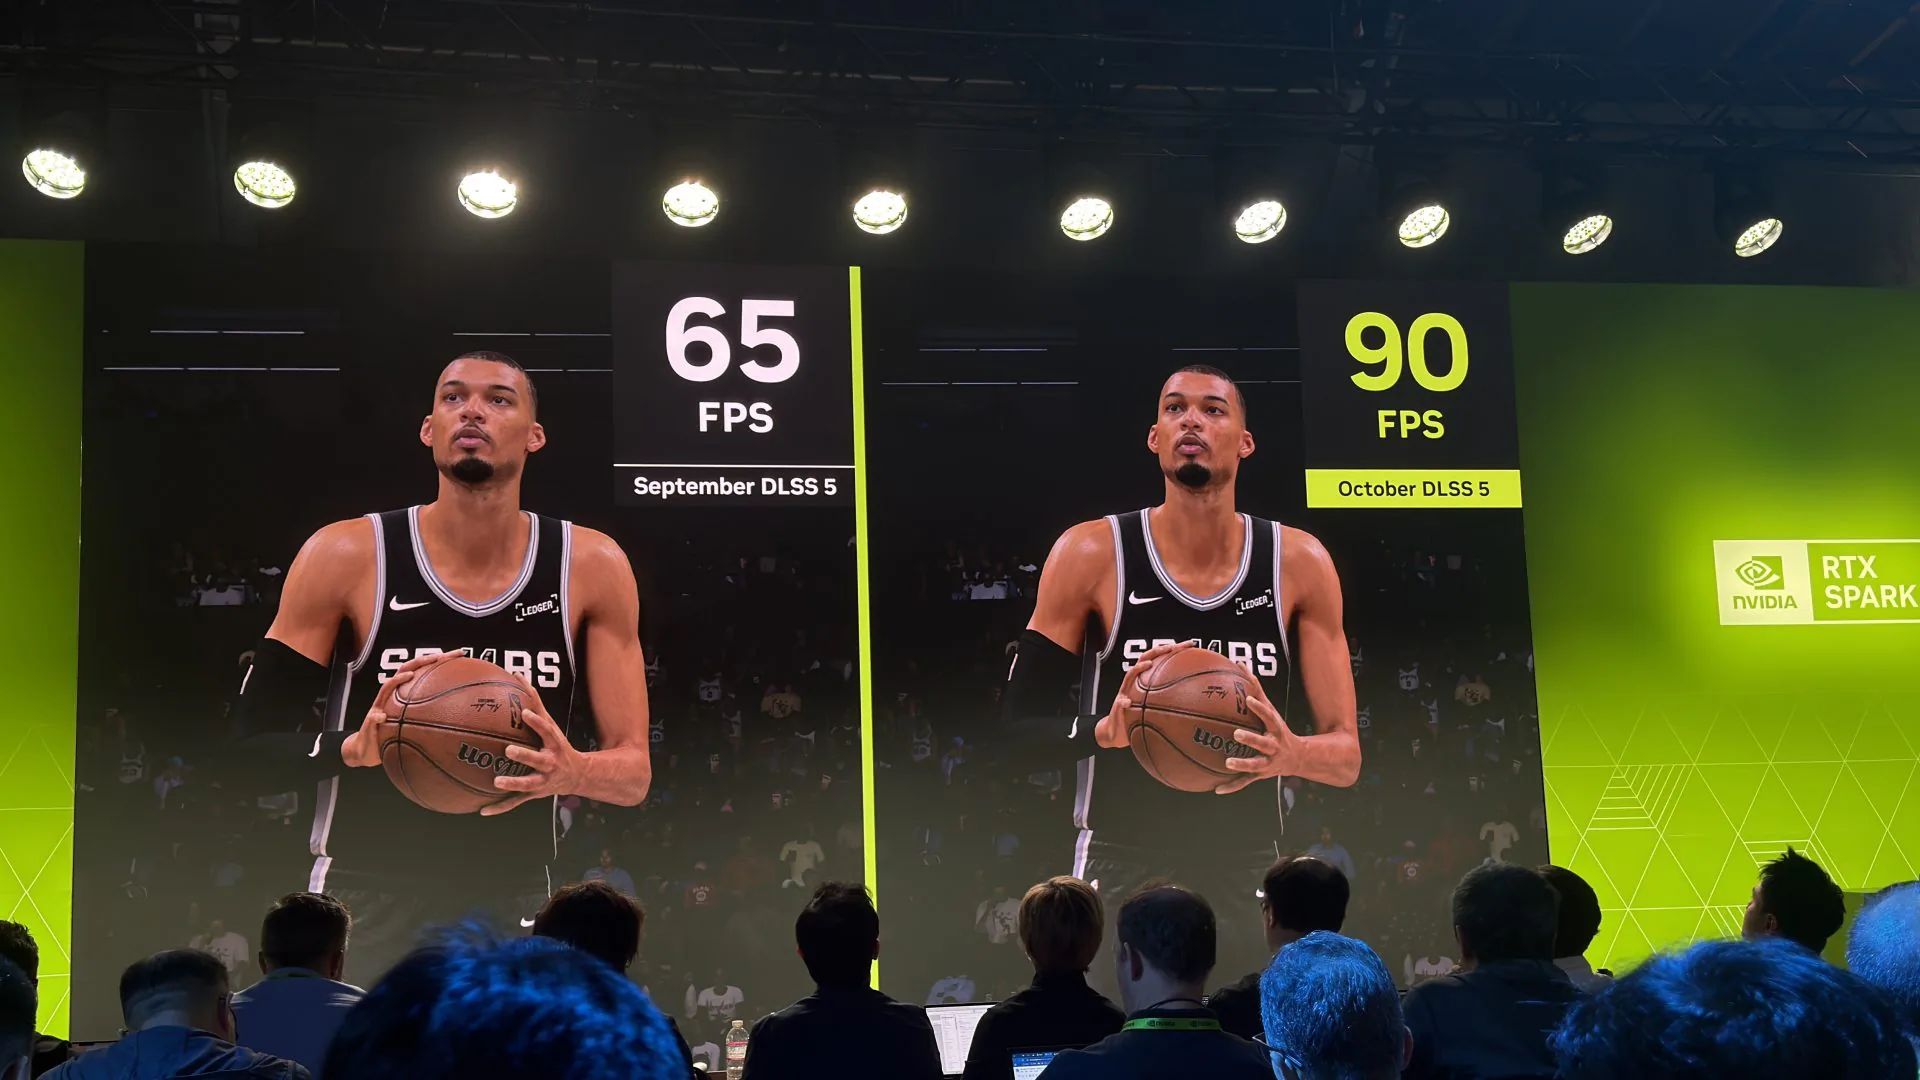
Nhờ đó, các tựa game được tích hợp DLSS 5 như NBA 2K27 hiện có thể chạy nhanh hơn tới 30%, đẩy mức FPS từ 65 FPS lên 90 FPS trong các bài test 4K.
BẢN CẬP NHẬT DLSS 5 THÁNG 10: MỞ RỘNG ĐỘ PHỦ SÓNG SANG HOGWARTS LEGACY VÀ WHERE WINDS MEET
Kể từ thời điểm ra mắt DLSS 5 cùng với tựa game NBA 2K27 vào tháng 9, NVIDIA đã gần như nhân đôi tốc độ thực thi của model DLSS 5. Hãng đạt được thành tựu này nhờ tinh chỉnh dữ liệu huấn luyện và thu gọn 24% kích thước model, đồng thời cắt giảm 20% dung lượng VRAM tiêu thụ ở 4K. Dù mức tăng hiệu năng thực tế sẽ dao động tùy theo từng tựa game, nhưng NBA 2K27 đã ghi nhận mức tăng trưởng hơn 30% so với thời điểm ra mắt ban đầu.

A presenter on stage with a screen showing 'Announcing DLSS 5 for Hogwarts Legacy' and 'Available November 5th,' alongside an image of a character from the game.

Về danh sách hỗ trợ, tính đến nay DLSS 5 mới chỉ chính thức góp mặt trên NBA 2K27 với tư cách là tựa game tiên phong. Mặc dù cộng đồng modder đã nhanh tay đưa DLSS 5 vào vô số tựa game, ứng dụng và các phương tiện truyền thông khác, nhưng phải đến hôm nay NVIDIA mới gọi tên hai siêu phẩm tiếp theo sẽ được hỗ trợ chính chủ.
An NVIDIA presentation slide announces 'DLSS 5 for Where Winds Meet' alongside RTX Spark and GeForce RTX 50 Series, available in late November, with a presenter speaking on stage.
Cái tên đầu tiên chính là Hogwarts Legacy, dự kiến sẽ được cập nhật DLSS 5 vào ngày 5 tháng 11. Theo sau đó là Where Winds Meet với bản cập nhật DLSS 5 chính thức cập bến vào cuối tháng 11.
Trong bản cập nhật sắp tới, công nghệ DLSS Neural Rendering sẽ được bổ sung vào Hogwarts Legacy, cùng với việc nâng cấp toàn bộ các công nghệ DLSS khác lên phiên bản mới nhất. Đội ngũ Avalanche Software đã tận dụng tối đa bộ SDK của DLSS 5 để tinh chỉnh hệ thống, đảm bảo giữ nguyên vẹn phong cách và ý đồ nghệ thuật nguyên bản của trò chơi.
Về phần Where Winds Meet, tựa game này hiện đã hỗ trợ DLSS Multi Frame Generation và Super Resolution. Trong tương lai gần, công nghệ DLSS 3D-Guided Neural Rendering sẽ tiếp tục được bổ sung, hứa hẹn nâng tầm độ chi tiết cho bối cảnh thế giới và các nhân vật trong game. Đây là kết quả từ sự mong mỏi rất lớn của cộng đồng game thủ, đồng thời các nhà phát triển cũng tỏ ra vô cùng ấn tượng trước sự lột xác về mặt hình ảnh mà công nghệ này mang lại.
NVIDIA khẳng định sẽ tiếp tục quá trình tinh chỉnh công nghệ DLSS 5 mới nhất của mình, mở ra tiềm năng cho những cải tiến đột phá hơn nữa trong thời gian tới, đặc biệt là khi hãng đang có kế hoạch đưa công nghệ này lên các dòng card đồ họa RTX 40.
Nguồn: wccftech

Chế độ Frame Generation mới của NVIDIA giúp tăng vọt FPS trên GPU RTX 50 & RTX 40

0

NVIDIA vừa phát hành một AI model Frame Generation mới, nhắm thẳng vào “Performance Mode” nhằm đẩy tốc độ khung hình (FPS) lên mức tối đa cho các dòng card đồ họa RTX 50 và RTX 40.

CHẾ ĐỘ “PERFORMANCE” MỚI GIÚP RTX 50 VÀ RTX 40 TĂNG TỚI 35% FPS
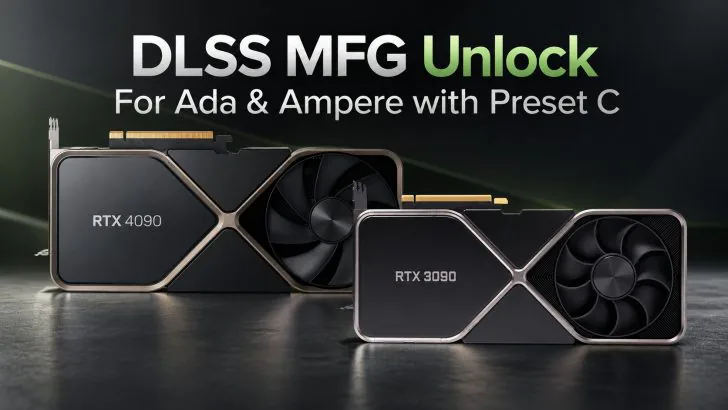
Bên cạnh bản cập nhật DLSS 5, NVIDIA cũng đồng thời tung ra một đợt nâng cấp hoàn toàn mới cho mô hình frame generation của mình. Cụ thể, bản cập nhật này sẽ nhắm đến các chế độ Multi-Frame Generation và Frame Generation “Performance” thông qua việc cung cấp cho người dùng một tùy chọn có tên “Preset C”. Khi kích hoạt preset này, game thủ sẽ chứng kiến mức FPS tăng vọt, lên đến 35% so với chế độ Performance hiện tại.
Chế độ Frame Generation mới của NVIDIA giúp tăng vọt FPS trên GPU RTX 50 & RTX 40 56
Để đạt được con số ấn tượng này, NVIDIA đã tiến hành nâng cấp AI model chuyên đảm nhận tác vụ frame generation. Hiện tại, các công nghệ MFG và frame-gen tiêu chuẩn đang sử dụng song song hai mô hình. Mô hình đầu tiên tận dụng dữ liệu game như motion vectors và depth để đọc hiểu chuyển động của vật thể giữa hai khung hình. Trong khi đó, mô hình thứ hai sẽ tính toán optical flow cho các yếu tố như giao diện người dùng (UI) hoặc các hiệu ứng ray-tracing.
Khi người dùng chọn Preset C từ NVIDIA App, AI model thứ hai sẽ được thay thế bằng một mô hình thế hệ mới, nhẹ hơn và xử lý nhanh hơn. Sự tinh chỉnh này cho phép các ứng dụng hoặc tựa game xuất ra mức FPS cao hơn hẳn so với model gốc trên toàn bộ các chế độ frame-generation, multi-frame generation và dynamic multi-frame generation. Dù sẽ phải đánh đổi một chút xíu về chất lượng hình ảnh, nhưng với những ai luôn khao khát vắt kiệt từng khung hình hiệu năng, đây chắc chắn là một chế độ cực kỳ đáng để trải nghiệm.
Trong biểu đồ hiệu năng của mình, NVIDIA đã sử dụng mẫu GeForce RTX 5060 để làm bài test so sánh giữa chế độ frame gen cũ và mới. Kết quả thu được thực sự rất khả quan, và tin vui là model này sẽ hỗ trợ cho cả hai thế hệ card đồ họa RTX 50 và RTX 40.
HƯỚNG DẪN KÍCH HOẠT PRESET C

frame-generation-moi-cua-nvidia-giup-tang-vot-fps

  • Tải xuống và cài đặt bản cập nhật NVIDIA App mới nhất qua website, hoặc cập nhật trực tiếp ngay trong ứng dụng.
  • Mở ứng dụng, điều hướng tới Settings –> About, đánh dấu tích vào ô “Opt in to access Beta or experimental features” (Tham gia truy cập các tính năng Beta hoặc thử nghiệm).
  • Đợi một lát để tải xuống bản cập nhật beta, sau đó nhấp vào thông báo trên màn hình để tiến hành cài đặt.
  • Sau khi cài đặt xong, hãy mở mục “Graphics” trong bản NVIDIA App beta mới và chọn một tựa game có hỗ trợ Frame Generation, Multi Frame Generation hoặc Dynamic Frame Generation (bạn cũng có thể chọn “Global Settings” ở đầu cửa sổ để áp dụng cho toàn bộ game trong thư viện).
  • Cuộn xuống tìm mục “Driver Settings”.
  • Bấm chọn “DLSS Override – Model Presets”.
  • Bấm chọn “Custom”.
  • Mở menu thả xuống ở phần “Frame Generation” và chọn “Preset C”.
  • Bấm “Apply” để hoàn tất.
Tùy chọn Frame Generation Preset C mới của NVIDIA mang đến một cú hích hiệu năng đầy chào đón với mức tăng FPS lên tới 35% nhờ sử dụng AI model nhẹ và nhanh hơn, đi kèm sự hy sinh không đáng kể về mặt hình ảnh. Khả dụng trên cả hai dòng GPU RTX 50 và RTX 40, đây là một tùy chọn thử nghiệm cực kỳ dễ dàng kích hoạt thông qua NVIDIA App dành cho bất kỳ game thủ nào đang theo đuổi những con số FPS cao ngất ngưởng trong các tựa game được hỗ trợ.
Nguồn: wccftech

Universal MFG Unlocker 1.5.0 mang DLSS Preset C siêu tốc lên GPU RTX 40/30

0

Cộng đồng modder tiếp tục phá vỡ những giới hạn của công nghệ GPU frame generation, và phiên bản mới nhất của Universal MFG Unlocker vừa mang đến những bước tiến cực kỳ thú vị cho những game thủ đang sử dụng các thế hệ card đồ họa cũ.

Nhà phát triển dashdogy đã chính thức tung ra Universal MFG Unlocker v1.5.0. Đây là bản cập nhật lớn của dự án từng được biết đến với tên gọi RTX40MFG-Unlock, mang đến khả năng hỗ trợ DLSS Frame Generation Preset C mới nhất từ NVIDIA, cải thiện độ ổn định cho RTX 30 Series, và thậm chí là kích hoạt Intel XeSS Multi Frame Generation (XeMFG) trên toàn bộ các dòng GPU của NVIDIA, AMD lẫn Intel.
Như các thông tin trước đây, thông qua hàng loạt dự án độc lập, các modder đã thành công trong việc đem DLSS Multi Frame Generation – công nghệ vốn được NVIDIA ưu ái độc quyền cho RTX 50 Series – lên các dòng card cũ hơn như RTX 40, RTX 30 và thậm chí là RTX 20 Series. Bản cập nhật mới nhất của dashdogy tiếp tục là một bước tiến dài, đặc biệt là đối với người dùng kiến trúc Ada Lovelace và Ampere.
MANG ĐẾN DLSS PRESET C VÀ NÂNG TẦM TRẢI NGHIỆM CHO RTX 30 SERIES
Đáng chú ý nhất trong bản cập nhật lần này là việc hỗ trợ DLSS Frame Generation 310.9.16 cùng Preset C mới nhất vừa được NVIDIA giới thiệu. Preset C tập trung tối đa vào hiệu năng bằng cách sử dụng một AI model nhẹ và phản hồi nhanh hơn, giúp đẩy mức FPS lên cao hơn tới 35%, dù sẽ phải đánh đổi một chút về chất lượng hình ảnh.
Universal MFG Unlocker 1.5.0 hiện đã hỗ trợ preset này trên cả RTX 40 và RTX 30 Series, bao gồm các chế độ Multi Frame Generation từ 3x đến 6x ở những tựa game tương thích. Người dùng có thể dễ dàng chọn Preset C trực tiếp thông qua menu của bản mod hoặc tính năng DLSS overrides trong NVIDIA App.
Nhà phát triển cũng khẳng định độ ổn định trên RTX 30 Series đã được cải thiện rõ rệt, với frame pacing mượt mà hơn ở các mức MFG multiplier cao và tương thích tốt với runtime DLSS Frame Generation bản quyền mới nhất từ NVIDIA. Tuy nhiên, khả năng tương thích của RTX 30 với phiên bản 310.9.16 hiện mới chỉ dừng ở mức offline validation chứ chưa trải qua các bài in-game testing thực tế chuyên sâu.
MỞ RỘNG XESS MULTI FRAME GENERATION VÀ HÀNG LOẠT SỬA LỖI QUAN TRỌNG
Một bổ sung đắt giá khác đến từ việc tích hợp OptiScaler 10, cho phép Universal MFG Unlocker hoạt động như một plugin để kích hoạt XeSS Multi Frame Generation ở mức 2x đến 6x trên các card đồ họa NVIDIA, AMD và Intel. Cơ chế này tận dụng multi-frame model của Intel và hoạt động trực tiếp thông qua framework Frame Generation hiện có của OptiScaler.
A game with an on-screen menu from 'MFG Unlocker 1.5.0' shows settings for 'DLSS frame generation' using 'NVIDIA Ada (RTX 40)' with a character standing in a modern office environment.
Bản cập nhật cũng mang đến nhiều nâng cấp khác như tương thích với Streamline runtime mới, sửa lỗi tích hợp Special K, khôi phục lại tính năng của chuột trong tựa game Dying Light: The Beast, và khắc phục tình trạng crash khi khởi động Gears of War: E-Day.
Dù vẫn đang trong giai đoạn thử nghiệm (experimental) và mức độ tương thích có thể thay đổi tùy theo từng tựa game hay cấu hình máy, Universal MFG Unlocker 1.5.0 vẫn là một minh chứng ấn tượng cho thấy cộng đồng mạng đã tiến xa đến mức nào trong việc phổ cập các công nghệ frame generation hiện đại lên những phần cứng không được hỗ trợ chính thức.
The image displays text describing Universal MFG Unlocker V1.5.0, highlighting DLSS and XeSS Multi Frame Generation controls for RTX 40/30 series GPUs and others, with a mention of OptiScaler.
Game thủ hiện đã có thể tải xuống phiên bản 1.5.0 mới nhất này từ trang GitHub Releases của dự án.
Nguồn: wccftech

NVIDIA RTX Spark ra mắt 16/10: hỗ trợ hàng trăm game và anti-cheat

0

NVIDIA RTX Spark chính thức ra mắt ngày 16/10 với chip N1X, mang đến hàng trăm game, đầy đủ công nghệ DLSS và hỗ trợ các hệ thống anti-cheat lớn ngay từ ngày đầu.

NVIDIA chuẩn bị tung ra nền tảng PC mới mang tên RTX Spark vào ngày 16 tháng 10, sử dụng hai phiên bản chip N1X kết hợp GPU Blackwell RTX và CPU Grace. Nền tảng này nhắm tới cả laptop và máy tính để bàn nhỏ gọn, hứa hẹn mang lại trải nghiệm Windows on Arm mạnh mẽ nhất từ trước đến nay dành cho người chơi game.

Theo NVIDIA, RTX Spark sẽ hỗ trợ toàn bộ công nghệ RTX ngay từ ngày đầu tiên, bao gồm DLSS, Reflex, G-SYNC, ray tracing và RTX Remix. Hãng cho biết đã phối hợp chặt chẽ với các nhà phát triển, nhà phát hành và đơn vị cung cấp anti-cheat để đảm bảo người chơi có thể tham gia game trực tuyến song song với các nền tảng khác.

NVIDIA RTX Spark ra mắt 16/10: hỗ trợ hàng trăm game và anti-cheat 57

Đầy đủ bộ công nghệ DLSS mới nhất, kể cả DLSS 5

RTX Spark sẽ chạy toàn bộ dải công nghệ DLSS hiện có trên GeForce, gồm DLSS Super Resolution (bản DLSS 4.5 trở lên), DLSS Frame Generation (tăng khung hình tối đa 6 lần nhờ Dynamic MFG) và DLSS 4.5 Ray Reconstruction. Đáng chú ý, nền tảng này còn hỗ trợ DLSS 5, công nghệ mới nhất của NVIDIA, ngay trong ngày ra mắt với tựa game NBA 2K27.

Super Resolution dùng AI tái tạo hình ảnh độ phân giải cao từ dữ liệu khung hình thấp hơn, kết hợp thông tin từ khung hình hiện tại, vector chuyển động và các khung hình trước để giữ chi tiết ổn định. Frame Generation tạo thêm khung hình bằng AI giữa các khung hình do game render, trong khi Multi Frame Generation có thể tạo nhiều khung hình bổ sung cùng lúc, tận dụng tốt các màn hình tần số quét cao. Nhân Tensor thế hệ 5 của kiến trúc Blackwell đảm nhiệm xử lý các mô hình AI này, kết hợp cùng NVIDIA Reflex để giảm độ trễ.

Ray Reconstruction thay thế các bộ khử nhiễu thủ công bằng mạng AI được huấn luyện trên siêu máy tính của NVIDIA, giúp cải thiện chất lượng hình ảnh trong các cảnh dò tia và path tracing. Riêng DLSS 5 bổ sung công nghệ 3D-Guided Neural Rendering, cho phép tái hiện ánh sáng và vật liệu chân thực hơn mà vẫn giữ nguyên cấu trúc cảnh và nhận diện nhân vật, hoạt động được với cả game dựng hình rasterization, ray tracing lẫn path tracing.

Hỗ trợ hàng trăm game và loạt hệ thống anti-cheat lớn

NVIDIA công bố danh sách game hỗ trợ ngày ra mắt lên tới hàng trăm tựa, trong đó có Cyberpunk 2077, Doom: The Dark Ages, Control Resonant, The Witcher III Remastered, Gears of War E-Day, BeamNG Drive và Arc Raiders.

Về mảng game nhiều người chơi, RTX Spark sẽ hỗ trợ ngay từ ngày 16/10 các tựa game như ARC Raiders, Arknights: Endfield, Counter-Strike 2, Dota 2, Fortnite, Marvel Rivals, NARAKA: BLADEPOINT, Rocket League, RUST, THE FINALS, War Thunder, World of Tanks, World of Warships và Wuthering Waves, đi kèm bảo vệ anti-cheat tương ứng.

Các hệ thống anti-cheat có mặt ngay khi ra mắt gồm Anybrain (ARC Raiders, THE FINALS), BattlEye (Rainbow Six Siege, DayZ, War Thunder), Denuvo Anti-Cheat, Easy Anti-Cheat của Epic Games (Fortnite, Rocket League, Rust, Elden Ring), VAC của Valve (Counter-Strike 2, DOTA 2, Left 4 Dead 2), cùng các hệ thống riêng của NetEase, Nexon, HoYoverse và Roblox/Byfron.

NVIDIA cho biết sẽ tiếp tục bổ sung thêm các hệ thống anti-cheat lớn sau ngày ra mắt, bao gồm RICOCHET của Activision (Call of Duty), Vanguard của Riot Games (VALORANT, League of Legends), EA Javelin, ACE của Tencent (Delta Force, Wuthering Waves, Arknights: Endfield) và Zakynthos của Krafton cho PUBG: BATTLEGROUNDS.

Mở rộng sang công cụ AI và phần mềm sáng tạo

Bên cạnh game, NVIDIA cũng công bố loạt cập nhật cho hệ sinh thái phần mềm AI và sáng tạo trên RTX Spark. Mô hình Nemotron 3.5 Bolt 74B dành cho AI agent sẽ phát hành ngày 15/10, trong khi NVIDIA PAIR chính thức rời bản beta và bổ sung hỗ trợ llama.cpp. Các ứng dụng agent phổ biến như GitHub Copilot, Perplexity và Pi cũng được tối ưu hóa để chạy trên nền tảng này.

Về phần mềm sáng tạo nội dung, NVIDIA và Adobe hợp tác tái cấu trúc Photoshop và Premiere để tận dụng tăng tốc GPU, hứa hẹn hiệu năng gấp đôi trong thời gian tới. NVIDIA Broadcast 2.3 bổ sung tính năng Video Super Resolution và Video Frame Generation, còn Blender 5.3 ra mắt tháng 11 sẽ tích hợp DLSS Ray Reconstruction để cải thiện tương tác trong viewport.

Một mô hình DLSS 5 nhanh hơn gấp đôi sẽ ra mắt đúng ngày 16/10, cùng chế độ Performance Mode mới cho DLSS Frame Generation đã có mặt trong bản beta của NVIDIA App. Mô hình ngôn ngữ nhỏ Nemotron 3.5 Bolt E4B dành cho nhân vật game AI theo chuẩn NVIDIA ACE sẽ phát hành ngày 23/10, cùng thời điểm với bản cập nhật RTX Remix hỗ trợ DLSS 5.