Ngày 18.3.2025, tại hội nghị GTC, NVIDIA đã giới thiệu Dynamo, một thư viện phần mềm suy luận (inference software) mã nguồn mở (open-source) nhằm tăng tốc và mở rộng mô hình suy luận trí tuệ nhân tạo (AI reasoning models) trong các nhà máy AI.
Được thiết kế để vận hành hiệu quả trên hàng nghìn GPU, Dynamo tối ưu hóa chi phí và nâng cao doanh thu từ token cho các nhà cung cấp dịch vụ AI. Đây là phiên bản kế thừa của NVIDIA Triton Inference Server, tập trung vào việc quản lý và đẩy nhanh giao tiếp suy luận trên quy mô lớn.

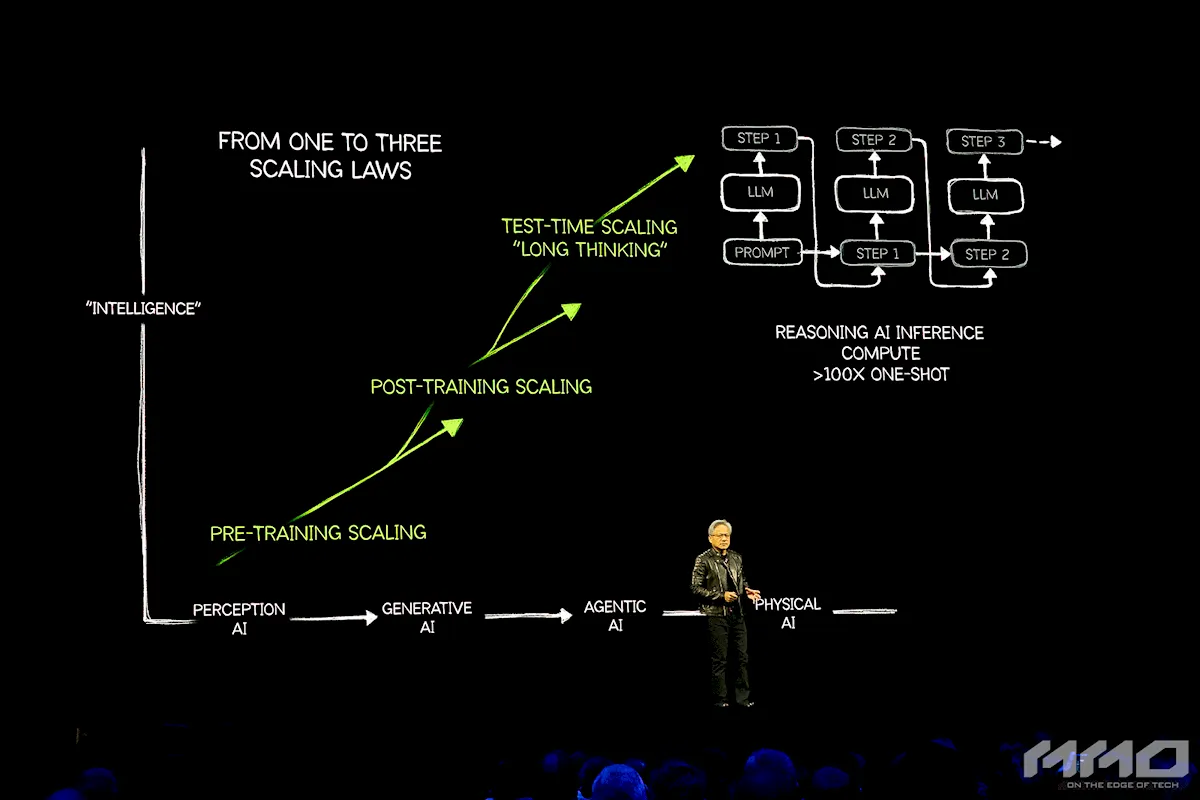
Việc xử lý hàng chục nghìn token cho mỗi lệnh (prompt) đang trở thành xu hướng chính trong suy luận AI. Dynamo cải thiện hiệu suất suy luận, giảm chi phí vận hành, giúp các nhà máy AI phục vụ mô hình ngôn ngữ lớn (LLMs) hiệu quả hơn. Phần mềm này sử dụng phương pháp phục vụ phân tách (disaggregated serving), chia giai đoạn xử lý và tạo nội dung của LLM cho các GPU khác nhau.
Điều này cho phép tối ưu riêng từng giai đoạn, tăng cường sử dụng tài nguyên GPU. Jensen Huang, CEO NVIDIA, cho biết Dynamo hỗ trợ triển khai mô hình AI tùy chỉnh trên quy mô lớn, tiết kiệm chi phí cho các nhà máy AI.
Trên nền tảng Hopper hiện tại, Dynamo tăng gấp đôi hiệu suất và doanh thu khi phục vụ mô hình Llama với cùng số GPU. Với DeepSeek-R1 trên cụm GB200 NVL72, tối ưu hóa thông minh của Dynamo tăng số token tạo ra hơn 30 lần mỗi GPU. Để đạt kết quả này, phần mềm tích hợp các tính năng như thêm hoặc bớt GPU linh hoạt theo lưu lượng yêu cầu, định tuyến truy vấn đến GPU phù hợp, giảm tính toán lặp lại, đồng thời chuyển dữ liệu suy luận sang bộ nhớ và thiết bị lưu trữ rẻ hơn khi cần, đảm bảo chi phí thấp.

Dynamo hỗ trợ PyTorch, SGLang, TensorRT-LLM và vLLM, mở cửa cho doanh nghiệp, startup và nhà nghiên cứu tối ưu phục vụ AI. Nhiều công ty như AWS, Google Cloud, Microsoft Azure, Meta và Perplexity dự kiến áp dụng. Denis Yarats từ Perplexity AI cho biết Dynamo sẽ tăng hiệu quả phục vụ hàng trăm triệu yêu cầu mỗi tháng. Cohere cũng lên kế hoạch dùng Dynamo để hỗ trợ khả năng agentic AI trong dòng Command, cải thiện phối hợp đa GPU và giao tiếp thấp độ trễ.
Together AI dự định tích hợp Dynamo với Together Inference Engine để mở rộng tải suy luận, giải quyết tắc nghẽn lưu lượng. Ce Zhang từ Together AI nhận định sự linh hoạt của Dynamo giúp tối ưu tài nguyên, tăng hiệu suất phục vụ mô hình mã nguồn mở. Phần mềm bao gồm bốn cải tiến chính: GPU Planner điều chỉnh GPU theo nhu cầu, Smart Router định tuyến thông minh, thư viện giao tiếp thấp độ trễ (Low-Latency Communication Library) và Memory Manager quản lý bộ nhớ hiệu quả.
Dynamo tận dụng bộ nhớ đệm KV (KV cache) để định tuyến yêu cầu mới tới GPU có dữ liệu phù hợp, tránh tính toán dư thừa. Với mô hình như NVIDIA Llama Nemotron, phương pháp phân tách tăng tốc độ phản hồi và thông lượng (throughput). Phần mềm sẽ có trong NVIDIA NIM microservices và được hỗ trợ bởi NVIDIA AI Enterprise trong tương lai, đảm bảo bảo mật và ổn định cấp sản xuất.
Các nhà máy AI ngày càng phụ thuộc vào suy luận quy mô lớn, và Dynamo đáp ứng nhu cầu này bằng cách giảm chi phí và tăng hiệu quả. NVIDIA khuyến khích tìm hiểu thêm qua bài phát biểu GTC, blog Dynamo và các phiên thảo luận tại sự kiện đến ngày 21/3. Tuy nhiên, việc triển khai đòi hỏi hạ tầng GPU mạnh và khả năng thích nghi từ nhà cung cấp dịch vụ.