Các nhà khoa học dùng NVIDIA NIM microservices và LLM để rút ngắn thời gian phân tích tài liệu, mở ra hướng đi mới cho nghiên cứu.
Việc thực hiện một bài đánh giá hệ thống đóng vai trò quan trọng trong nghiên cứu khoa học. Đối với người mới, nó cung cấp cái nhìn tổng quan có cấu trúc về lĩnh vực. Với chuyên gia, nó giúp làm rõ hiểu biết và khơi gợi ý tưởng. Theo số liệu từ Web of Science, năm 2024 ghi nhận 218.650 bài đánh giá được lập chỉ mục, cho thấy tầm quan trọng của tài liệu này. Tuy nhiên, quá trình truyền thống đòi hỏi thu thập, đọc và tóm tắt hàng loạt bài báo khoa học, thường mất nhiều thời gian và giới hạn phạm vi phân tích ở vài chục đến vài trăm bài. Nội dung liên ngành, ngoài chuyên môn của nhà nghiên cứu, càng làm tăng độ phức tạp.
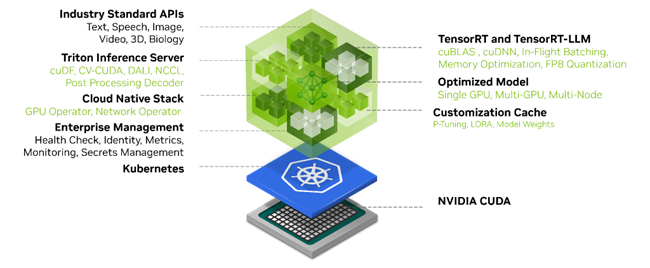
Những thách thức này khiến việc tạo ra bài đánh giá toàn diện, đáng tin cậy trở nên khó khăn. Sự xuất hiện của các mô hình ngôn ngữ lớn (LLM) mang đến giải pháp đột phá, cho phép trích xuất và tổng hợp thông tin nhanh chóng từ khối lượng tài liệu lớn. Tại Generative AI Codefest Australia, các nhà khoa học đã tận dụng sự hỗ trợ từ chuyên gia NVIDIA AI để thử nghiệm NVIDIA NIM microservices, đẩy nhanh quá trình đánh giá tài liệu. Công cụ này giúp kiểm tra và tinh chỉnh nhiều LLM tiên tiến cho việc phân tích.
Nhóm nghiên cứu từ ARC Special Research Initiative Securing Antarctica’s Environmental Future (SAEF), chuyên về sinh lý học sinh thái, đã thử nghiệm LLM để xem xét phản ứng toàn cầu của thực vật không mạch như rêu và địa y với gió. Thách thức nằm ở chỗ nhiều bài báo liên quan không đề cập từ khóa chính trong tiêu đề hay tóm tắt, đòi hỏi phải đọc toàn văn – một quá trình tốn kém thời gian. Họ triển khai ứng dụng Q&A đơn giản dựa trên LlaMa 3.1 8B Instruct NIM microservice, tạo nguyên mẫu ban đầu để trích xuất thông tin liên quan đến tương tác gió-thực vật.

Nguyên mẫu đầu tiên xử lý bài báo tuần tự, hỗ trợ tối ưu hóa câu hỏi để rút ra dữ liệu chính. Sau khi xác nhận độ chính xác qua kiểm tra thủ công và không phát hiện lỗi lớn, nhóm nhận thấy tiềm năng nâng cao hiệu quả. Họ chuyển đổi tài liệu PDF sang định dạng JSON có cấu trúc, trích xuất hình ảnh, bảng biểu, và xử lý song song để tăng tốc độ. Bằng cách dùng NVIDIA NIM và nv-ingest, nhóm triển khai LLM cùng đường dẫn dữ liệu trên hệ thống tám GPU NVIDIA A100 80GB, tinh chỉnh mô hình bằng phương pháp low-rank adaptation (LoRA) để cải thiện độ chính xác.
Họ thu thập hơn 2.000 bài báo từ Web of Science và Scopus liên quan đến lĩnh vực nghiên cứu. Trong một tuần tại Codefest, nhóm thử nghiệm nhiều chiến lược tối ưu hóa hiệu quả và độ chính xác của việc trích xuất thông tin. Sau khi kiểm tra các LLM từ NVIDIA API Catalog trên tập bài báo ngẫu nhiên, Llama-3.1-8B-instruct được chọn là mô hình hoạt động tốt nhất dựa trên độ chính xác và tính toàn diện.
Để tăng tốc độ xử lý, nhóm phát triển mô-đun Q&A bằng streamlit cho các câu hỏi nghiên cứu cụ thể, áp dụng xử lý song song và KV-caching, tăng tốc độ tính toán gấp 6 lần với 16 luồng. Sử dụng nv-ingest, họ trích xuất văn bản, hình ảnh, bảng biểu từ PDF sang JSON, giảm thời gian xử lý thêm 4,25 lần. Kết quả, quá trình trích xuất thông tin từ cơ sở dữ liệu được rút ngắn 25,25 lần so với ban đầu, chỉ mất dưới 30 phút cho toàn bộ dữ liệu với hai GPU A100 và 16 luồng. So với phương pháp thủ công mất khoảng một giờ mỗi bài, cách làm này tiết kiệm hơn 99% thời gian.

Ngoài trích xuất, nhóm còn thử nghiệm phân loại bài báo tự động. Bằng cách tinh chỉnh Llama-3.1-8B-instruct với LoRA trên mẫu bài báo chú thích thủ công, họ đạt tốc độ phân loại 2 giây mỗi bài, nhanh hơn nhiều so với 300 giây trung bình khi làm tay. Hiện tại, nhóm đang cải tiến giao diện người dùng để tăng khả năng truy cập LLM cục bộ cho các nhà nghiên cứu khác, đồng thời lên kế hoạch dùng NVIDIA AI Blueprint để phân tích dữ liệu đa phương thức từ PDF, xác định bài báo phù hợp nhất cho từng câu hỏi.
Họ cũng dự định sắp xếp thông tin trích xuất và tạo hình ảnh trực quan như bản đồ vị trí thí nghiệm để hỗ trợ viết bài đánh giá nhanh hơn. Kết quả tại Codefest cho thấy tiềm năng của AI trong việc cải thiện quy trình nghiên cứu, giúp phân tích tài liệu khoa học nhanh và toàn diện hơn. Nhóm đặt mục tiêu tiếp tục hoàn thiện phương pháp này để mở rộng ứng dụng cho nhiều chủ đề nghiên cứu khác trong tương lai.