NVIDIA vừa công bố kỷ lục hiệu năng mới trên các mô hình AI Mixture of Experts, đạt mức tăng trưởng gấp 10 lần nhờ hệ thống máy chủ GB200 Blackwell NVL72.
Trong bối cảnh ngành công nghiệp trí tuệ nhân tạo đang chạy đua mở rộng quy mô các mô hình ngôn ngữ lớn (LLM), việc gia tăng tham số và đảm bảo hiệu suất vận hành đang gặp phải những giới hạn về tài nguyên tính toán. Để giải quyết vấn đề này, các mô hình “Hỗn hợp chuyên gia” (Mixture of Experts – MoE) đã trở thành giải pháp tối ưu nhờ cơ chế chỉ kích hoạt một phần tham số cần thiết cho mỗi truy vấn thay vì toàn bộ hệ thống. Tuy nhiên, việc mở rộng quy mô MoE thường dẫn đến nút thắt cổ chai lớn về khả năng tính toán và truyền tải dữ liệu.
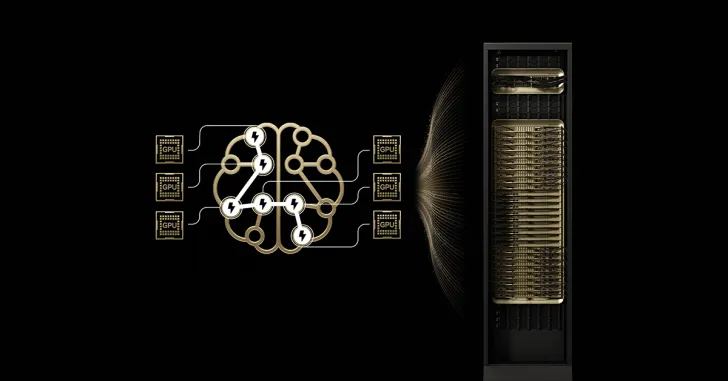
NVIDIA mới đây đã tuyên bố vượt qua rào cản này thông qua việc ứng dụng kiến trúc Blackwell thế hệ mới. Trong thông cáo báo chí, hãng xác nhận hệ thống máy chủ GB200 NVL72 đã đạt hiệu năng cao gấp 10 lần so với thế hệ Hopper HGX H200 tiền nhiệm. Thử nghiệm được thực hiện trên Kimi K2 Thinking, một mô hình LLM mã nguồn mở nổi bật trong phân khúc với 32 tỷ tham số được kích hoạt mỗi lần chuyển tiếp (forward pass).
Đột phá công nghệ đồng thiết kế và kiến trúc Blackwell
Để giải quyết các hạn chế khi mở rộng mô hình MoE, NVIDIA đã áp dụng phương pháp tiếp cận “đồng thiết kế” (co-design). Chiến lược này tận dụng cấu hình 72 chip của hệ thống GB200 kết hợp với bộ nhớ chia sẻ tốc độ cao lên tới 30TB. Kiến trúc này đưa khả năng song song hóa chuyên gia (expert parallelism) lên một tầm cao mới, đảm bảo các lô token (token batches) được phân chia và phân tán liên tục trên các GPU.

Phương pháp này giúp hệ thống xử lý hiệu quả khối lượng giao tiếp dữ liệu tăng theo tỷ lệ phi tuyến tính, vốn là điểm yếu của các kiến trúc cũ. NVIDIA khẳng định kiến trúc Blackwell đã sẵn sàng để khai thác tối đa sự bùng nổ của các mô hình MoE biên (frontier MoE models) hiện nay.
Tối ưu hóa toàn diện với khung phần mềm Dynamo
Bên cạnh phần cứng, các tối ưu hóa ngăn xếp toàn diện (full-stack optimizations) đóng vai trò then chốt trong việc mở khóa hiệu suất suy luận cao cho các mô hình MoE. Khung phần mềm NVIDIA Dynamo thực hiện việc điều phối phân tách quy trình phục vụ (disaggregated serving) bằng cách gán các tác vụ nạp tiền (prefill) và giải mã (decode) cho các GPU khác nhau. Cơ chế này cho phép quá trình giải mã vận hành với khả năng song song hóa chuyên gia quy mô lớn, trong khi quá trình nạp tiền sử dụng các kỹ thuật song song phù hợp hơn với đặc thù tải công việc của nó.

Ngoài ra, định dạng NVFP4 được sử dụng để duy trì độ chính xác của dữ liệu trong khi vẫn tăng cường hiệu suất và hiệu quả năng lượng. Thành tựu này được xem là bước tiến quan trọng đối với NVIDIA và các đối tác trong chuỗi cung ứng, đặc biệt khi các mô hình MoE ngày càng trở nên phổ biến nhờ tính hiệu quả trong tính toán và khả năng triển khai linh hoạt trên nhiều môi trường khác nhau.
Nguồn: wccftech