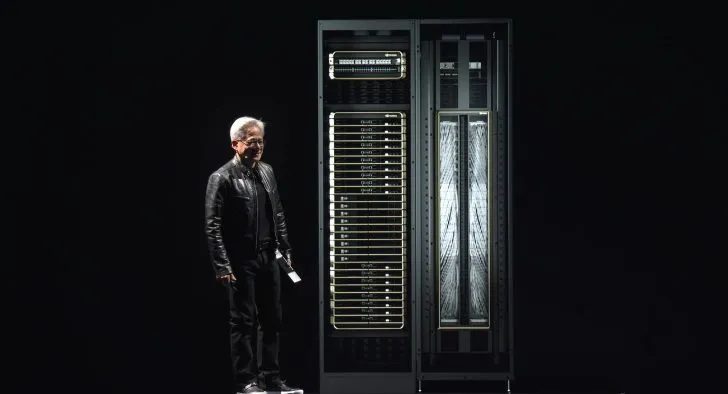
Hệ thống máy chủ Nvidia GB300 NVL72 ghi nhận hiệu suất tối ưu so với thế hệ GB200 khi xử lý các mô hình ngôn ngữ DeepSeek mã nguồn mở.
Tối ưu hóa khả năng xử lý ngữ cảnh dài trên hệ thống máy chủ
Nvidia đang dồn toàn lực vào việc cung cấp hiệu năng tối ưu cho các tác vụ đòi hỏi khả năng xử lý ngữ cảnh dài, nhằm mục tiêu chiếm lĩnh thị trường trong kỷ nguyên trí tuệ nhân tạo tác vụ (agentic AI). Theo các báo cáo kỹ thuật gần đây, kiến trúc Blackwell Ultra mang lại sự đột phá lớn với mức tăng thông lượng trên mỗi megawatt điện năng tiêu thụ lên tới 50 lần khi so sánh trực tiếp với các vi xử lý đồ họa thuộc kiến trúc Hopper. Điều này đạt được thông qua phương pháp thiết kế đồng bộ phần cứng và phần mềm cực hạn của hãng.

Mới đây, Tổ chức Hệ thống Mô hình Lớn (LMSYS) đã tiến hành các bài kiểm tra chuyên sâu đối với hệ thống máy chủ GB300 NVL72 cho các tác vụ suy luận ngữ cảnh dài trên nền tảng mã nguồn mở DeepSeek. Kết quả ban đầu cho thấy những tín hiệu khả quan. Quá trình thử nghiệm này bao gồm cả việc áp dụng các phương pháp định tuyến phần mềm ở cấp độ cơ sở hạ tầng. Do các khối lượng công việc xử lý ngữ cảnh dài thường tạo ra áp lực lớn lên dung lượng bộ nhớ video (VRAM) của vi xử lý đồ họa, đội ngũ chuyên gia tại LMSYS đã tích hợp cơ chế phân tách Prefill-Decode (PD Disaggregation).
Đây là một cơ chế kỹ thuật được sử dụng rộng rãi nhằm duy trì độ ổn định của hệ thống ngữ cảnh mã thông báo (token) ở quy mô lớn. Cơ chế phân tách PD sẽ tiến hành chia nhỏ khối lượng công việc và phân bổ qua nhiều nút phần cứng khác nhau nhằm mục đích loại bỏ hoàn toàn tình trạng nghẽn cổ chai dữ liệu. Giai đoạn tiền xử lý (prefill) dữ liệu đầu vào, cùng với giai đoạn giải mã (decode) dùng để tạo ra các mã thông báo, đều được vận hành mượt mà thông qua sự phân tách này.
Kết quả cuối cùng là hệ thống đạt được sự cải thiện tỷ lệ thông lượng tổng thể khi hoạt động ở quy mô lớn. Nhóm nghiên cứu LMSYS cũng triển khai hàng loạt kỹ thuật tối ưu hóa chuyên sâu khác, điển hình như phương pháp phân chia dữ liệu động nhằm nâng cao tốc độ phản hồi câu lệnh trong các cửa sổ ngữ cảnh dài, kết hợp với kỹ thuật chuyển đổi dung lượng bộ nhớ đệm khóa-giá trị một cách hiệu quả.
Khoảng cách hiệu năng và bài toán chi phí đầu tư hạ tầng
Khi tiến hành đánh giá những bước tiến về hiệu năng giữa các thế hệ phần cứng, nhóm nghiên cứu đã ghi nhận các kết quả chuẩn phân tích thông lượng, dung lượng và tỷ lệ độ trễ. Sự chênh lệch sức mạnh giữa hai hệ thống máy chủ Nvidia GB300 NVL72 và GB200 NVL72 được thể hiện qua các thông số kỹ thuật cụ thể. Thông lượng tối đa của thế hệ mới đạt mức 226,2 mã thông báo mỗi giây trên một vi xử lý đồ họa (TPS/GPU), tương đương mức tăng 1,53 lần.

Tốc độ phản hồi tới người dùng cuối cũng ghi nhận sự nâng cấp mạnh mẽ với mức tăng 1,87 lần thông qua công nghệ dự đoán đa mã thông báo. Đồng thời, hệ thống đạt tỷ lệ chiến thắng về độ trễ là 1,58 lần. Theo phân tích từ LMSYS, máy chủ GB300 trung bình duy trì khoảng cách dẫn trước từ 1,4 đến 1,5 lần so với thiết bị tiền nhiệm GB200, đặc biệt phát huy tác dụng trong các kịch bản vận hành nhạy cảm với độ trễ. Dựa trên định hướng khai thác các khối lượng công việc AI tác vụ, kiến trúc Blackwell Ultra hiện là nền tảng phần cứng chiếm ưu thế cao nhất để gia tăng hiệu suất.
Dù các thiết bị Blackwell Ultra đang chứng tỏ sự thống trị tuyệt đối về thông số độ trễ và thông lượng xử lý, giới chuyên gia trong ngành công nghiệp máy chủ vẫn chưa đưa ra các thảo luận chi tiết về số liệu tổng chi phí sở hữu (TCO). Điều này xuất phát từ thực tế là chi phí triển khai cho hệ thống GB300 đã gia tăng tỷ lệ thuận với sức mạnh tính toán. Cách tiếp cận của Nvidia qua từng thế hệ sản phẩm cho thấy hãng tập trung song song vào việc nâng cấp cấu trúc phần cứng và nỗ lực giải quyết các điểm nghẽn đặc thù của ngành công nghiệp.
Đối với dòng sản phẩm Blackwell Ultra, các chỉ số đo lường độ trễ đã ghi nhận sự cải thiện đáng kể. Đây là nguyên nhân cốt lõi khiến GB300 đang nổi lên như một sự lựa chọn ưu tiên hàng đầu dành cho các nhà cung cấp dịch vụ đám mây quy mô siêu lớn cũng như các nền tảng điện toán đám mây thế hệ mới khi vận hành AI tác vụ.
Nguồn: wccftech