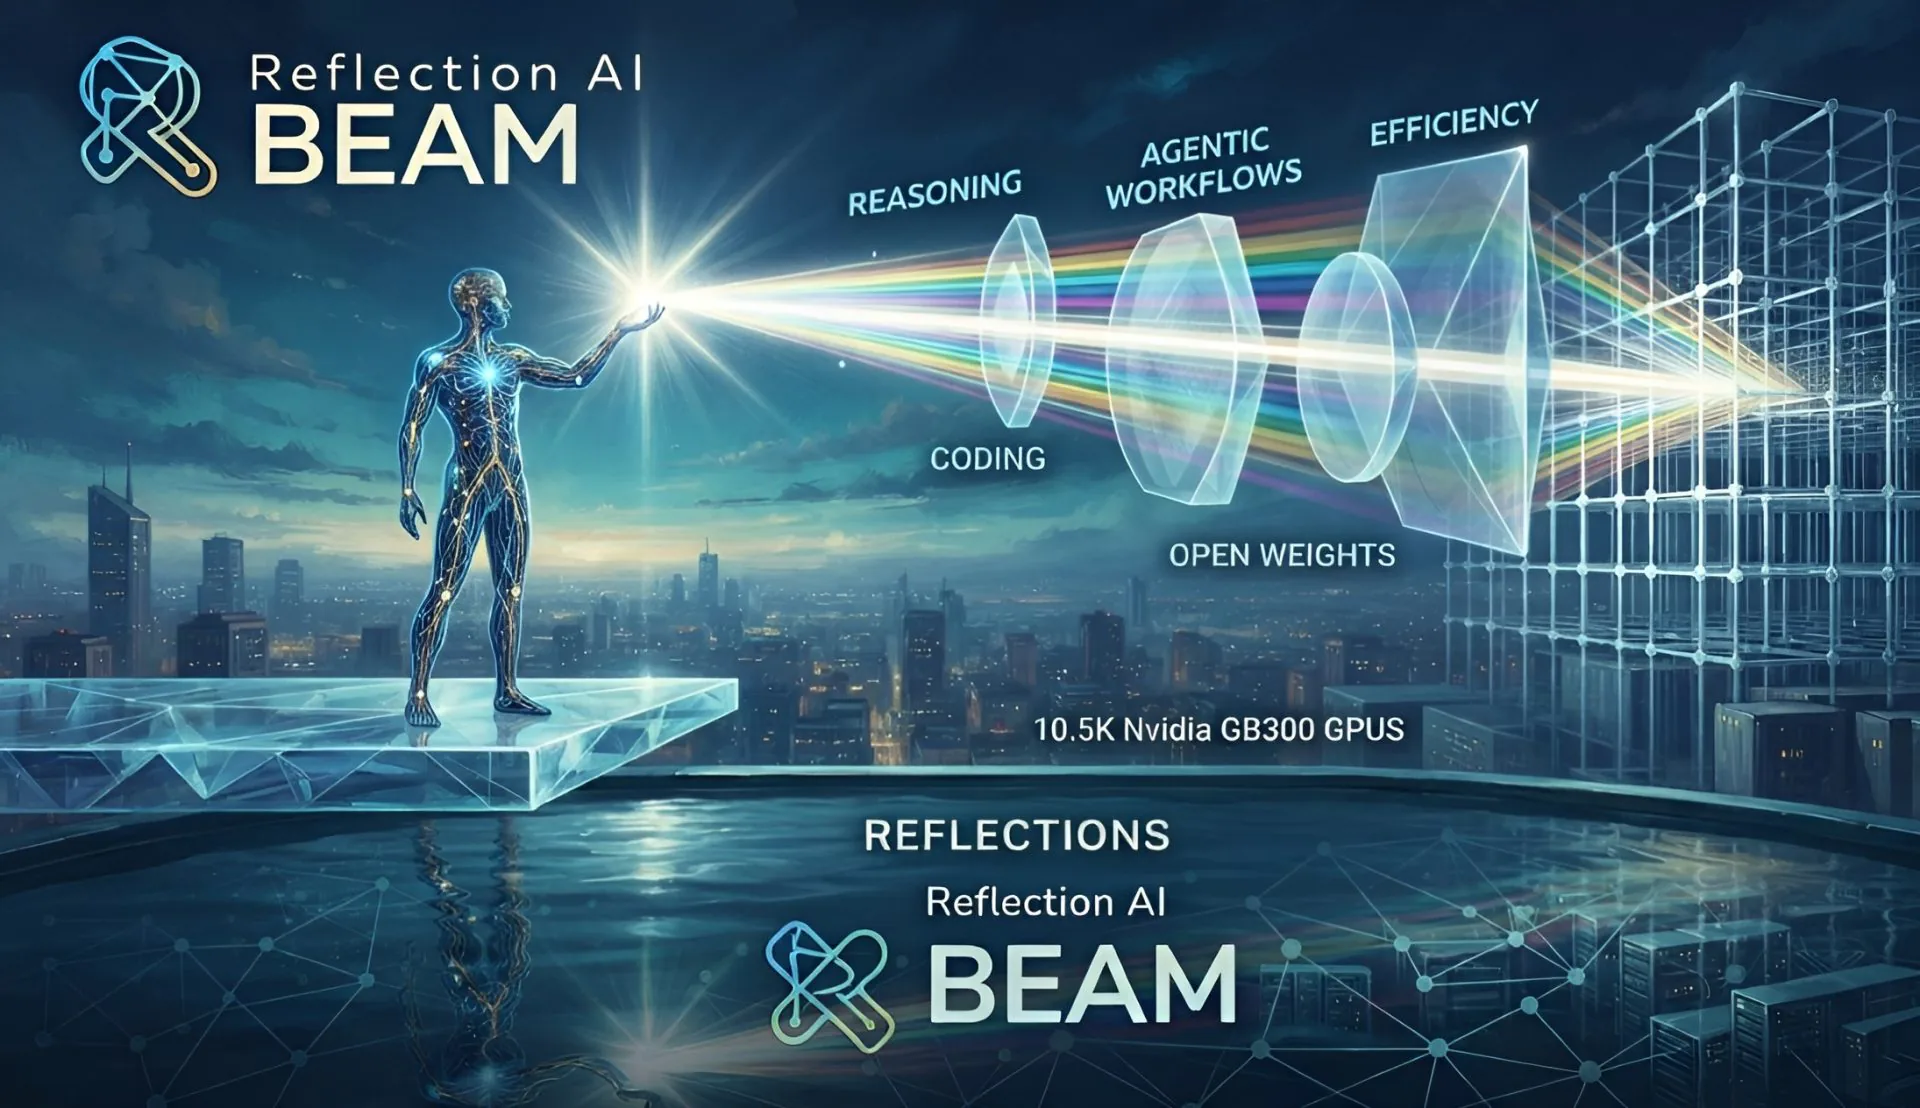
Các phòng thí nghiệm AI phương Tây cuối cùng đã bắt đầu cạnh tranh sòng phẳng với DeepSeek và Zhipu (Z.ai) của Trung Quốc trong mảng mô hình nguồn mở tối ưu hiệu năng. Điển hình nhất chính là Beam của Reflection – một mô hình AI thiết kế theo cấu trúc Mixture of Experts (MoE) thưa thớt, sở hữu 501 tỷ tham số với mức độ hiệu quả vượt mức tưởng tượng.
Reflection tuyên bố Beam “đạt hiệu suất cao hơn từ 3 đến 4 lần so với GLM 5.2 và hơn 4 lần so với các mô hình nguồn mở hàng đầu của phương Tây hiện nay”.

Cơ chế hoạt động tối ưu của cấu trúc MoE
Về mặt thông số, dù Beam sở hữu tới 501 tỷ tham số, nhưng chỉ có 23 tỷ tham số được kích hoạt tại bất kỳ thời điểm nào. Để dễ hiểu về cấu trúc MoE, hãy tưởng tượng một nhà bếp khổng lồ với nhiều đầu bếp chuyên biệt (các “chuyên gia”). Mô hình sẽ chỉ gọi các đầu bếp phù hợp khi có yêu cầu. Ví dụ, để làm bánh soufflé, nó chỉ huy động các chuyên gia làm đồ tráng miệng thay vì gọi những đầu bếp chuyên món Á.
Về cơ bản, một mô hình AI bao gồm một chuỗi các khối transformer được cấu thành từ hai yếu tố chính:
-
Attention Layer: Phân tích sự liên kết giữa các từ trong câu. Ví dụ, với câu “Paris là thủ đô của Pháp”, lớp này sẽ liên kết “thủ đô” với “Pháp” và xác định “Paris” là câu trả lời. Lớp này lưu trữ các liên kết dưới dạng bộ nhớ đệm KV (KV cache). Ngữ cảnh xử lý càng dài, dung lượng KV cache càng lớn.
-
Feed-Forward Network – FFN: Nơi lưu trữ toàn bộ kiến thức của mô hình dưới dạng các trọng số (weights). Lớp này sử dụng các công thức toán học chuyên sâu để khai phá ý nghĩa phía sau mỗi từ.

Tuy nhiên, để ngăn tình trạng bộ nhớ KV cache phình to và tăng hiệu năng, Beam đã áp dụng hàng loạt kỹ thuật đột phá:
-
Uniform expert utilization: Khối lượng công việc được chia đều cho tất cả các “chuyên gia”, đảm bảo không có cụm nào bị quá tải hay “ngồi chơi”. Theo Reflection, chuyên gia bận rộn nhất của Beam chỉ hoạt động nhiều hơn 1,04 lần so với mức trung bình – một tỷ lệ phân bổ gần như hoàn hảo.
-
Depth-based residual scaling: Khi dữ liệu đi qua hàng chục lớp xử lý liên tiếp, việc cộng dồn toán học dễ gây ra các giá trị ngoại lai, làm méo tín hiệu. Beam khắc phục bằng cách sử dụng các hệ số tỷ lệ để giảm dần biên độ đầu ra ở các lớp con, giúp thông tin di chuyển qua mạng lưới một cách “sạch” và ổn định.
-
SandwichNorm: Thay vì chỉ chuẩn hóa dữ liệu đầu vào hoặc đầu ra, Beam thực hiện chuẩn hóa ở cả hai điểm (giống như hai lớp bánh kẹp). Nhờ đó, các giá trị kích hoạt bên trong luôn được duy trì trong biên độ an toàn, không tạo ra các sai lệch toán học cực đoan.
-
Attention gating: Đóng vai trò như một “nút chỉnh âm lượng” phần mềm, quyết định mức độ sử dụng thực tế của kết quả attention, giúp mô hình chọn lọc thông tin tốt và duy trì độ ổn định.
-
FP32 residual accumulation: Mặc dù xử lý phần lớn công việc bằng các phép tính độ chính xác thấp để tiết kiệm tài nguyên, các phép cộng thặng dư quan trọng vẫn được giữ ở định dạng số nguyên 32-bit (FP32). Điều này ngăn chặn tình trạng tích tụ sai số làm tròn vốn có thể gây hỏng quá trình huấn luyện.
Huấn luyện quy mô khổng lồ: 10.500 GPU GB300
Sau giai đoạn tiền huấn luyện (pre-train), Beam trải qua quá trình Học tăng cường (Reinforcement Learning – RL). Mô hình được đưa vào các môi trường giả lập riêng biệt (sandbox) để rèn luyện kỹ năng thực tế như viết mã lập trình.
Đội ngũ Reflection chia sẻ: “Chúng tôi huấn luyện Beam với cơ chế phạt độ dài có kiểm soát, nhằm thưởng cho các cách giải quyết thành công và hạn chế việc sinh ra token thừa. Ban đầu, hiệu suất tăng lên ngay cả khi câu trả lời ngắn đi do mô hình biết cách giải quyết với ít bước suy luận hơn. Sau này, khi khả năng tự chủ mạnh hơn, câu trả lời dài trở lại nhưng tập trung vào việc gia tăng tối đa hiệu suất tính toán.”
Đáng chú ý, quá trình huấn luyện Beam diễn ra trong 4 tuần (28 ngày) bằng việc sử dụng hệ thống 10.500 siêu chip NVIDIA GB300 thế hệ mới, vận hành 1,3 tỷ sandbox (tương đương 46,4 triệu sandbox mỗi ngày). Quá trình RL trải rộng qua 1 triệu môi trường lập trình, hệ sinh thái STEM, với 100 triệu lượt thử nghiệm tương tác.
Để dễ so sánh, hệ thống DSec độc quyền của DeepSeek hiện xử lý khoảng 3 triệu sandbox. Nếu muốn đạt được quy mô ngang bằng Reflection, DeepSeek sẽ phải huy động khoảng 16 tổ hợp DSec (sử dụng 656 GPU GB300 cho mỗi tổ hợp).
Tách rời quy trình cập nhật
Trong Học tăng cường truyền thống, hệ thống thường phải tạm dừng để cập nhật trọng số. Để rút ngắn thời gian, Reflection đã tách rời hoàn toàn quy trình này:
-
Rollout Workers: Liên tục đưa ra các phản hồi nội dung.
-
Learner Engines: Liên tục cập nhật trọng số mô hình bằng các phản hồi đó mà không cần dừng hệ thống.
Mặc dù việc cập nhật dữ liệu lệch pha dễ gây ra độ trễ chính sách (policy staleness) và sai lệch số học, Beam đã hóa giải vấn đề bằng bộ ba kỹ thuật cốt lõi: SandwichNorm, Cổng chú ý và Mở rộng chuỗi thặng dư theo độ sâu. Những tinh chỉnh này giúp tốc độ học của Beam tăng tốc một cách đáng kinh ngạc.
Kết quả là, hiệu suất của Beam gần như ngang ngửa với GLM-5.2 nhưng mức tiêu hao tài nguyên điện toán chỉ bằng 1/3 đến 1/4. Mặc dù vẫn đứng sau Qwen 3.8 Max, Beam hiện là một trong những mô hình ngôn ngữ lớn sở hữu sức mạnh nội tại cực kỳ ấn tượng so với mức dung lượng thực tế.
Các phòng thí nghiệm AI phương Tây cuối cùng đã bắt đầu cạnh tranh sòng phẳng với DeepSeek và Zhipu (Z.ai) của Trung Quốc trong mảng mô hình nguồn mở (open-weight) tối ưu hiệu năng. Điển hình nhất chính là Beam của Reflection – một mô hình AI thiết kế theo cấu trúc Mixture of Experts (MoE) thưa thớt, sở hữu 501 tỷ tham số với mức độ hiệu quả vượt mức tưởng tượng.
Reflection tuyên bố Beam “đạt hiệu suất cao hơn từ 3 đến 4 lần so với GLM 5.2 và hơn 4 lần so với các mô hình nguồn mở hàng đầu của phương Tây hiện nay”.
Cơ chế hoạt động tối ưu của cấu trúc MoE
Về mặt thông số, dù Beam sở hữu tới 501 tỷ tham số, nhưng chỉ có 23 tỷ tham số được kích hoạt tại bất kỳ thời điểm nào. Để dễ hiểu về cấu trúc MoE, hãy tưởng tượng một nhà bếp khổng lồ với nhiều đầu bếp chuyên biệt (các “chuyên gia”). Mô hình sẽ chỉ gọi các đầu bếp phù hợp khi có yêu cầu. Ví dụ, để làm bánh soufflé, nó chỉ huy động các chuyên gia làm đồ tráng miệng thay vì gọi những đầu bếp chuyên món Á.
Về cơ bản, một mô hình AI bao gồm một chuỗi các khối transformer được cấu thành từ hai yếu tố chính:
-
Attention Layer: Phân tích sự liên kết giữa các từ trong câu. Ví dụ, với câu “Paris là thủ đô của Pháp”, lớp này sẽ liên kết “thủ đô” với “Pháp” và xác định “Paris” là câu trả lời. Lớp này lưu trữ các liên kết dưới dạng bộ nhớ đệm KV (KV cache). Ngữ cảnh xử lý càng dài, dung lượng KV cache càng lớn.
-
Feed-Forward Network – FFN: Nơi lưu trữ toàn bộ kiến thức của mô hình dưới dạng các trọng số (weights). Lớp này sử dụng các công thức toán học chuyên sâu để khai phá ý nghĩa phía sau mỗi từ.
Tuy nhiên, để ngăn tình trạng bộ nhớ KV cache phình to và tăng hiệu năng, Beam đã áp dụng hàng loạt kỹ thuật đột phá:
-
Uniform expert utilization: Khối lượng công việc được chia đều cho tất cả các “chuyên gia”, đảm bảo không có cụm nào bị quá tải hay “ngồi chơi”. Theo Reflection, chuyên gia bận rộn nhất của Beam chỉ hoạt động nhiều hơn 1,04 lần so với mức trung bình – một tỷ lệ phân bổ gần như hoàn hảo.
-
Depth-based residual scaling: Khi dữ liệu đi qua hàng chục lớp xử lý liên tiếp, việc cộng dồn toán học dễ gây ra các giá trị ngoại lai, làm méo tín hiệu. Beam khắc phục bằng cách sử dụng các hệ số tỷ lệ để giảm dần biên độ đầu ra ở các lớp con, giúp thông tin di chuyển qua mạng lưới một cách “sạch” và ổn định.
-
SandwichNorm: Thay vì chỉ chuẩn hóa dữ liệu đầu vào hoặc đầu ra, Beam thực hiện chuẩn hóa ở cả hai điểm (giống như hai lớp bánh kẹp). Nhờ đó, các giá trị kích hoạt bên trong luôn được duy trì trong biên độ an toàn, không tạo ra các sai lệch toán học cực đoan.
-
Attention gating: Đóng vai trò như một “nút chỉnh âm lượng” phần mềm, quyết định mức độ sử dụng thực tế của kết quả attention, giúp mô hình chọn lọc thông tin tốt và duy trì độ ổn định.
-
FP32 residual accumulation: Mặc dù xử lý phần lớn công việc bằng các phép tính độ chính xác thấp để tiết kiệm tài nguyên, các phép cộng thặng dư quan trọng vẫn được giữ ở định dạng số nguyên 32-bit (FP32). Điều này ngăn chặn tình trạng tích tụ sai số làm tròn vốn có thể gây hỏng quá trình huấn luyện.
Huấn luyện quy mô khổng lồ: 10.500 GPU GB300
Sau giai đoạn tiền huấn luyện (pre-train), Beam trải qua quá trình Học tăng cường (Reinforcement Learning – RL). Mô hình được đưa vào các môi trường giả lập riêng biệt (sandbox) để rèn luyện kỹ năng thực tế như viết mã lập trình.
Đội ngũ Reflection chia sẻ: “Chúng tôi huấn luyện Beam với cơ chế phạt độ dài có kiểm soát, nhằm thưởng cho các cách giải quyết thành công và hạn chế việc sinh ra token thừa. Ban đầu, hiệu suất tăng lên ngay cả khi câu trả lời ngắn đi do mô hình biết cách giải quyết với ít bước suy luận hơn. Sau này, khi khả năng tự chủ mạnh hơn, câu trả lời dài trở lại nhưng tập trung vào việc gia tăng tối đa hiệu suất tính toán.”
Đáng chú ý, quá trình huấn luyện Beam diễn ra trong 4 tuần bằng việc sử dụng hệ thống 10.500 siêu chip NVIDIA GB300 thế hệ mới, vận hành 1,3 tỷ sandbox (tương đương 46,4 triệu sandbox mỗi ngày). Quá trình RL trải rộng qua 1 triệu môi trường lập trình, hệ sinh thái STEM, với 100 triệu lượt thử nghiệm tương tác.
Để dễ so sánh, hệ thống DSec độc quyền của DeepSeek hiện xử lý khoảng 3 triệu sandbox. Nếu muốn đạt được quy mô ngang bằng Reflection, DeepSeek sẽ phải huy động khoảng 16 tổ hợp DSec (sử dụng 656 GPU GB300 cho mỗi tổ hợp).
Tách rời quy trình cập nhật
Trong Học tăng cường truyền thống, hệ thống thường phải tạm dừng để cập nhật trọng số. Để rút ngắn thời gian, Reflection đã tách rời hoàn toàn quy trình này:
-
Rollout Workers: Liên tục đưa ra các phản hồi nội dung.
-
Learner Engines: Liên tục cập nhật trọng số mô hình bằng các phản hồi đó mà không cần dừng hệ thống.
Mặc dù việc cập nhật dữ liệu lệch pha dễ gây ra độ trễ và sai lệch số học, Beam đã hóa giải vấn đề bằng bộ ba kỹ thuật cốt lõi: SandwichNorm, Cổng chú ý và Mở rộng chuỗi thặng dư theo độ sâu. Những tinh chỉnh này giúp tốc độ học của Beam tăng tốc một cách đáng kinh ngạc.
Kết quả là, hiệu suất của Beam gần như ngang ngửa với GLM-5.2 nhưng mức tiêu hao tài nguyên điện toán chỉ bằng 1/3 đến 1/4. Mặc dù vẫn đứng sau Qwen 3.8 Max, Beam hiện là một trong những mô hình ngôn ngữ lớn sở hữu sức mạnh nội tại cực kỳ ấn tượng so với mức dung lượng thực tế.
Nguồn: wccftech