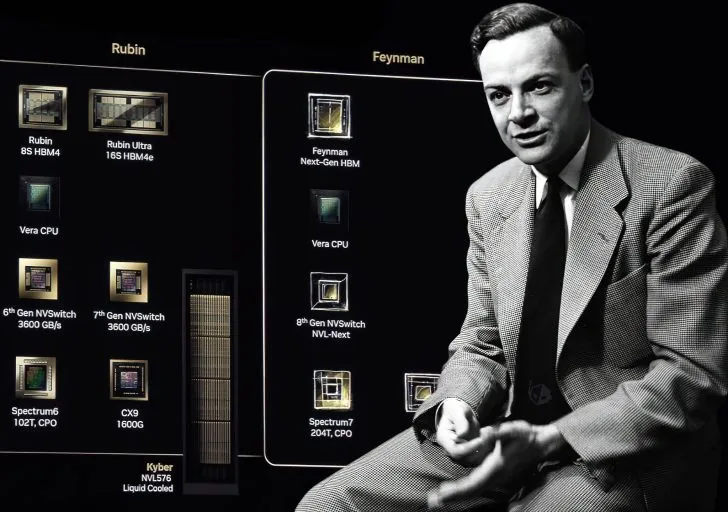
NVIDIA dự kiến tích hợp các đơn vị LPU vào kiến trúc GPU Feynman thế hệ mới thông qua công nghệ xếp chồng chip, nhằm thống trị mảng suy luận AI.
Thỏa thuận cấp phép sở hữu trí tuệ giữa NVIDIA và Groq liên quan đến các đơn vị xử lý ngôn ngữ (LPU) đang mở ra hướng đi chiến lược mới cho “Đội Xanh” trong cuộc đua phần cứng AI. Mặc dù các con số doanh thu ban đầu có thể chưa phản ánh hết quy mô, mục tiêu thực sự của NVIDIA là dẫn đầu phân khúc suy luận (inference) thông qua việc ứng dụng LPU vào các dòng sản phẩm tương lai.
Theo phân tích từ chuyên gia GPU AGF, kiến trúc GPU thế hệ tiếp theo mang tên Feynman, dự kiến ra mắt khoảng năm 2028, có thể sẽ tích hợp các đơn vị LPU trực tiếp lên chip thông qua công nghệ liên kết lai (hybrid bonding) của TSMC. Phương pháp này có nhiều điểm tương đồng với kỹ thuật mà AMD đã triển khai thành công trên các dòng CPU X3D.
Ứng dụng công nghệ xếp chồng chip lai
Các chuyên gia nhận định rằng việc triển khai LPU trên GPU Feynman sẽ tận dụng công nghệ đóng gói SoIC của TSMC để xếp chồng các lớp bộ nhớ lên khuôn xử lý chính. Giải pháp này giải quyết bài toán nan giải về giới hạn vật lý của bộ nhớ SRAM. Việc tích hợp SRAM dưới dạng một khuôn đơn khối (monolithic) trên các tiến trình sản xuất tiên tiến (như A16 hay 1.6nm) được xem là không hiệu quả về mặt kinh tế, do khả năng thu nhỏ kích thước của SRAM rất hạn chế.
Việc cố gắng sản xuất SRAM trên các nút quy trình cao cấp sẽ dẫn đến lãng phí diện tích silicon đắt đỏ và làm tăng chi phí sản xuất trên mỗi tấm wafer. Thay vào đó, NVIDIA sẽ sử dụng tiến trình A16 cho khuôn tính toán chính (chứa các đơn vị tensor và logic điều khiển), trong khi các đơn vị LPU chứa các khối SRAM lớn sẽ nằm trên các khuôn riêng biệt được xếp chồng lên.

Công nghệ liên kết lai của TSMC đóng vai trò then chốt trong thiết kế này, cho phép tạo ra giao diện kết nối rộng với mức tiêu thụ năng lượng thấp hơn nhiều so với bộ nhớ ngoài. Đặc biệt, do tiến trình A16 hỗ trợ công nghệ cấp điện mặt sau (backside power delivery), mặt trước của chip sẽ được giải phóng để dành riêng cho các kết nối SRAM theo chiều dọc, đảm bảo độ trễ giải mã cực thấp.
Thách thức về nhiệt độ và tương thích phần mềm
Mặc dù hứa hẹn hiệu năng vượt trội, kỹ thuật này đặt ra những thách thức lớn về quản lý nhiệt độ. Việc xếp chồng các khuôn chip hoạt động ở mật độ tính toán cao sẽ tạo ra lượng nhiệt lớn, và đặc tính thông lượng duy trì liên tục của LPU có thể gây ra các điểm nghẽn hệ thống.

Bên cạnh đó, sự khác biệt trong cơ chế thực thi giữa GPU truyền thống và LPU cũng là một rào cản kỹ thuật. LPU tập trung vào thứ tự thực thi cố định (tính xác định), trong khi GPU thường ưu tiên tính linh hoạt. Điều này tạo ra xung đột tiềm tàng giữa tính tất định và khả năng tùy biến. Vấn đề càng trở nên phức tạp hơn ở khía cạnh phần mềm, đặc biệt là với nền tảng CUDA. Trong khi CUDA được thiết kế dựa trên sự trừu tượng hóa phần cứng, mô hình thực thi kiểu LPU lại yêu cầu việc sắp xếp bộ nhớ một cách tường minh.
Việc dung hòa hai cơ chế này đòi hỏi NVIDIA phải thực hiện những tối ưu hóa kỹ thuật sâu rộng để đảm bảo môi trường LPU-GPU hoạt động trơn tru. Tuy nhiên, đây được xem là cái giá cần thiết để NVIDIA hiện thực hóa tham vọng thống trị thị trường suy luận AI trong thập kỷ tới.
Nguồn: wccftech